クラスターキー
クラスターキーはデータを自動的に整理し、大規模テーブルのクエリ性能を大幅に向上させます。TiDB Cloud Lake はバックグラウンドですべてのクラスタリング操作をシームレスかつ継続的に管理するため、クラスターキーを定義するだけで、残りは TiDB Cloud Lake が処理します。
どのような問題を解決するのか
適切に整理されていない大規模テーブルは、性能面と管理面で大きな課題を引き起こします。
例: 数百万件の商品を持つ EC テーブルを考えます。クラスタリングがない場合、WHERE category IN ('Electronics', 'Computers') のクエリでは、すべての商品カテゴリをスキャンする必要があります。category による自動クラスタリングを使用すると、TiDB Cloud Lake は Electronics と Computers の商品を継続的にまとめて配置するため、1000 以上のブロックではなく 2 つのブロックだけをスキャンすれば済みます。
自動クラスタリングの利点
管理のしやすさ: TiDB Cloud Lake により、次の作業が不要になります。
- クラスタリング済みテーブルの状態監視
- 再クラスタリング処理の手動実行
- クラスタリング用コンピュートリソースの割り当て
- メンテナンスウィンドウのスケジューリング
仕組み: クラスターキーを定義すると、TiDB Cloud Lake は自動的に次を実行します。
- DML 操作によるテーブル変更を監視する
- テーブルが再クラスタリングの恩恵を受けるタイミングを評価する
- バックグラウンドでクラスタリング最適化を実行する
- 最適なデータ配置を継続的に維持する
必要なのは、各テーブルに対して適切であればクラスタリングキーを定義することだけです。その後の管理はすべて TiDB Cloud Lake が自動的に行います。
仕組み
クラスターキーは、指定したカラムに基づいてデータをストレージブロック(Parquet ファイル)に整理します。
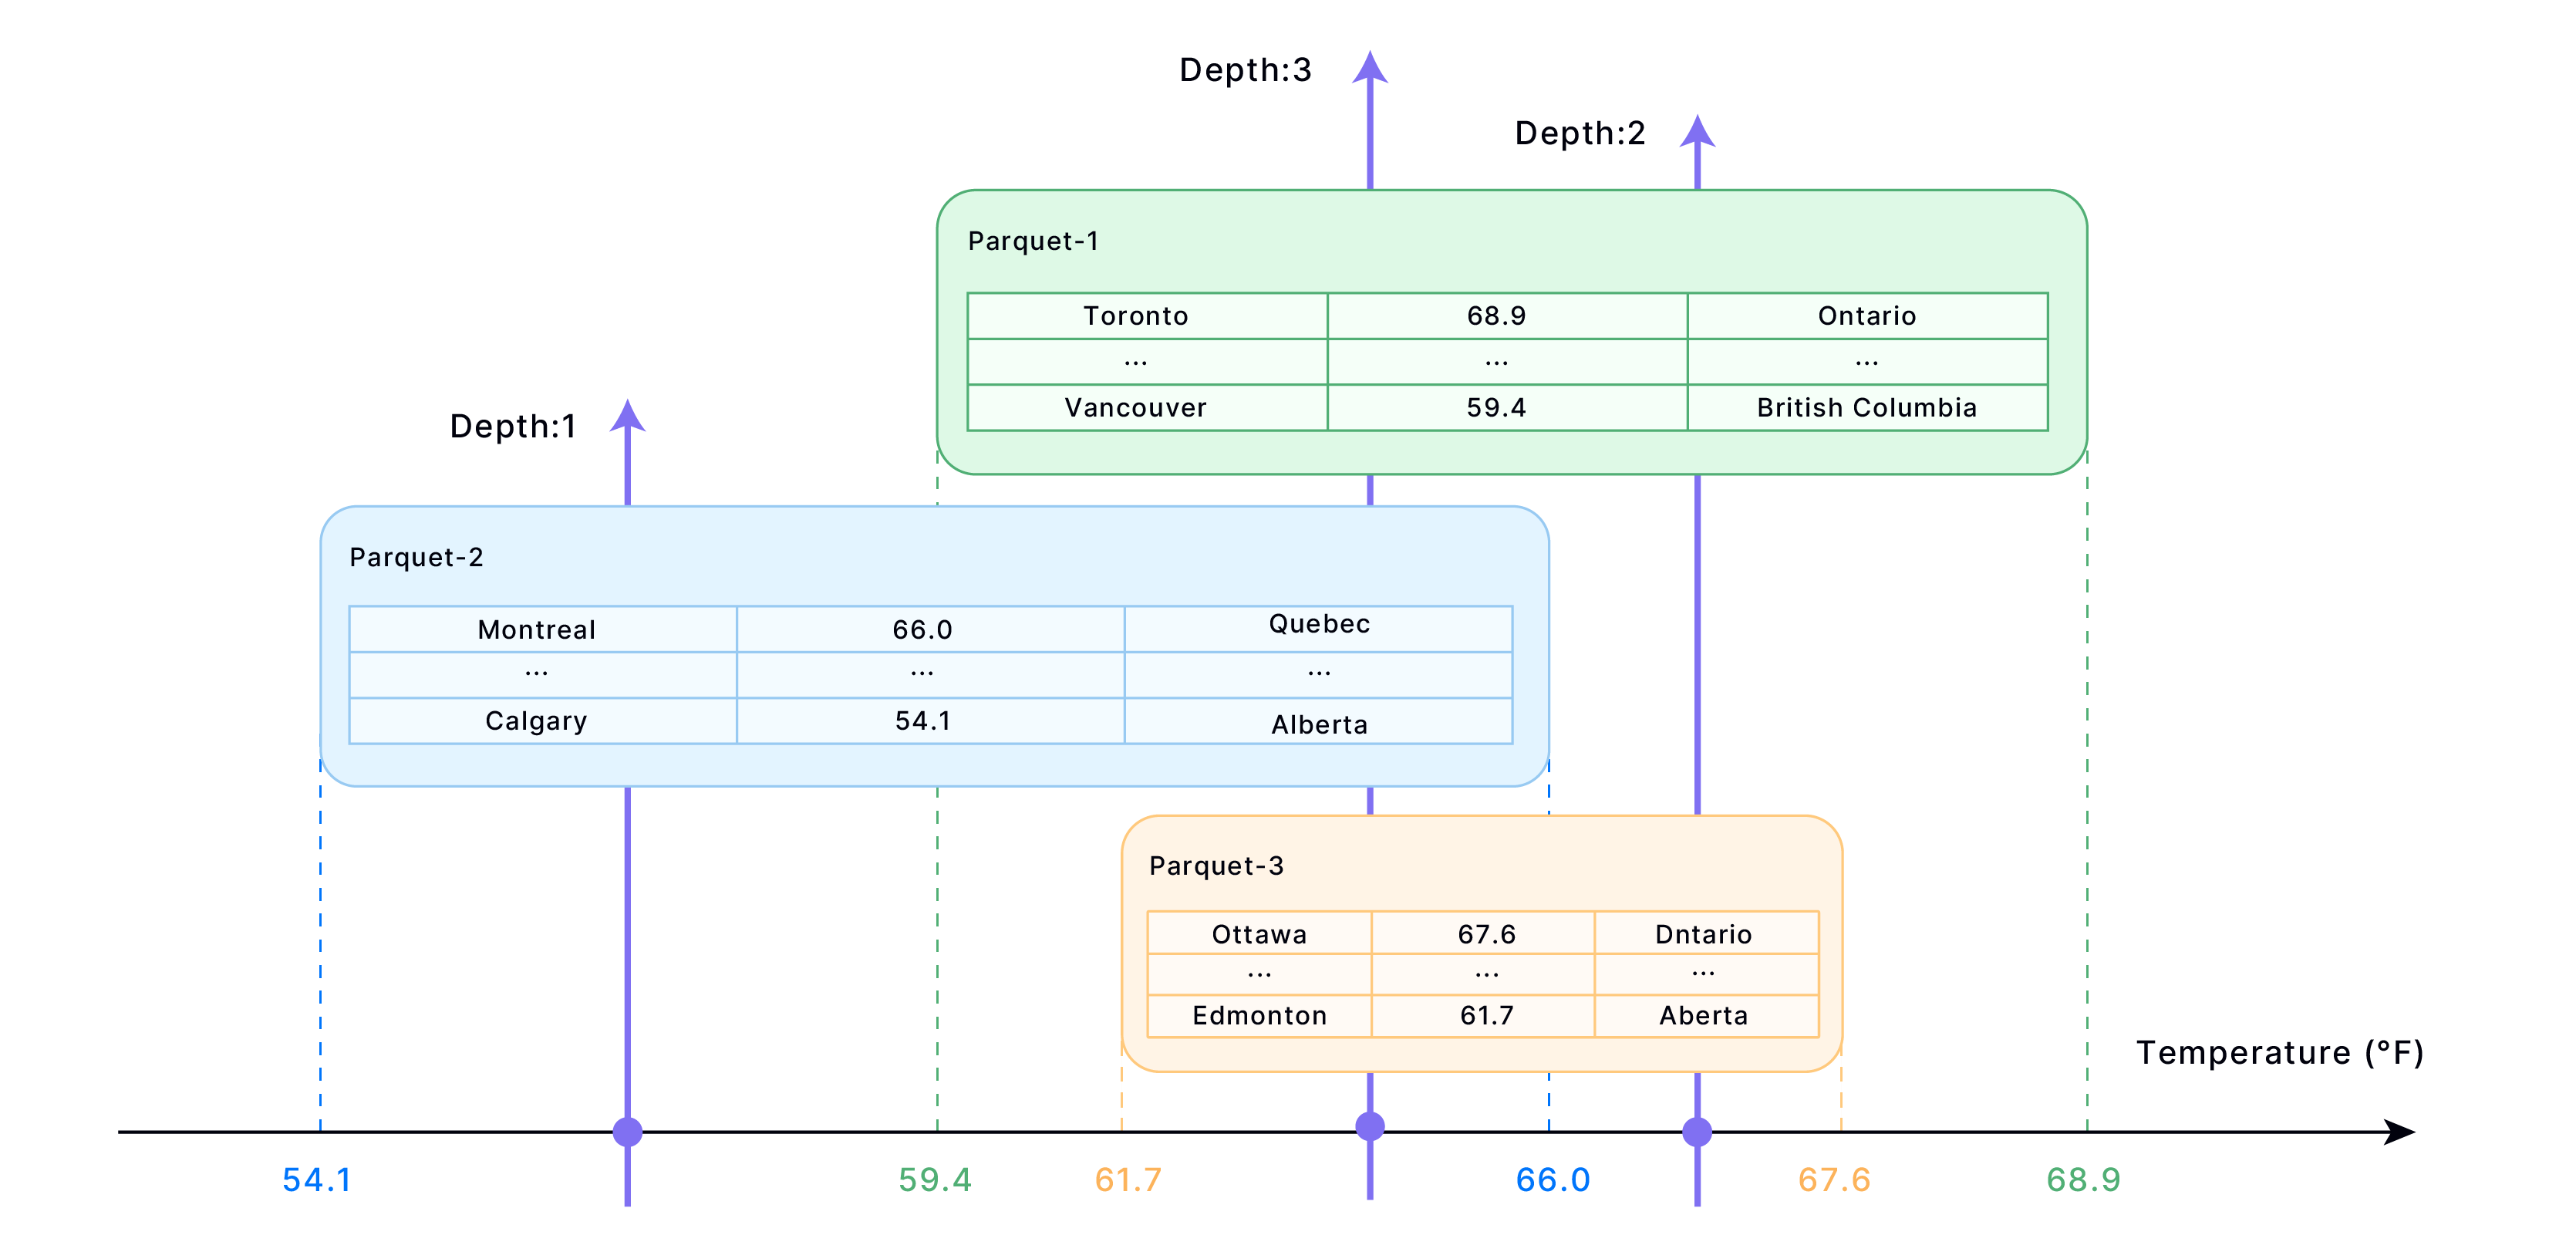
- データ整理 → 類似した値を隣接するブロックにまとめる
- メタデータ作成 → 高速検索のためにブロックと値の対応関係を保存する
- クエリ最適化 → クエリ時に関連するブロックのみを読み取る
- 性能向上 → スキャンする行数が減り、結果が速く返る
クイックセットアップ
-- Create table with cluster key
CREATE TABLE sales (
    order_id INT,
    order_date TIMESTAMP,
    region VARCHAR,
    amount DECIMAL
) CLUSTER BY (region);

-- Or add cluster key to existing table
ALTER TABLE sales CLUSTER BY (region, order_date);
適切なクラスターキーの選び方
最も一般的なクエリフィルターに基づいてカラムを選択します。
良いクラスターキーと悪いクラスターキー
性能の監視
-- Check clustering effectiveness
SELECT * FROM clustering_information('database_name', 'table_name');

-- Key metrics to watch:
-- average_depth: Lower is better (< 2 ideal)
-- average_overlaps: Lower is better
-- block_depth_histogram: More blocks at depth 1-2
再クラスタリングが必要なタイミング
データ変更により、テーブルは時間の経過とともに整理状態が崩れていきます。
-- Check if re-clustering is needed
SELECT IF(average_depth > 2 * LEAST(GREATEST(total_block_count * 0.001, 1), 16),
          'Re-cluster needed',
          'Clustering is good')
FROM clustering_information('your_database', 'your_table');

-- Re-cluster the table
ALTER TABLE your_table RECLUSTER;
性能チューニング
カスタムブロックサイズ
より良い性能のためにブロックサイズを調整します。
-- Smaller blocks = fewer rows per query
ALTER TABLE sales SET OPTIONS(
    ROW_PER_BLOCK = 100000,
    BLOCK_SIZE_THRESHOLD = 52428800
);
自動再クラスタリング
COPY INTOとREPLACE INTOは自動的に再クラスタリングをトリガーします- クラスタリングメトリクスを定期的に監視してください
average_depthが高くなりすぎたら再クラスタリングしてください
ベストプラクティス
重要な注意事項
クラスターキーを使うべき場合:
- 大規模テーブル(数百万行以上)
- クエリ性能が低い
- フィルターベースのクエリが多い
- 分析ワークロード
使うべきでない場合:
- 小規模テーブル
- ランダムアクセスパターン
- 頻繁に変化するデータ
クラスターキーは、予測可能なフィルターパターンを持ち、頻繁にクエリされる大規模テーブルで最も効果を発揮します。まずは最も一般的な WHERE 句のカラムから始めてください。