TiKVの主要モニタリング指標
TiUPを使用して TiDB クラスターをデプロイすると、監視システム (Prometheus/Grafana) も同時にデプロイされます。詳細については、モニタリングフレームワークの概要ご覧ください。
Grafanaダッシュボードは、概要、PD、TiDB、TiKV、Node_exporter、パフォーマンス概要など、複数のサブダッシュボードに分かれています。診断に役立つ多くのメトリクスが用意されています。
TiKV-Detailsダッシュボード
TiKVコンポーネントのステータス概要は、主要な指標が表示されるTiKV-Detailsダッシュボードで確認できます。
このセクションでは、TiKV-Detailsダッシュボード上のこれらの主要指標について詳しく説明します。
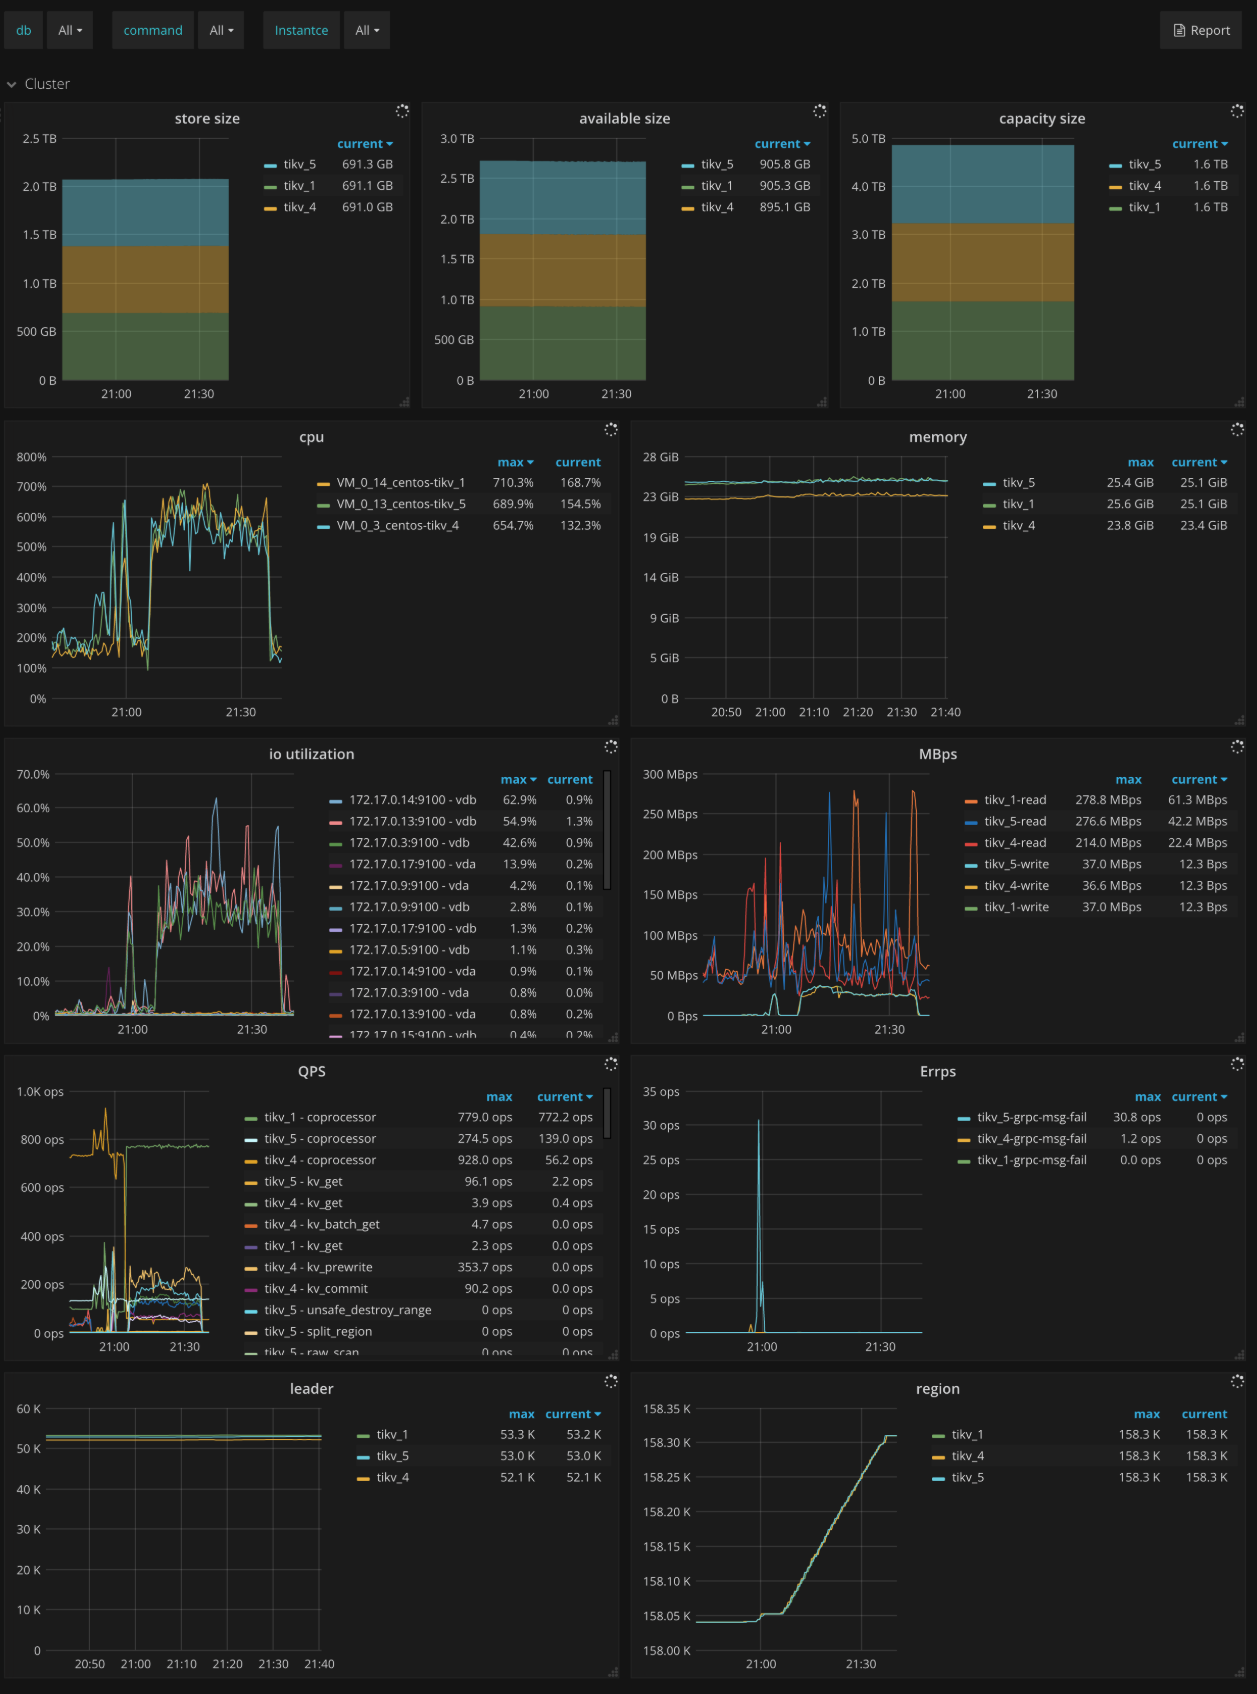
Cluster
- Store size:TiKVインスタンスごとのストレージサイズ
- Available size:TiKVインスタンスごとの利用可能な容量
- Capacity size:TiKVインスタンスごとの容量サイズ
- CPU: TiKVインスタンスごとのCPU使用率
- Memory:TiKVインスタンスごとのメモリ使用量
- IO utilization:TiKVインスタンスごとのI/O使用率
- MBps: 各TiKVインスタンスにおける読み取りと書き込みの合計バイト数
- QPS: 各TiKVインスタンスにおけるコマンドあたりのQPS
- Errps: gRPCメッセージの失敗率
- leader: TiKVインスタンスごとのリーダーの数
- Region:TiKVインスタンスあたりのリージョン数
- Uptime:前回の再起動以降のTiKVの実行時間
Errors
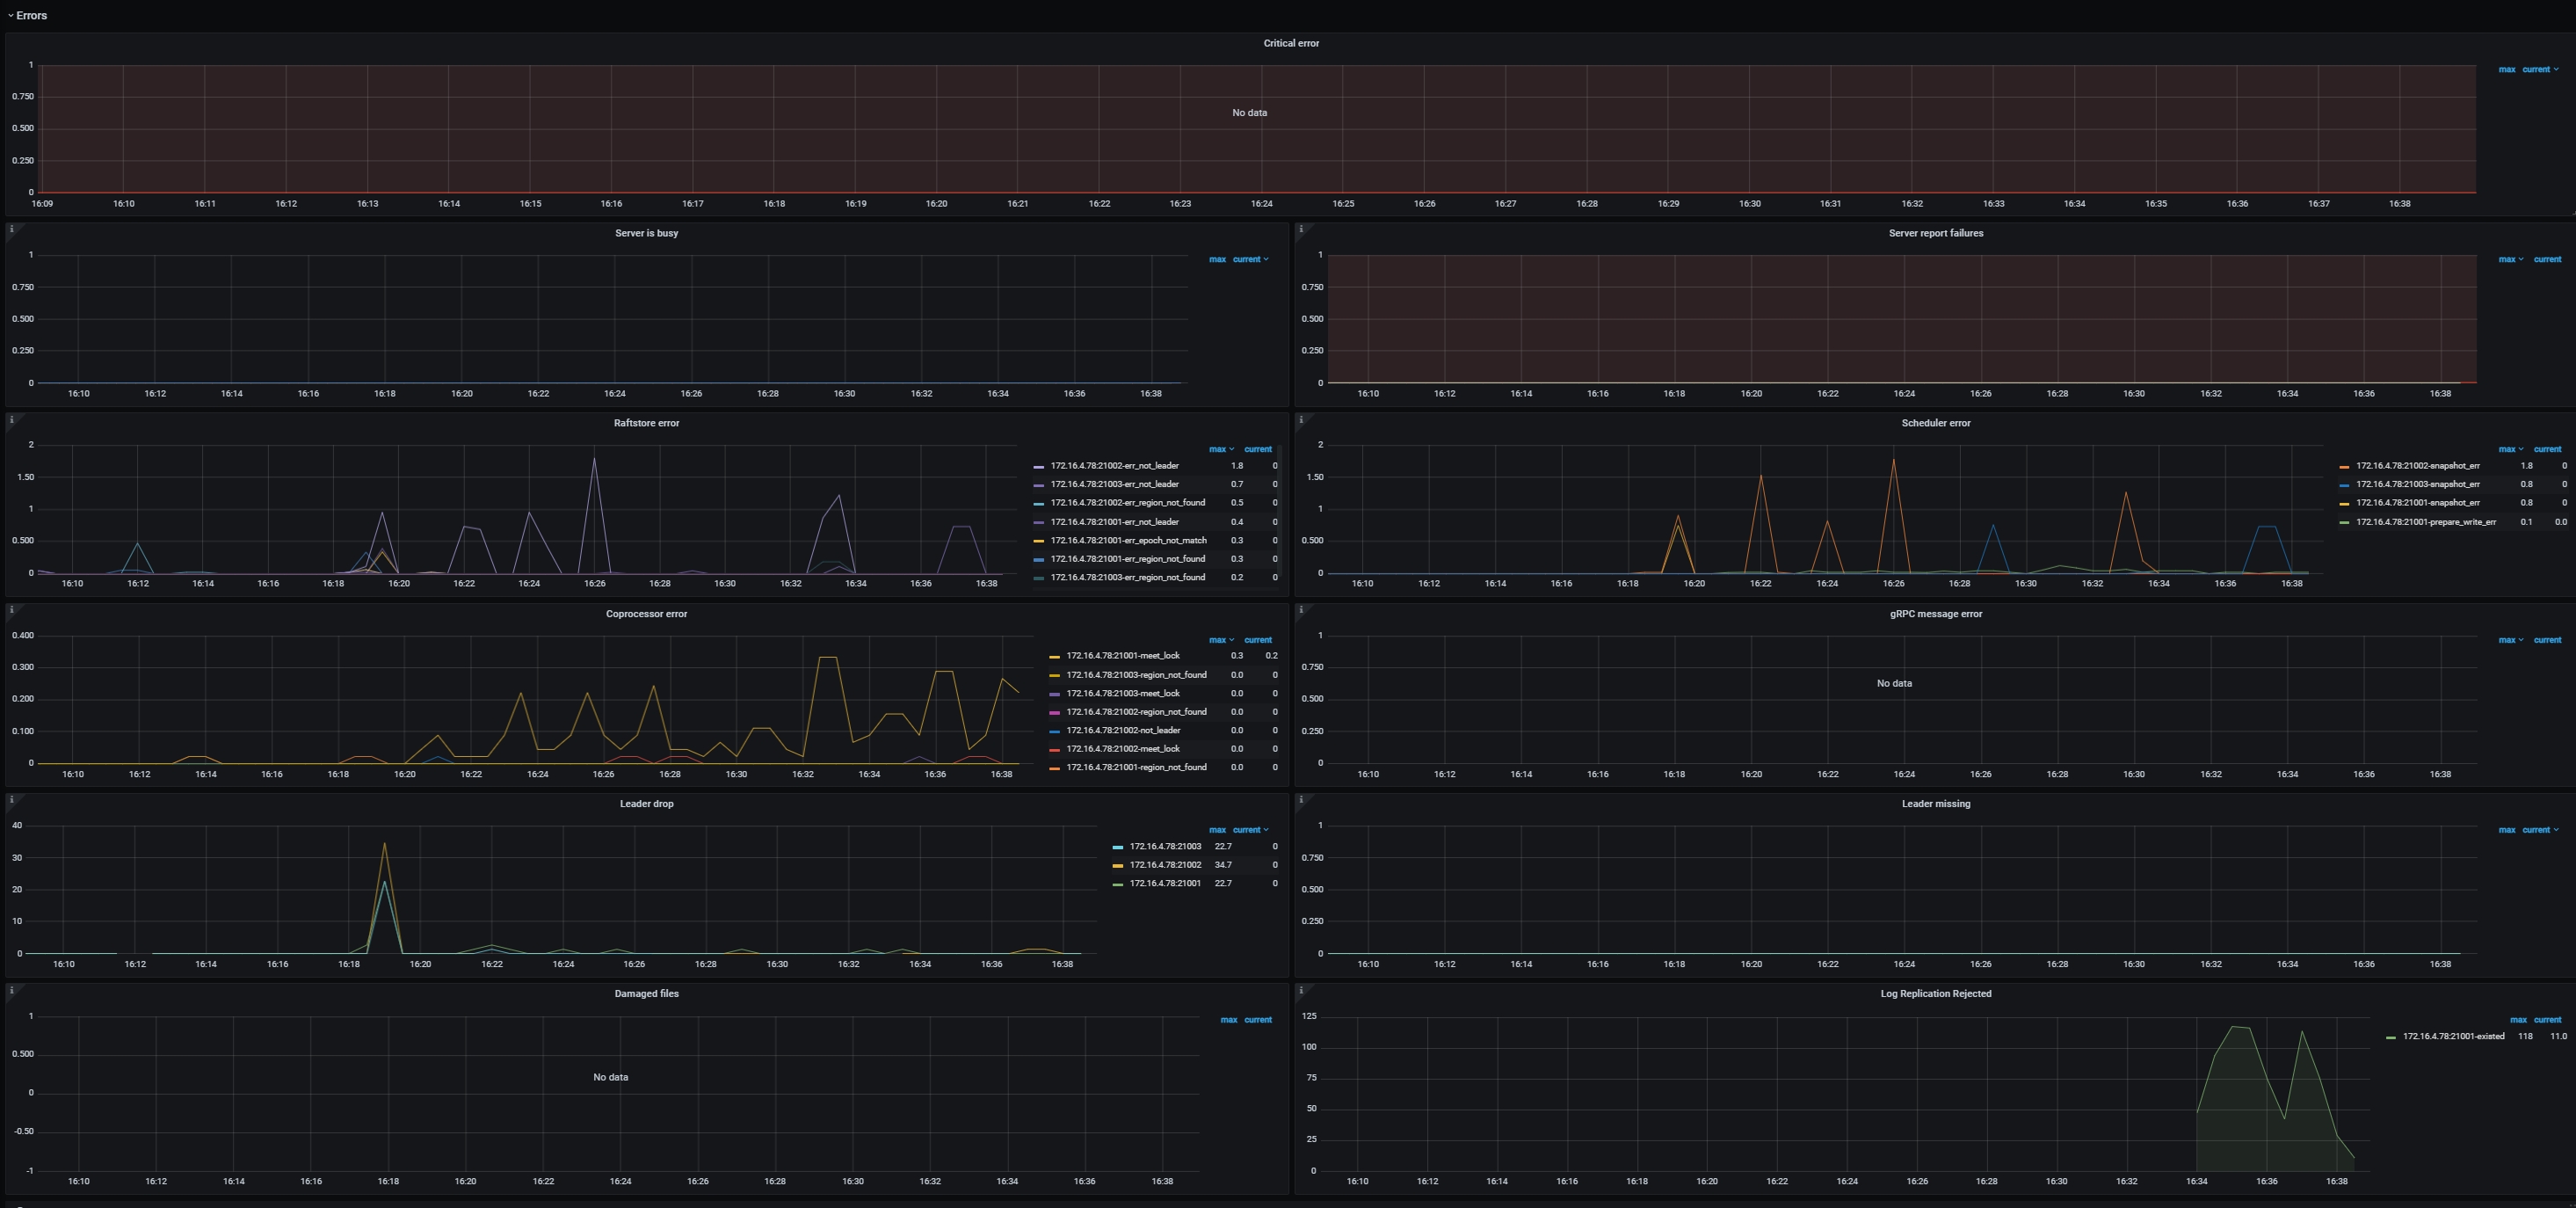
- Critical error: 重大なエラーの数
- Server is busy: 書き込み停止やチャネル満杯など、TiKV インスタンスが一時的に利用できなくなるイベントが発生したことを示します。通常の場合は
0となります。 - Server report failures:サーバーによって報告されたエラーメッセージの数。通常は
0になります。 - Raftstore error:各TiKVインスタンスにおけるタイプ別のRaftstoreエラー数
- Scheduler error: TiKVインスタンスごとに、タイプ別のスケジューラエラーの数
- Coprocessor error:各TiKVインスタンスにおけるタイプ別のコプロセッサエラー数
- gRPC message error:各TiKVインスタンスにおけるタイプ別のgRPCメッセージエラー数
- Leader drop:TiKVインスタンスごとのドロップされたリーダーの数
- Leader missing: TiKVインスタンスごとのリーダーが見つからない数
- Log Replication Reject: 各TiKVインスタンスでメモリ不足のために拒否されたログ追加メッセージの数
Server
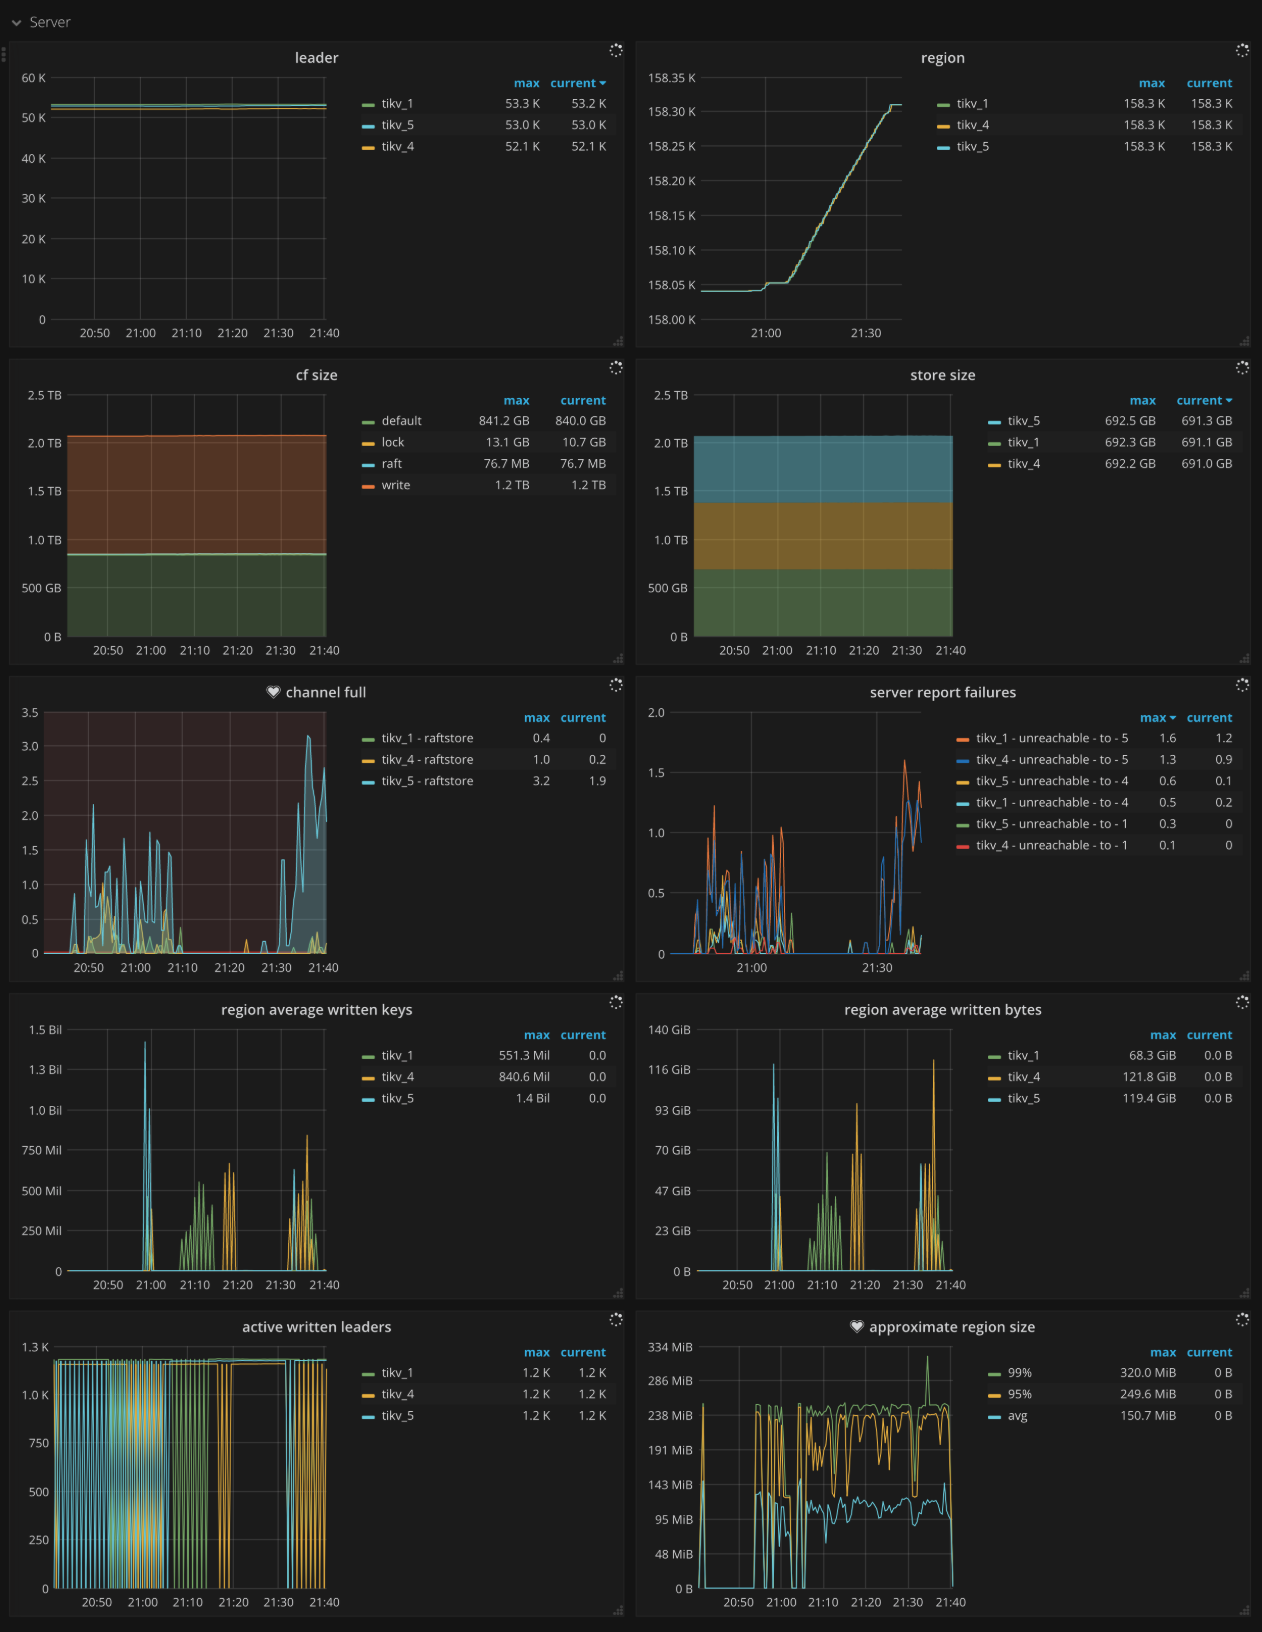
- CF size:各カラムファミリーのサイズ
- Store size:TiKVインスタンスごとのストレージサイズ
- Channel full: TiKV インスタンスごとのチャネル満杯エラーの数。通常の場合は
0になります。 - Active written leaders: 各 TiKV インスタンスで執筆されているリーダーの数
- Approximate Region size:おおよそのリージョンサイズ
- Approximate Region size Histogram:各おおよそのリージョンサイズのヒストグラム
- Region average written keys:TiKVインスタンスごとにリージョンに書き込まれたキーの平均数
- Region average written bytes:TiKVインスタンスごとのリージョンへの平均書き込みバイト数
gRPC
- gRPC message count:タイプごとのgRPCメッセージの発生率
- gRPC message failed: gRPCメッセージの失敗率
- 99% gRPC message duration:メッセージタイプごとのgRPCメッセージ期間(P99)
- Average gRPC message duration:gRPCメッセージの平均実行時間
- gRPC batch size:TiDBとTiKV間のgRPCメッセージのバッチサイズ
- Raft message batch size:TiKVインスタンス間のRaftメッセージのバッチサイズ
- gRPC request sources QPS:gRPCリクエストソースのQPS
- gRPC request sources duration:gRPCリクエストソースの実行時間
- gRPC resource group QPS:リソースグループ別のgRPCリクエストソースのQPS
Thread CPU
- Raft store CPU:
raftstoreスレッドの CPU 使用率。通常の場合、CPU 使用率は 80% *raftstore.store-pool-size未満である必要があります。 - Async apply CPU:
async applyスレッドのCPU使用率。通常の場合、CPU使用率は90% *raftstore.apply-pool-size未満である必要があります。 - Store writer CPU: 非同期IOスレッドのCPU使用率。通常の場合
raftstore.store-io-pool-sizeCPU使用率は90%未満である必要があります。 - gRPC poll CPU:
gRPCスレッドの CPU 使用率。通常の場合、CPU 使用率は 80% *server.grpc-concurrency未満である必要があります。 - Scheduler worker CPU:
scheduler workerスレッドの CPU 使用率。通常の場合、CPU 使用率は 90% *storage.scheduler-worker-pool-size未満である必要があります。 - Storage ReadPool CPU:
storage read poolスレッドの CPU 使用率 - Unified read pool CPU:
unified read poolスレッドのCPU使用率 - RocksDB CPU: RocksDBスレッドのCPU使用率
- Coprocessor CPU:
coprocessorスレッドのCPU使用率 - GC worker CPU:
GC workerスレッドのCPU使用率 - BackGround worker CPU:
background workerスレッドのCPU使用率 - Import CPU:
importスレッドの CPU 使用率 - Backup Worker CPU:
backupスレッドのCPU使用率 - CDC Worker CPU:
CDC workerスレッドのCPU使用率 - CDC endpoint CPU:
CDC endpointスレッドのCPU使用率 - Raftlog fetch worker CPU:非同期RaftログフェッチャーワーカーのCPU使用率
- TSO Worker CPU:
TSO workerスレッドのCPU使用率
PD
- PD requests:TiKVがPDに送信するレート
- PD request duration (average):TiKVがPDに送信するリクエストの処理にかかる平均時間
- PD heartbeats:TiKVからPDへハートビートメッセージが送信される頻度
- PD validate peers:TiKVからPDへTiKVピアを検証するためにメッセージが送信される頻度
Raft IO
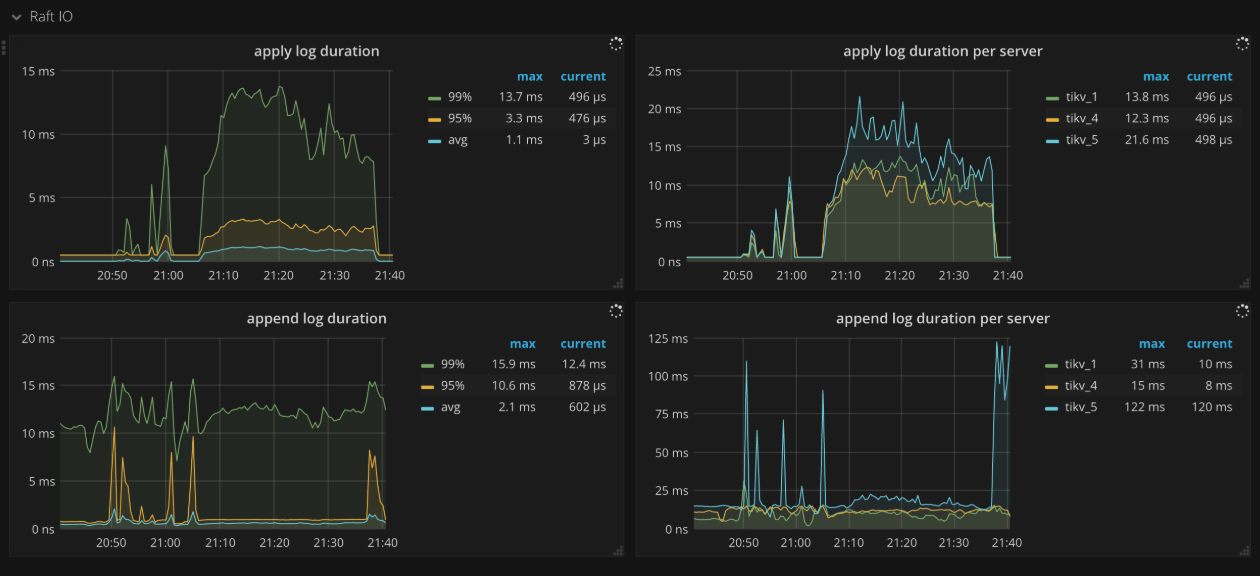
- Apply log duration: Raftがログを適用するのにかかる時間
- Apply log duration per server: RaftがTiKVインスタンスごとにログを適用するのにかかる時間
- Append log duration: Raftがログを追加するのにかかる時間
- Append log duration per server: RaftがTiKVインスタンスごとにログを追加するのにかかる時間
- Commit log duration: Raftがログをコミットするのに要する時間
- Commit log duration per server: RaftがTiKVインスタンスごとにログをコミットするのに要する時間
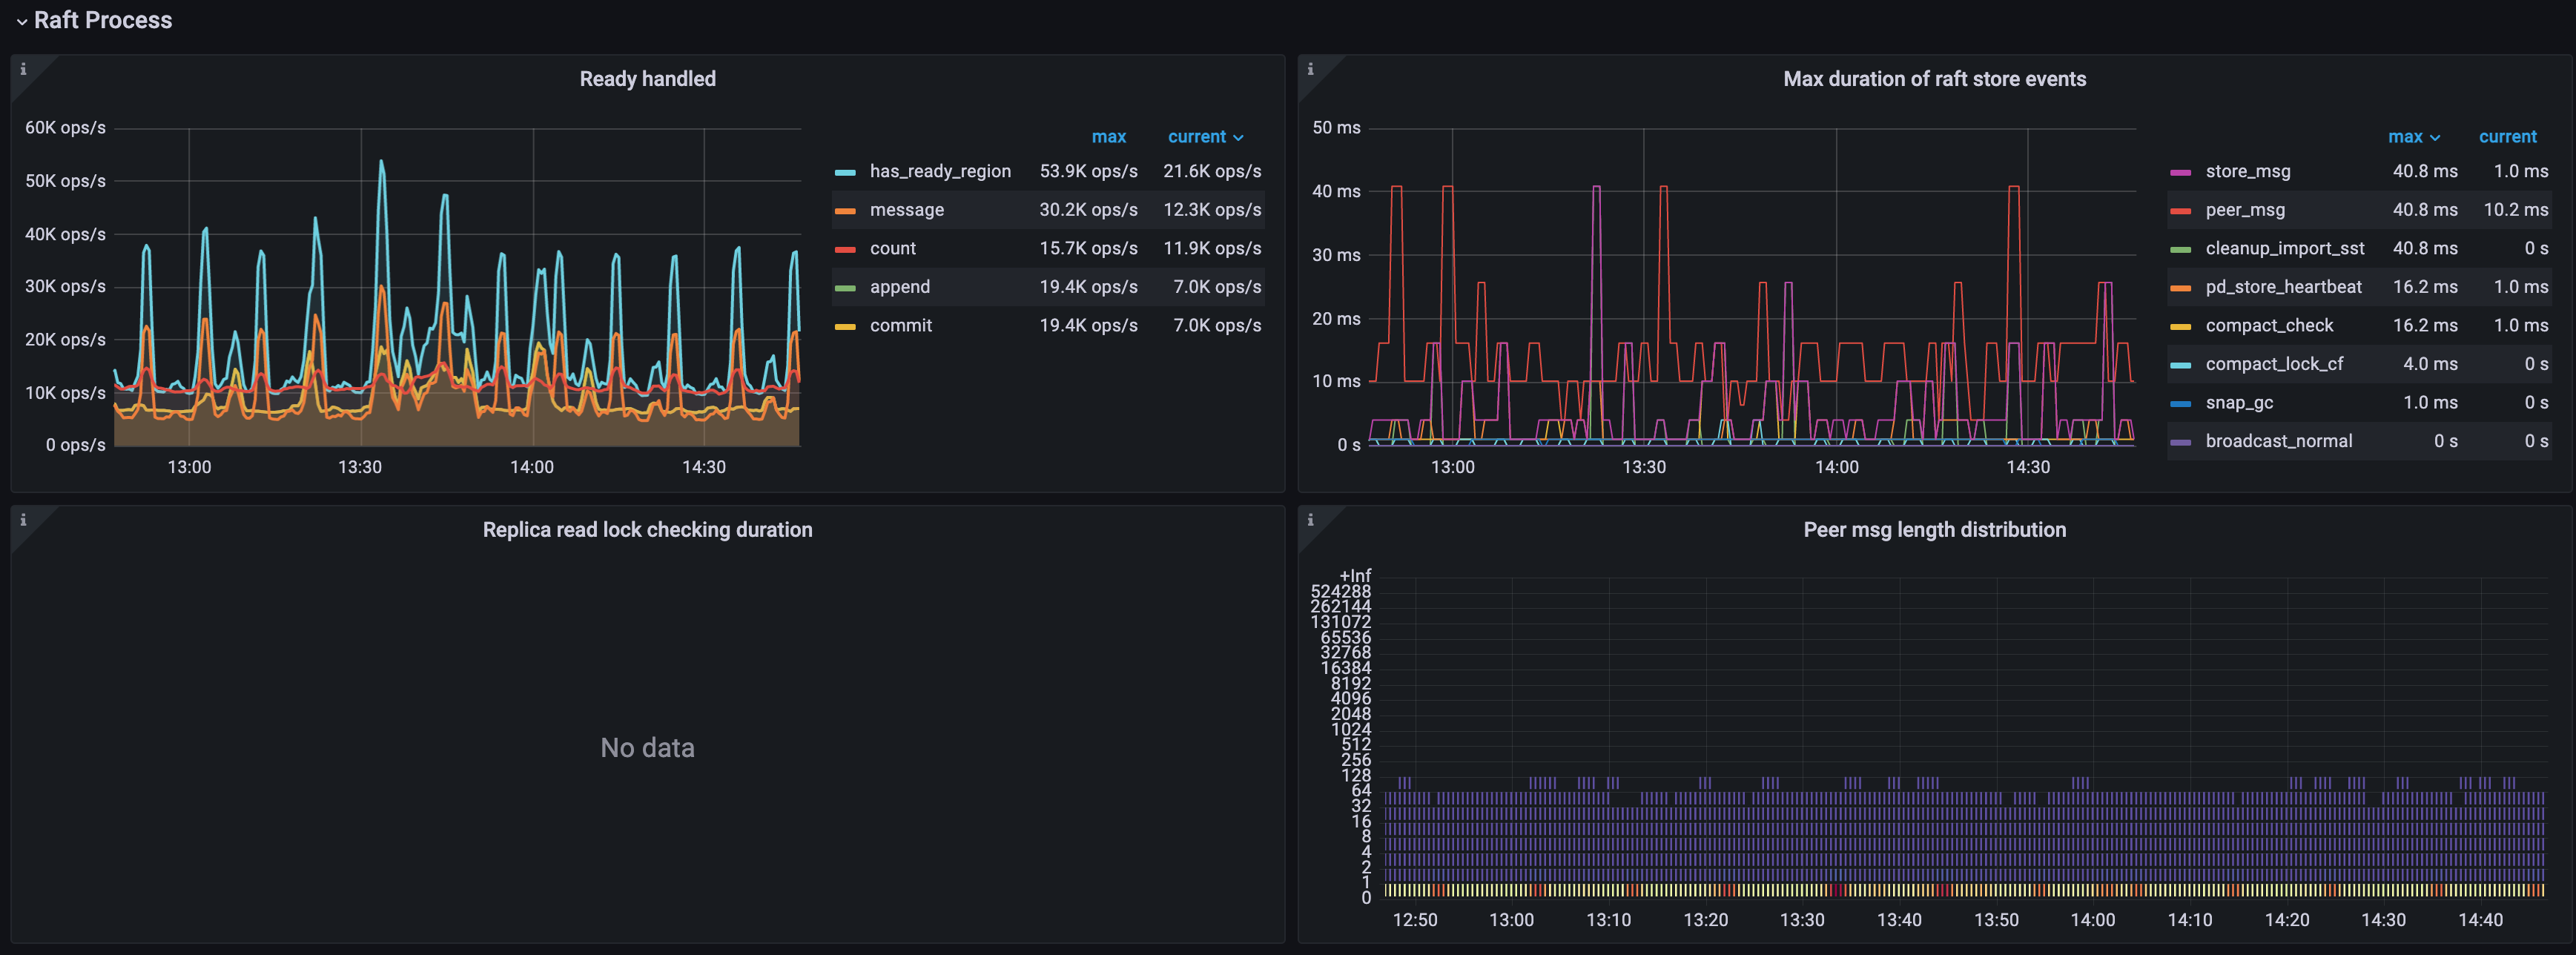
Raft process
- Ready handled: 1秒あたり、タイプごとに処理された準備完了操作の数
- count: 1秒あたりに処理された準備完了操作の数
- has_ready_region: 1秒あたりに準備完了状態にあるリージョンの数
- pending_region: 準備完了状態かどうかを確認しているリージョンの1秒あたりの操作数。このメトリックはv3.0.0以降非推奨です。
- メッセージ: 準備完了操作が1秒あたりに含むメッセージの数
- 追加: 準備完了操作が1秒あたりに含むRaftログエントリの数
- commit: 準備完了操作が1秒あたりにコミットするRaftログエントリの数
- スナップショット: 準備完了操作が1秒あたりに保持するスナップショットの数
- 0.99 Duration of Raft store events:Raftstoreイベントにかかる時間(P99)
- Process ready duration: Raftでプロセスが準備完了になるまでにかかる時間
- Process ready duration per server:TiKVインスタンスごとに、 Raftでピアプロセスが準備完了になるまでにかかる時間。2秒未満(P99.99)である必要があります。
- Max Duration of Raft store events:最も遅いRaftstoreイベントにかかる時間。
- Replica read lock checking duration:レプリカ読み取り処理時にロックをチェックするのに要する時間。
- Peer msg length distribution:各TiKVインスタンスの各リージョンで同時に処理されるメッセージ数。メッセージ数が多いほど、ピアの処理負荷が高くなります。
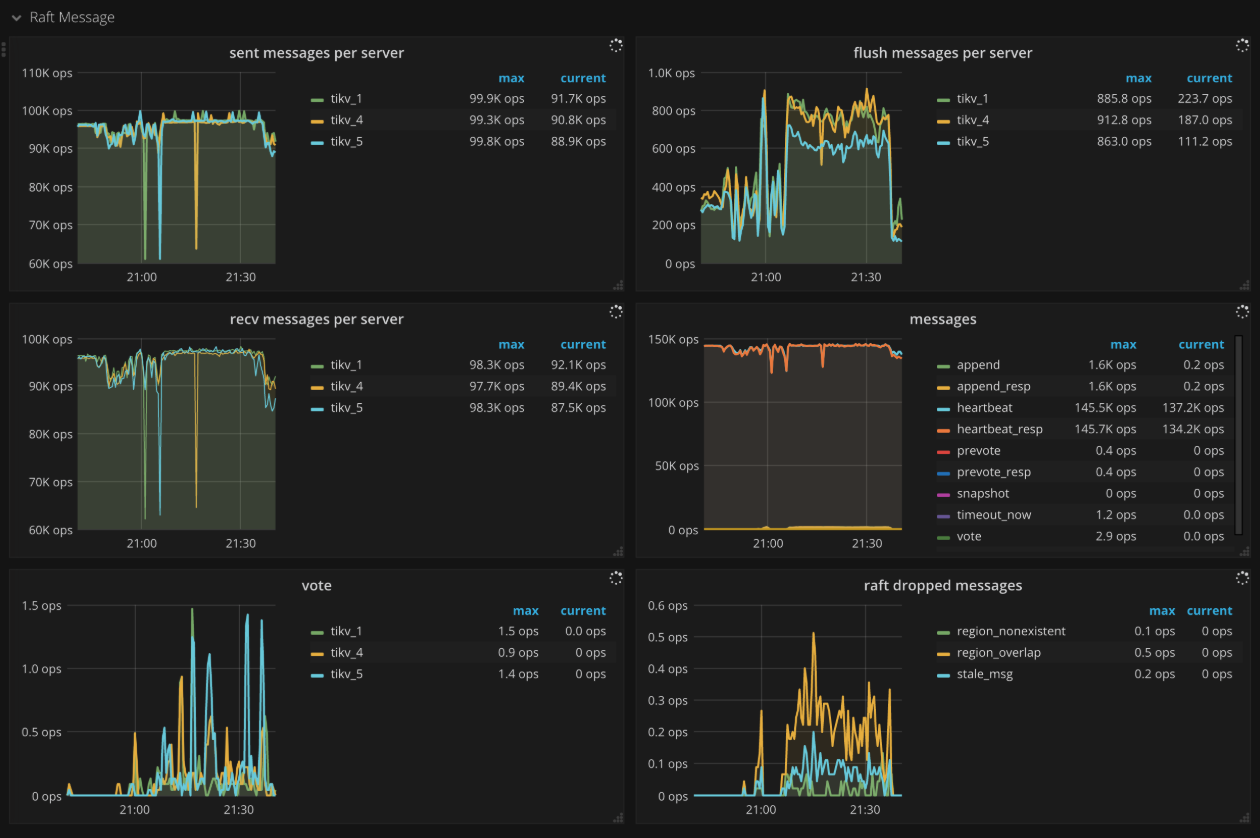
Raft message
- Sent messages per server:各TiKVインスタンスが1秒あたりに送信するRaftメッセージの数
- Flush messages per server:各TiKVインスタンスでRaftクライアントが1秒あたりにフラッシュするRaftメッセージの数
- Receive messages per server:各TiKVインスタンスが1秒あたりに受信するRaftメッセージの数
- Messages:1秒あたりに送信されるRaftメッセージの種類ごとの数
- Vote: Raftで1秒あたりに送信される投票メッセージの数
- Raft dropped messages: 1秒あたりの、種類別のドロップされたRaftメッセージ数
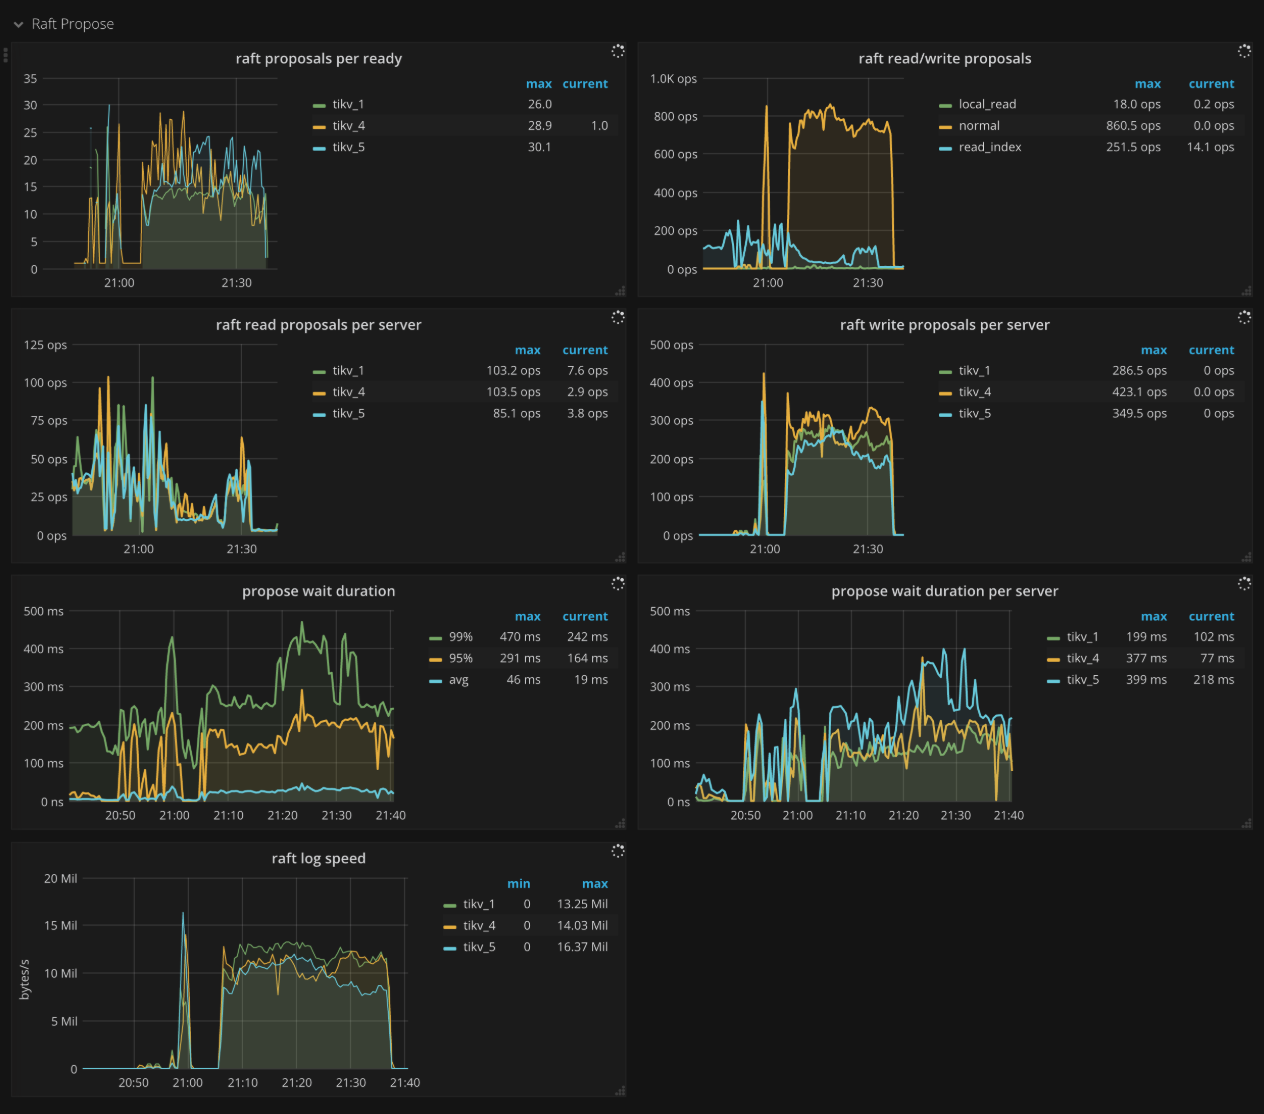
Raft propose
- Raft apply proposals per ready: 提案適用中に、各準備完了操作がバッチ内に含める提案数のヒストグラム。
- Raft read/write proposals:1秒あたりのタイプ別提案数
- Raft read proposals per server:各TiKVインスタンスが1秒あたりに行う読み取り提案の数
- Raft write proposals per server:各TiKVインスタンスが1秒あたりに行う書き込み提案の数
- Propose wait duration:各提案の待ち時間のヒストグラム
- Propose wait duration per server:TiKVインスタンスごとの各提案の待ち時間のヒストグラム
- Apply wait duration:各提案の適用時間のヒストグラム
- Apply wait duration per server:TiKVインスタンスごとの各提案の適用時間のヒストグラム
- Raft log speed:ピアがログを提案する平均レート
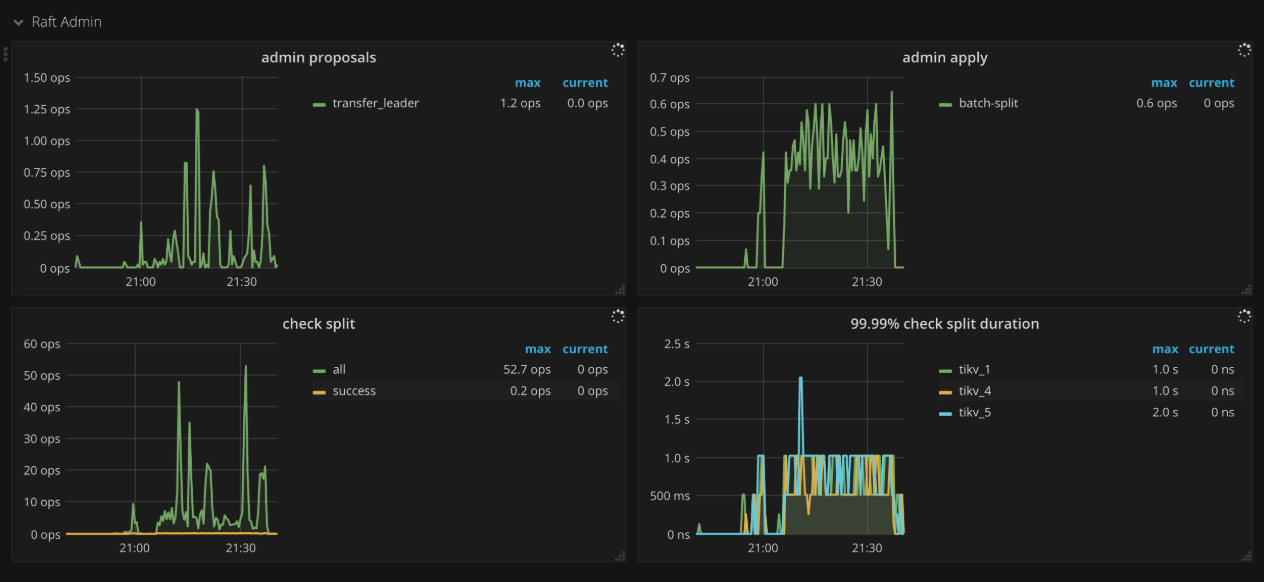
Raft admin
- Admin proposals:1秒あたりの管理者提案数
- Admin apply: 1秒あたりに処理される適用コマンドの数
- Check split:1秒あたりのRaftstore分割チェックコマンドの数
- 99.99% Check split duration: 分割チェックコマンドの実行に要した時間 (P99.99)
Local reader
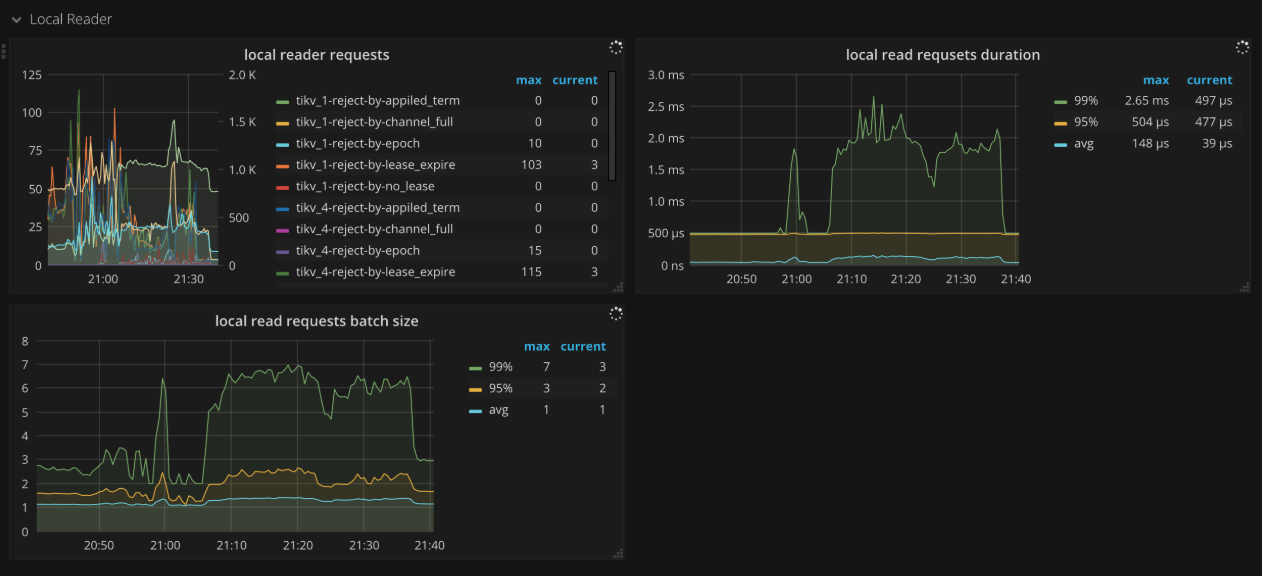
- Local reader requests:ローカル読み取りスレッドからの総リクエスト数と拒否数
Unified Read Pool
- Time used by level:統合リードプールにおける各レベルで消費された時間。レベル0は小規模クエリを意味します。
- Level 0 chance:統合リードプールにおけるレベル0タスクの割合
- Running tasks:統合読み取りプールで同時に実行されているタスクの数
Storage
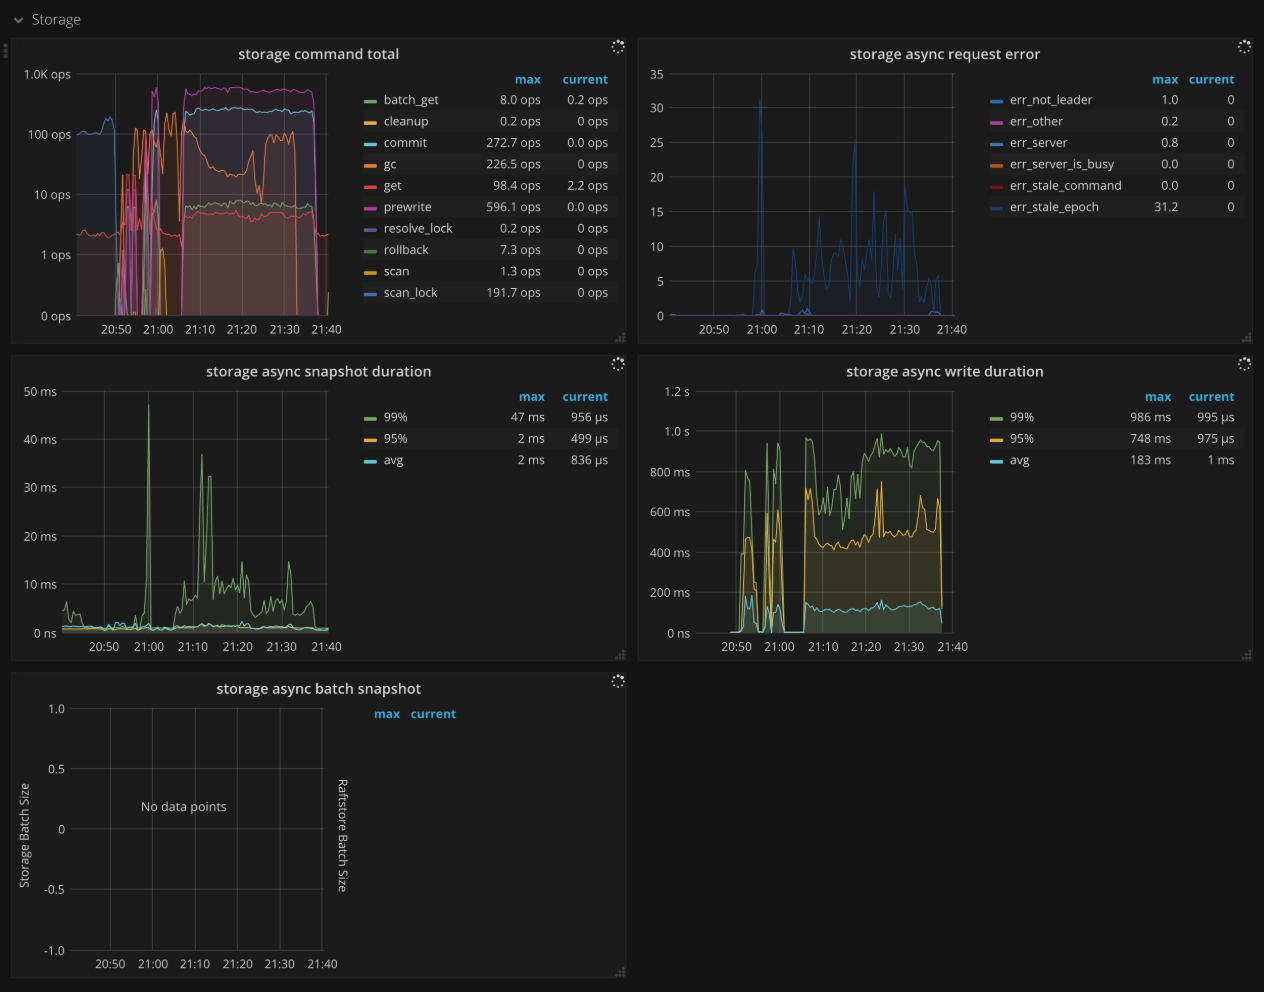
- Storage command total:1秒あたりに受信したコマンドの種類別の数
- Storage async request error:1秒あたりのエンジン非同期リクエストエラーの数
- Storage async snapshot duration: 非同期スナップショットリクエストの処理に要する時間。
1s以内の.99未満である必要があります。 - Storage async write duration: 非同期書き込みリクエストの処理に要する時間。
1s以内の.99未満である必要があります。
Flow Control
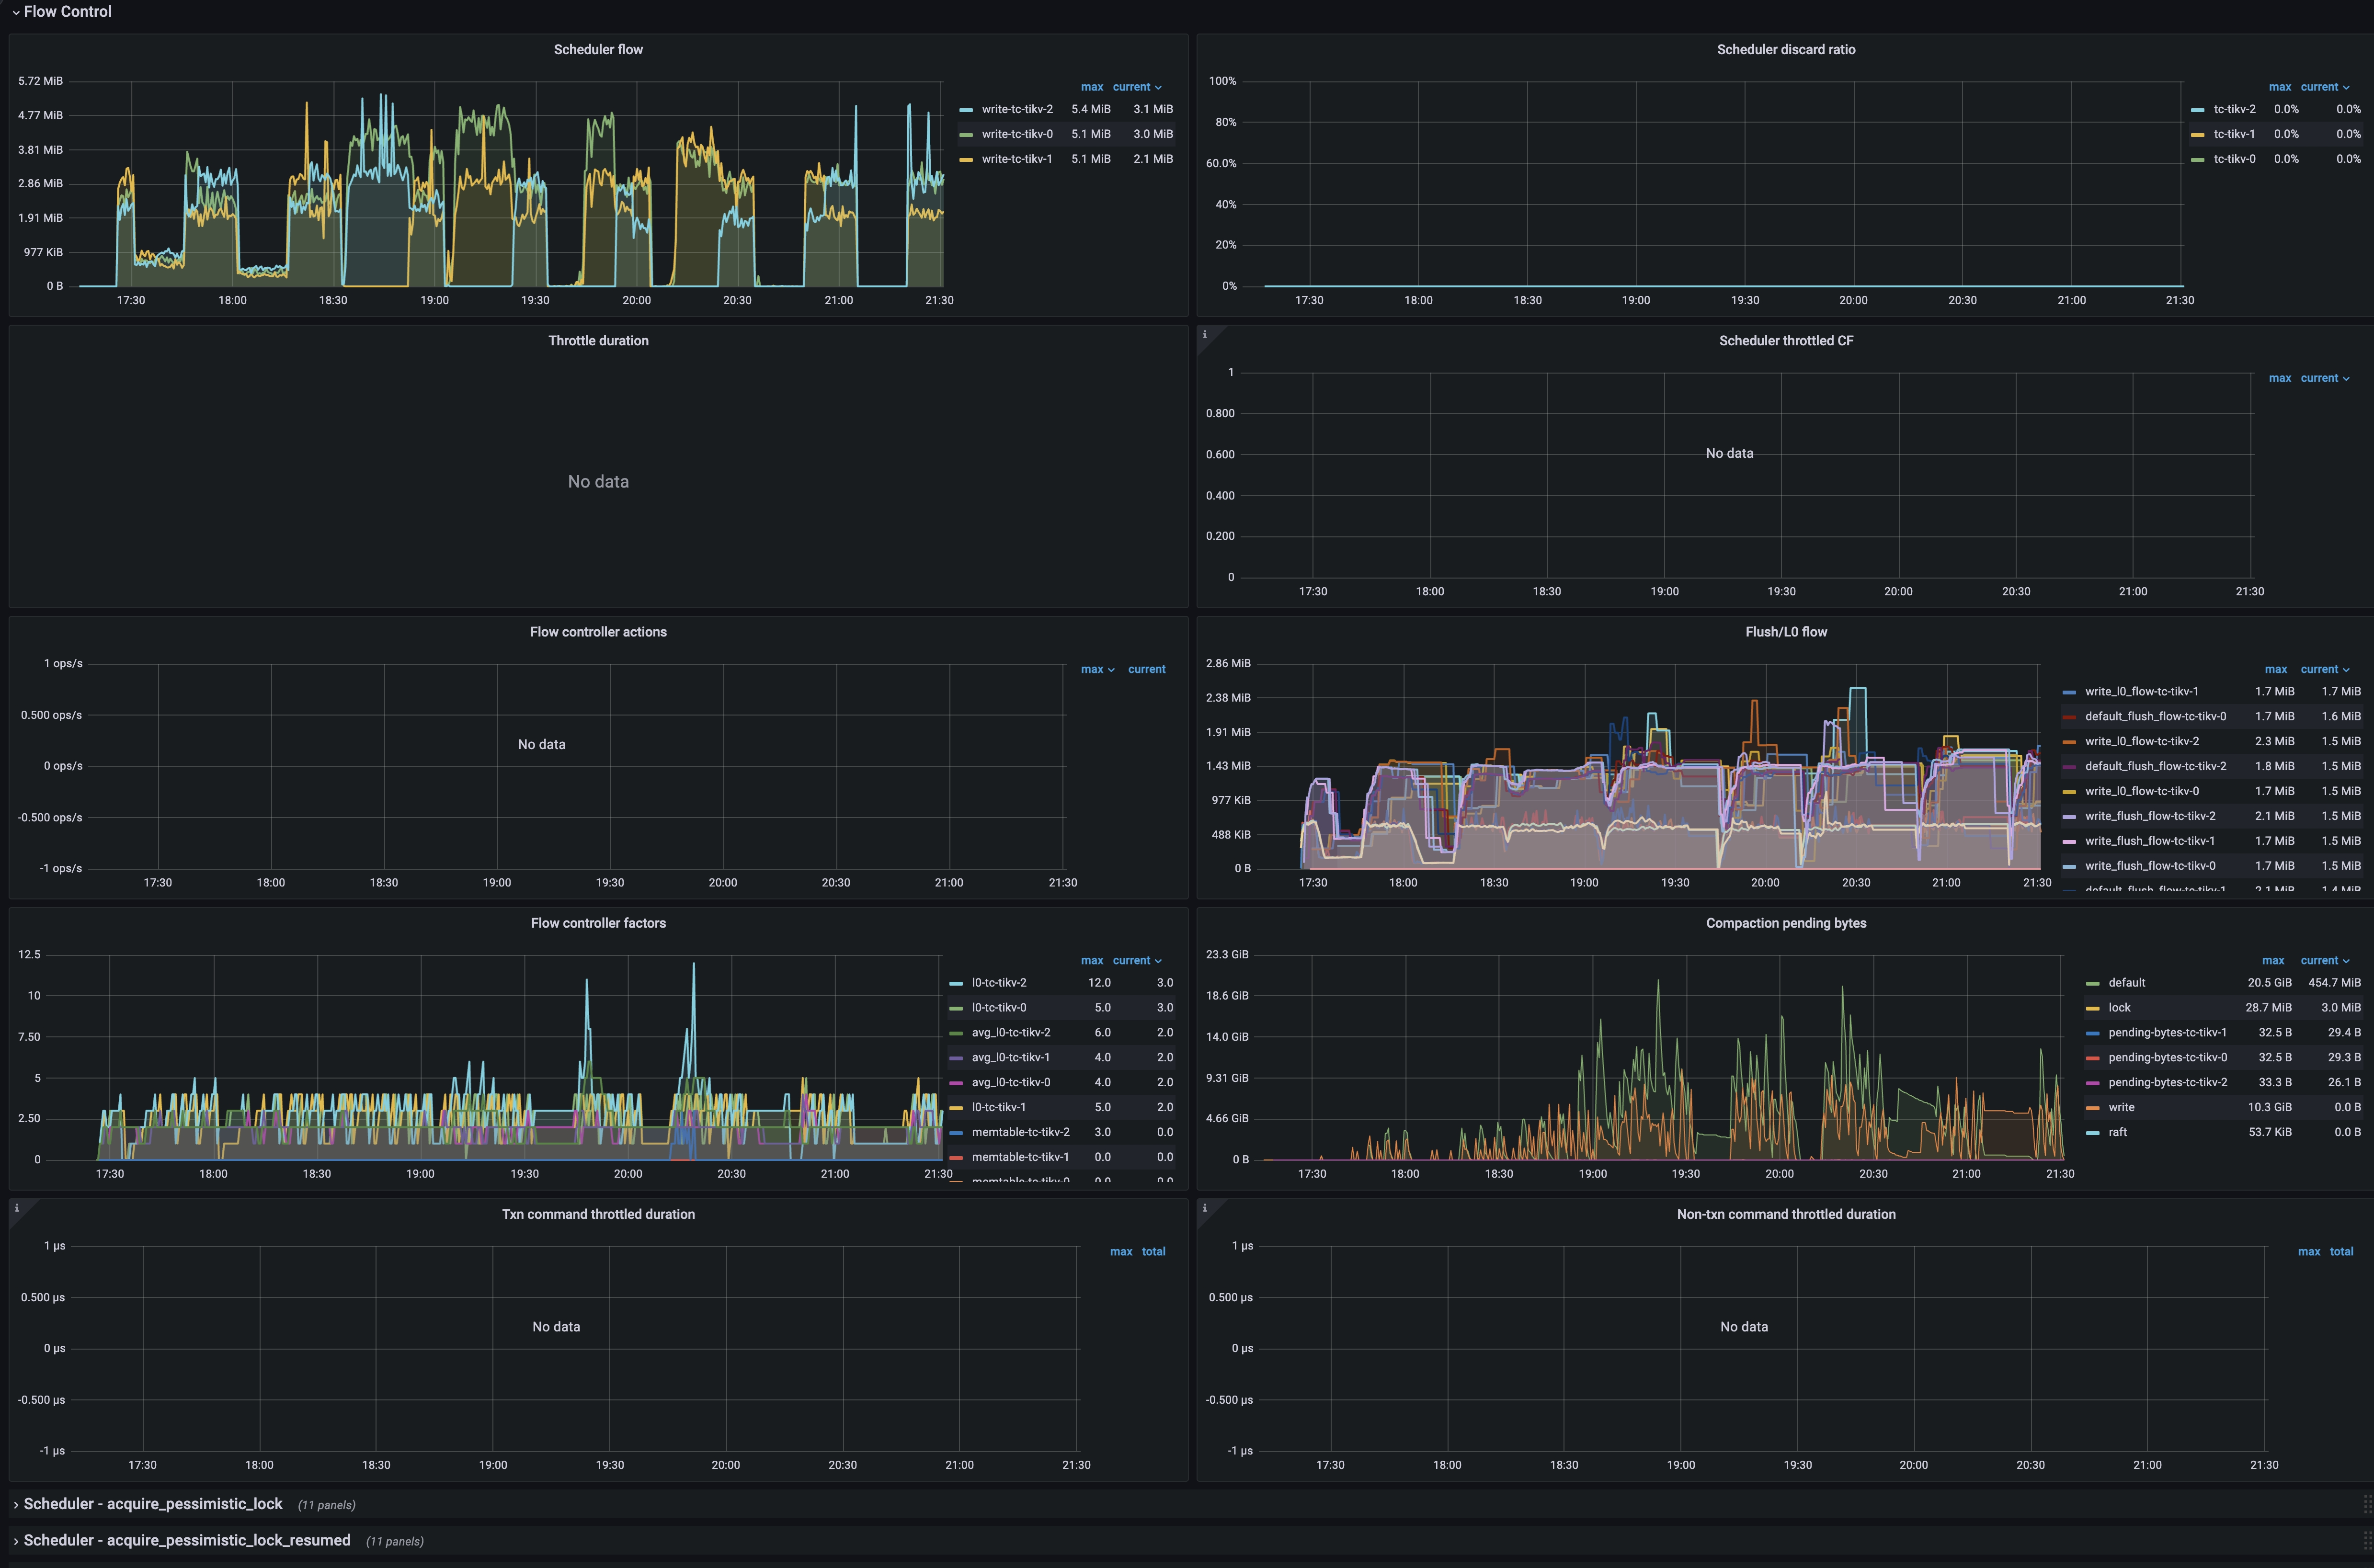
- Scheduler flow:各TiKVインスタンスにおけるスケジューラのトラフィックをリアルタイムで表示します。
- Scheduler discard ratio:各 TiKV インスタンスにおけるスケジューラリクエストの拒否率。この比率が 0 より大きい場合、フロー制御が存在することを示します。
Compaction pending bytesがしきい値を超えると、TiKV は超過分に基づいてScheduler discard ratioを線形に増加させます。クライアントは拒否されたリクエストを自動的に再試行します。 - Throttle duration:L0ファイルが多すぎるためにフロー制御がトリガーされた場合に、スケジューラリクエストの実行がブロックされる期間。このメトリックに値がある場合、フロー制御が存在していることを示します。
- Scheduler throttled CF:フロー制御のしきい値に達したときにRocksDBのスロットリングをトリガーするCF。
- Flow controller actions:フロー制御のしきい値に達したときにRocksDBのスロットリングをトリガーするアクション。
- Flush/L0 flow:各TiKVインスタンス上のRocksDBの異なるCFにおけるフラッシュとL0圧縮のトラフィック。
- Flow control factors:RocksDBのスロットリングをトリガーする要因。
- Compaction pending bytes:各TiKVインスタンスでリアルタイムにコンパクション待ち状態にあるRocksDBデータのサイズ。
- Txn command throttled duration:スロットリングによりトランザクションに関連するコマンドがブロックされた期間。通常、このメトリックは0です。
- Non-txn command throttled duration:スロットリングによって他のコマンドがブロックされた期間。通常、このメトリックは0です。
Scheduler
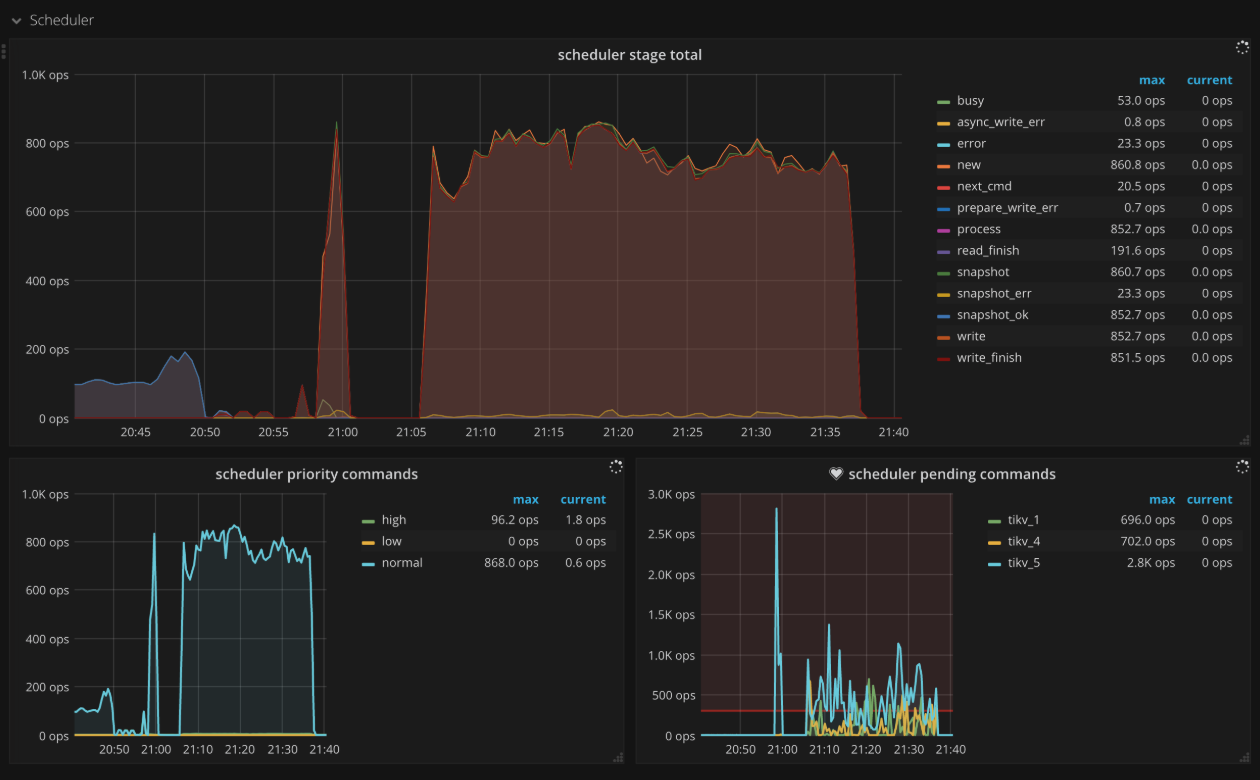
- Scheduler stage total:各ステージにおける1秒あたりのコマンド数。短時間で多くのエラーが発生するべきではありません。
- Scheduler writing bytes: 各TiKVインスタンスで処理されたコマンドによって書き込まれた合計バイト数
- Scheduler priority commands:1秒あたりの異なる優先度コマンドの数
- Scheduler pending commands:TiKVインスタンスごとに1秒あたりに保留されているコマンドの数
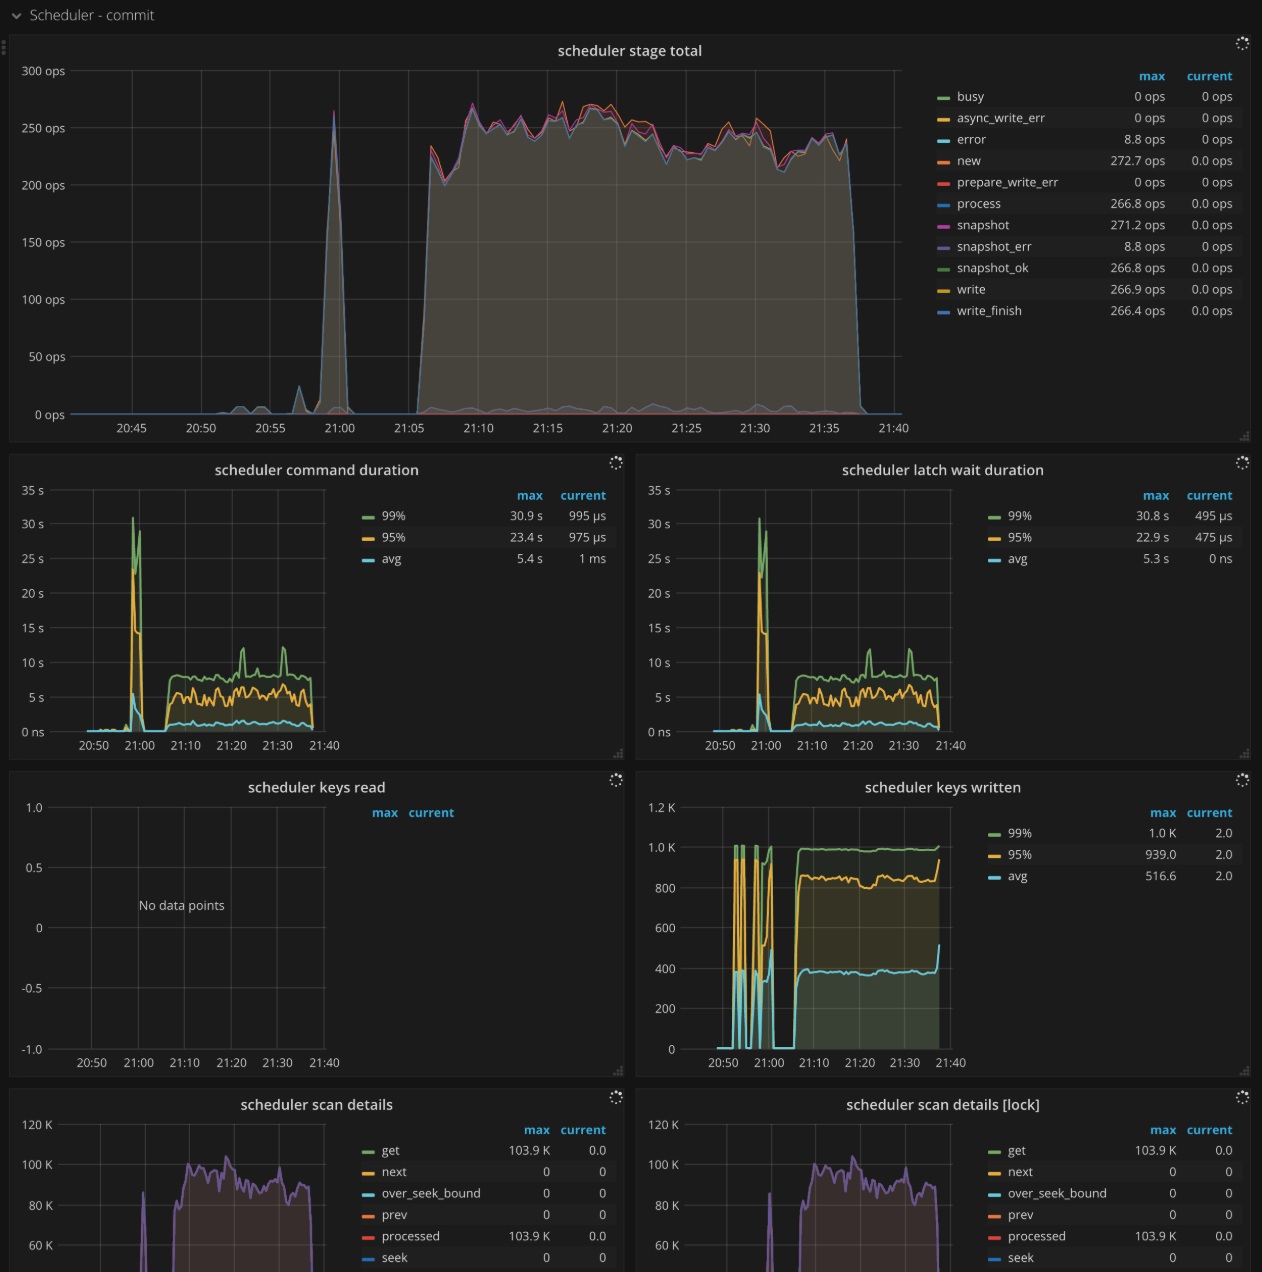
Scheduler - commit
- Scheduler stage total:コミットコマンド実行時の、各ステージにおける1秒あたりのコマンド数。短時間で多くのエラーが発生するべきではありません。
- Scheduler command duration: コミットコマンドの実行に要する時間。
1s未満である必要があります。 - Scheduler latch wait duration: コミット コマンドの実行時にラッチによって発生する待機時間。
1sより小さくなければなりません。 - Scheduler keys read: コミットコマンドによって読み取られたキーの数
- Scheduler keys written: コミットコマンドによって書き込まれたキーの数
- Scheduler scan details: commit コマンド実行時に各 CF のキースキャンの詳細を示します。
- Scheduler scan details [lock]: コミットコマンド実行時のロックCFのキースキャン詳細
- Scheduler scan details [write]: コミットコマンド実行時の書き込みCFのキースキャン詳細
- Scheduler scan details [default]: コミットコマンド実行時のデフォルトCFのキースキャン詳細
Scheduler - pessimistic_rollback
- Scheduler stage total:
pessimistic_rollbackコマンド実行時の、各ステージにおける1秒あたりのコマンド数。短時間で多くのエラーが発生するべきではありません。 - Scheduler command duration:
pessimistic_rollbackコマンドの実行に要する時間。1sより短くなければなりません。 - Scheduler latch wait duration:
pessimistic_rollbackコマンドの実行時にラッチによって発生する待機時間。1sより短くする必要があります。 - Scheduler keys read:
pessimistic_rollbackコマンドによって読み取られたキーの数 - Scheduler keys written:
pessimistic_rollbackコマンドによって書き込まれたキーの数 - Scheduler scan details:
pessimistic_rollbackコマンドを実行する際の各 CF のキーのスキャン詳細。 - Scheduler scan details [lock]:
pessimistic_rollbackコマンド実行時のロック CF のキースキャンの詳細 - Scheduler scan details [write]:
pessimistic_rollbackコマンド実行時の書き込み CF のキー スキャン詳細 - Scheduler scan details [default]:
pessimistic_rollbackコマンド実行時のデフォルト CF のキー スキャン詳細
Scheduler - prewrite
- Scheduler stage total:プリライトコマンド実行時の、各ステージにおける1秒あたりのコマンド数。短時間で多くのエラーが発生するべきではありません。
- Scheduler command duration: プリライトコマンドの実行に要する時間。
1s未満である必要があります。 - Scheduler latch wait duration: プリライト コマンドの実行時にラッチによって発生する待機時間。
1sより小さくなければなりません。 - Scheduler keys read:プリライトコマンドによって読み取られたキーの数
- Scheduler keys written:プリライトコマンドによって書き込まれたキーの数
- Scheduler scan details:プリライトコマンド実行時の各CFのキースキャン詳細。
- Scheduler scan details [lock]: プリライトコマンド実行時のロックCFのキースキャン詳細
- Scheduler scan details [write]: プリライトコマンド実行時の書き込みCFのキースキャン詳細
- Scheduler scan details [default]: プリライトコマンド実行時のデフォルトCFのキースキャン詳細
Scheduler - rollback
- Scheduler stage total:ロールバックコマンド実行時の、各ステージにおける1秒あたりのコマンド数。短時間で多くのエラーが発生するべきではありません。
- Scheduler command duration: ロールバックコマンドの実行に要する時間。
1s未満である必要があります。 - Scheduler latch wait duration: ロールバック コマンドの実行時にラッチによって発生する待機時間。
1sより小さくなければなりません。 - Scheduler keys read:ロールバックコマンドによって読み取られたキーの数
- Scheduler keys written: ロールバックコマンドによって書き込まれたキーの数
- Scheduler scan details: ロールバックコマンド実行時に各CFのキースキャンの詳細を示します。
- Scheduler scan details [lock]: ロールバックコマンド実行時のロックCFのキースキャン詳細
- Scheduler scan details [write]: ロールバックコマンド実行時の書き込みCFのキースキャン詳細
- Scheduler scan details [default]: ロールバックコマンド実行時のデフォルトCFのキースキャンの詳細
GC
- GC tasks: gc_workerによって処理されたGCタスクの数
- GC tasks Duration:GCタスクの実行に要する時間
- TiDB GC seconds:GCの所要時間
- TiDB GC worker actions:TiDB GCワーカーアクションの回数
- ResolveLocks Progress:GCの第一段階(Resolve Locks)の進捗状況
- TiKV Auto GC Progress:GCの第2段階の進捗状況
- GC speed:1秒あたりにGCによって削除されるキーの数
- TiKV Auto GC SafePoint: TiKV GCセーフポイントの値。セーフポイントは現在のGCタイムスタンプです。
- GC lifetime:TiDB GCの寿命
- GC interval:TiDB GCの間隔
- GC in Compaction Filter: write CFのコンパクションフィルタでフィルタリングされたバージョンの数。
Snapshot
- Rate snapshot message: Raftスナップショットメッセージが送信される頻度
- 99% Handle snapshot duration:スナップショットの処理にかかる時間(P99)
- Snapshot state count:状態ごとのスナップショット数
- 99.99% Snapshot size: スナップショットサイズ (P99.99)
- 99.99% Snapshot KV count:スナップショット内のKV数(P99.99)
Task
- Worker handled tasks:ワーカーが1秒あたりに処理したタスク数
- Worker pending tasks: ワーカーが1秒あたりに処理している保留中および実行中のタスクの現在の数。通常は
1000未満である必要があります。 - FuturePool handled tasks:FuturePoolが1秒あたりに処理したタスク数
- FuturePool pending tasks:FuturePoolの保留中および実行中のタスクの現在の数(1秒あたり)
Coprocessor Overview
- Request duration:コプロセッサからのリクエストを受信してから、リクエストの処理が完了するまでの合計時間
- Total Requests:1秒あたりのリクエストの種類別数
- Handle duration:コプロセッサリクエストを実際に処理した時間(1分あたり)のヒストグラム
- Total Request Errors:コプロセッサーが1秒あたりに発生させたリクエストエラーの数。短時間に多数のエラーが発生するべきではありません。
- Total KV Cursor Operations: 1秒あたりのタイプ別の KV カーソル操作の合計数。例
select、index、analyze_table、analyze_index、checksum_table、checksum_index。 - KV Cursor Operations:1秒あたりのタイプ別KVカーソル操作のヒストグラム
- Total RocksDB Perf Statistics:RocksDBのパフォーマンスに関する統計情報
- Total Response Size:コプロセッサ応答の合計サイズ
Coprocessor Detail
- Handle duration:コプロセッサリクエストを実際に処理した時間(1分あたり)のヒストグラム
- 95% Handle duration by store:TiKVインスタンスごとに、コプロセッサリクエストを処理するのに要する時間(1秒あたり)(P95)
- Wait duration: コプロセッサリクエストが処理されるのを待っている間に消費される時間。
10s(P99.99) 未満である必要があります。 - 95% Wait duration by store:コプロセッサリクエストが処理待ち状態にある時間(TiKVインスタンスごと、1秒あたり)(P95)
- Total DAG Requests:1秒あたりのDAGリクエストの総数
- Total DAG Executors:1秒あたりのDAG実行者の総数
- Total Ops Details (Table Scan):コプロセッサでselectスキャンを実行する際の、1秒あたりのRocksDB内部操作数
- Total Ops Details (Index Scan):コプロセッサでインデックススキャンを実行する際の、1秒あたりのRocksDB内部操作の数
- Total Ops Details by CF (Table Scan):コプロセッサで選択スキャンを実行する際の、各CFにおける1秒あたりのRocksDB内部操作の数
- Total Ops Details by CF (Index Scan):コプロセッサでインデックススキャンを実行する際の、各CFにおける1秒あたりのRocksDB内部操作の数
Threads
- Threads state:TiKVスレッドの状態
- Threads IO:各TiKVスレッドのI/Oトラフィック
- Thread Voluntary Context Switches: TiKVスレッドの自発的コンテキストスイッチの数
- Thread Nonvoluntary Context Switches: TiKVスレッドの非自発的コンテキストスイッチの数
RocksDB - kv/raft
- Get operations: 1秒あたりの取得操作の回数
- Get duration:取得操作の実行に要した時間
- Seek operations:1秒あたりのシーク操作回数
- Seek duration:シーク操作の実行に要する時間
- Write operations:1秒あたりの書き込み操作回数
- Write duration:書き込み操作の実行に要する時間
- WAL sync operations:1秒あたりのWAL同期操作の回数
- Write WAL duration:WALの書き込みに要した時間
- WAL sync duration:WAL同期操作の実行に要する時間
- Compaction operations:1秒あたりの圧縮および洗浄作業の回数
- Compaction duration:圧縮および洗浄作業の実行に要する時間
- SST read duration:SSTファイルの読み込みに要する時間
- Write stall duration: 停止時間を書き込む。通常の場合は
0となるはずです。 - Memtable size:各カラムファミリーのmemtableサイズ
- Memtable hit:memtableのヒット率
- Block cache size:ブロックキャッシュのサイズ。共有ブロックキャッシュが無効になっている場合は、カラムファミリーごとに内訳が表示されます。
- Block cache hit:ブロックキャッシュのヒット率
- Block cache flow:タイプごとのブロックキャッシュ操作のフローレート
- Block cache operations: タイプごとのブロックキャッシュ操作の回数
- Keys flow:キーの種類ごとの操作フローレート
- Total keys:各カラムファミリー内のキーの数
- Read flow:タイプごとの読み取り操作のフローレート
- Bytes / Read:読み取り操作1回あたりのバイト数
- Write flow:タイプごとの書き込み操作のフローレート
- Bytes / Write: 書き込み操作あたりのバイト数
- Compaction flow:タイプ別の圧縮作業のフローレート
- Compaction pending bytes:圧縮対象となる保留バイト数
- Compaction Job Size(files):単一の圧縮ジョブに関係するSSTファイルの数
- Read amplification: TiKVインスタンスごとのリード増幅率
- Compression ratio:各レベルの圧縮率
- Number of snapshots:TiKVインスタンスごとのスナップショット数
- Oldest snapshots duration:最も古い未公開のスナップショットが存続している期間
- Number files at each level:各レベルにおける異なる列ファミリーのSSTファイルの数
- Ingest SST duration seconds:SSTファイルの取り込みにかかる時間
- Stall conditions changed of each CF:各カラムファミリーの失速条件が変更されました
Raft Engine
- Operations
- write: Raft Engineによる1秒あたりの書き込み操作数
- read_entry: Raft Engineによる1秒あたりのRaftログ読み取り操作数
- read_message: Raft Engineによる1秒あたりのRaftメタデータ読み取り操作の数
- Write duration: Raft Engineによる書き込み操作にかかる時間。この時間は、これらのデータの書き込みに関わるディスクI/Oのレイテンシーの合計値にほぼ相当します。
- Flow
- 書き込み: Raft Engineの書き込みトラフィック
- リライト追加: リライト追加ログのトラフィック
- リライト リライト: リライトのトラフィック リライトログ
- Write Duration Breakdown (99%)
- wal: Raft Engine WAL の書き込みレイテンシー
- 待機: 書き始める前の待ち時間
- apply:メモリにデータを適用するのにかかる時間
- Bytes/Written: Raft Engineが毎回書き込むバイト数
- WAL Duration Breakdown (P99%): Raft Engine WAL 作成の各段階に要した時間
- File Count
- append: Raft Engineがデータ追加に使用するファイルの数
- rewrite: Raft Engineによるデータ書き換えに使用されるファイルの数(rewriteはRocksDBの圧縮に類似しています)
- Entry Count
- rewrite: Raft Engineによって書き換えられたエントリの数
- append: Raft Engineによって追加されたエントリの数
Titan - All
- Blob file count:Titan Blobファイルの数
- Blob file size:Titan Blobファイルの合計サイズ
- Live blob size:有効なブロブレコードの合計サイズ
- Blob cache hit:Titanブロックキャッシュのヒット率
- Iter touched blob file count:単一のイテレータに関係するブロブファイルの数
- Blob file discardable ratio distribution:BLOBファイルのBLOBレコード障害率分布
- Blob key size:Titanブロブキーのサイズ
- Blob value size:Titan Blob値のサイズ
- Blob get operations: Titan Blobにおける取得操作の回数
- Blob get duration:Titan Blobで取得操作を実行する際に消費される時間
- Blob iter operations:Titan Blobでイテレーション操作を実行する際に消費される時間
- Blob seek duration:Titanブロブでシーク操作を実行する際に消費される時間
- Blob next duration: Titan Blob で次の操作を実行する際に消費される時間
- Blob prev duration: Titan blob で prev 操作を実行するのに要した時間
- Blob keys flow:Titanブロブキーに対する操作のフローレート
- Blob bytes flow:Titan Blobキー上のバイトフローレート
- Blob file read duration:Titan Blobファイルの読み取りに要した時間
- Blob file write duration:Titan Blobファイルの書き込みに要した時間
- Blob file sync operations: ブロブファイル同期操作の回数
- Blob file sync duration:Blobファイルの同期にかかる時間
- Blob GC action:Titan GCアクションの回数
- Blob GC duration: Titan GC 期間
- Blob GC keys flow:Titan GCによって読み書きされるキーのフローレート
- Blob GC bytes flow: Titan GC によって読み書きされるバイトのフローレート
- Blob GC input file size:Titan GC入力ファイルのサイズ
- Blob GC output file size:Titan GC出力ファイルのサイズ
- Blob GC file count: Titan GC に関与する Blob ファイルの数
In Memory Engine
次のメトリクスは、 TiKV MVCC インメモリエンジン(IME) に関連しています。
- Ops: 列ファミリーの1秒あたりの操作数
- Read MBps:RocksDBとインメモリエンジンにおける読み取りトラフィックの総バイト数
- Coprocessor Handle duration:コプロセッサリクエストの処理に要する時間
- Region Cache Hit:リージョンキャッシュからデータが正常に取得された回数
- Region Cache Hit Rate:リージョンキャッシュのヒット率
- Region Cache Miss Reason:リージョンキャッシュからデータが取得されない理由
- Memory Usage:インメモリエンジンのメモリ使用量
- Region Count:異なる種類のリージョンの数
- GC Filter:ガベージコレクション(GC)中のフィルタリングプロセスに関する情報
- Region GC Duration:リージョンGCに要した時間
- Region Load Duration:リージョンの読み込みにかかる時間
- Region Load Count:1秒あたりにロードされるリージョンの数
- Region Eviction Duration:リージョンをエビクションするのにかかる時間
- Region Eviction Count:1秒あたりにエビクションされたリージョンの数
- Write duration:リージョンキャッシュエンジンでの書き込み操作にかかる時間
- 99% In-memory engine write duration per server:インメモリエンジンにおけるTiKVサーバーごとの書き込み時間の99パーセンタイル値
- Prepare for write duration:インメモリエンジンで書き込み操作を準備するのに要する時間
- 99% In-memory engine prepare for write duration per server:インメモリエンジンにおけるTiKVサーバーごとの書き込み操作準備に要した時間の99パーセンタイル値
- Iterator operations:イテレータ操作の種類数
- Seek duration:シーク操作に要する時間
- Oldest Auto GC SafePoint:メモリ内エンジンにキャッシュされたリージョンの最古の自動GCセーフポイント
- Newest Auto GC SafePoint:メモリ内エンジンにキャッシュされたリージョン用の最新の自動GCセーフポイント
- Auto GC SafePoint Gap:インメモリエンジンにキャッシュされたリージョンについて、最新の自動GCセーフポイントと最も古い自動GCセーフポイントの間の時間差。
- Auto GC SafePoint Gap With TiKV: インメモリエンジンにキャッシュされたリージョンについて、TiKV の自動 GC セーフポイントと最も古い自動 GC セーフポイントとの間のギャップ。
Pessimistic Locking
- Lock Manager Thread CPU:ロックマネージャスレッドのCPU使用率
- Lock Manager Handled tasks:ロックマネージャが処理したタスクの数
- Waiter lifetime duration:トランザクションがロックを解除するまでの待機時間
- Wait table:待機テーブルの状態情報。ロックの数や、ロックを待っているトランザクションの数などが含まれます。
- Deadlock detect duration:デッドロックを検出するのに要した時間
- Detect error: デッドロック検出時に発生したエラーの数(デッドロックの数を含む)
- Deadlock detector leader: デッドロック検出リーダーが配置されているノードの情報
- Total pessimistic locks memory size:メモリ内の悲観的ロックが占めるメモリサイズ
- In-memory pessimistic locking result:悲観的ロックのみをメモリに保存した結果。
fullは、メモリ制限を超えたために悲観的ロックがメモリに保存されなかった回数を意味します。
Resolved-TS
- Resolved-TS worker CPU:resolved-tsワーカースレッドのCPU使用率
- Advance-TS worker CPU:Advance-TSワーカースレッドのCPU使用率
- Scan lock worker CPU:スキャンロックワーカースレッドのCPU使用率
- Max gap of resolved-ts:このTiKV内のすべてのアクティブ領域のresolved-tsと現在時刻との間の最大時間差
- Max gap of safe-ts: この TiKV 内のすべてのアクティブな領域の安全時刻と現在時刻との間の最大時間差
- Min Resolved TS Region:resolved-tsが最小であるリージョンのID
- Min Safe TS Region:safe-tsが最小であるリージョンのID
- Check Leader Duration:リーダーリクエストの処理に費やされた時間の分布。処理時間は、リクエストの送信からリーダーでの応答の受信までの時間です。
- Max gap of resolved-ts in Region leaders:このTiKV内のすべてのアクティブなリージョンのresolved-tsと現在時刻との間の最大時間差(リージョンリーダーのみ)。
- Min Leader Resolved TS Region:resolved-tsが最小値であるリージョンのID(リージョンリーダーのみ)。
- Lock heap size: resolved-tsモジュールでロックを追跡するヒープのサイズ
Memory
- Allocator Stats:メモリ割り当ての統計情報
Backup
- Backup CPU:バックアップスレッドのCPU使用率
- Range Size:バックアップ範囲サイズのヒストグラム
- Backup Duration:バックアップにかかる時間
- Backup Flow:バックアップの合計バイト数
- Disk Throughput:インスタンスあたりのディスクスループット
- Backup Range Duration:範囲のバックアップにかかる時間
- Backup Errors:バックアップ中に発生したエラーの数
Encryption
- Encryption data keys:暗号化されたデータキーの総数
- Encrypted files:暗号化されたファイルの数
- Encryption initialized: 暗号化が有効になっているかどうかを示します。
1は有効であることを意味します。 - Encryption meta files size:暗号化メタファイルのサイズ
- Encrypt/decrypt data nanos:データの暗号化/復号化にかかる時間のヒストグラム
- Read/write encryption meta duration:暗号化メタファイルの読み書きに要する時間
Log Backup
- Handle Event Rate:書き込みイベントの処理速度
- Initial Scan Generate Event Throughput:新しいリスナーストリームを生成する際の、段階的なスキャン速度
- Abnormal Checkpoint TS Lag:各タスクの現在のcheckpoint TSと現在時刻とのラグ
- Memory Of Events:増分スキャンによって生成された一時データが占めるメモリの推定量
- Observed Region Count:現在視聴されているリージョンの数
- Errors:再試行可能なエラーおよび致命的ではないエラーの数と種類
- Fatal Errors:発生した致命的なエラーの数と種類。通常、致命的なエラーが発生すると、タスクは一時停止します。
- Checkpoint TS of Tasks:各タスクのCheckpoint TS
- Flush Duration:キャッシュされたデータを外部ストレージに移動するのにかかる時間を示すヒートマップ
- Initial Scanning Duration:新しいリスニングストリームを作成する際の増分スキャンにかかる時間を示すヒートマップ
- Convert Raft Event Duration:リスニングストリームを作成した後、 Raftログエントリをバックアップデータに変換するのにかかる時間を示すヒートマップ
- Command Batch Size:リスニング中のRaftコマンドのバッチサイズ(単一のRaftグループ内)
- Save to Temp File Duration:バックアップデータのバッチ(複数のタスクにまたがる)を一時ファイル領域に一時的に保存するのにかかる時間を示すヒートマップ
- Write to Temp File Duration:特定のタスクからのバックアップデータのバッチを一時ファイル領域に一時的に保存するのにかかる時間を示すヒートマップ
- System Write Call Duration:リージョンからバックアップデータのバッチを一時ファイルに書き込むのにかかる時間を示すヒートマップ
- Internal Message Type:TiKV内でログバックアップを担当するアクターが受信するメッセージの種類
- Internal Message Handling Duration (P90|P99):各タイプのメッセージの消費および処理速度
- Initial Scan RocksDB Throughput:増分スキャン中にRocksDB内部ログによって生成される読み取りトラフィック
- Initial Scan RocksDB Operation: 増分スキャン中に RocksDB が内部的にログに記録した個々の操作の数
- Initial Scanning Trigger Reason:増分スキャンを開始する理由
- Region Checkpoint Key Putting: PDに記録されたチェックポイント操作の数
- Request Checkpoint Batch Size:ログバックアップコーディネーターが各TiKVのチェックポイント情報をリクエストする際のリクエストバッチサイズ
- Tick Duration [P99|P90]: コーディネーター内のティックにかかる時間
- Region Checkpoint Failure Reason:リージョンチェックポイントがコーディネーター内で進行できない理由
- Request Result:コーディネーターがリージョンチェックポイントを前進させた際の成功または失敗の記録
- Get Region Operation Count:コーディネーターがPDからリージョン情報をリクエストした回数
- Try Advance Trigger Time:コーディネーターがチェックポイントを進めることを試みるまでにかかる時間
Backup & Import
- Import CPU Utilization:SSTインポーターによって集計されたCPU使用率。
- Import Thread Count:SSTインポーターが使用するスレッドの数。
- Import Errors:SSTインポート中に発生したエラーの数。
- Import RPC Duration:SSTインポーターにおける様々なRPC呼び出しに費やされた時間。
- Import RPC Ops:SSTインポーターにおけるRPC呼び出しの総数。
- Import RPC Count:SSTインポーターによって処理されているRPC呼び出しの数。
- Import Write/Download RPC Duration:SSTインポーターにおける書き込みまたはダウンロード操作のRPC時間。
- Import Wait Duration:ダウンロードタスクの実行待ち時間。
- Import Read SST Duration:外部ストレージからSSTファイルを読み込み、TiKVにダウンロードするのに要した時間。
- Import Rewrite SST Duration:書き換えルールに基づいてSSTファイルを書き換えるのに要した時間。
- Import Ingest RPC Duration:TiKV上で取り込みRPCリクエストを処理するのに費やされた時間。
- Import Ingest SST Duration:SSTファイルをRocksDBに取り込むのに要した時間。
- Import Ingest SST Bytes:取り込まれたバイト数。
- Import Download SST Throughput:SSTのダウンロードスループット(バイト/秒)。
- cloud request:クラウドプロバイダーへのリクエスト数。
Point In Time Restore
- CPU Usage:ポイントインタイムリカバリ(PITR)によるCPU使用率。
- P99 RPC Duration:RPCリクエスト期間の99パーセンタイル値。
- Import RPC Ops:SSTインポーターにおけるRPC呼び出しの総数。
- Import RPC Count:SSTインポーターによって処理されているRPC呼び出しの数。
- Cache Events:SSTインポート中にファイルキャッシュに保存されたイベントの数。
- Overall RPC Duration:RPC呼び出しに費やされた時間。
- Read File into Memory Duration: 外部ストレージからファイルをダウンロードしてメモリに読み込むのにかかる時間。
- Queuing Time:スレッドにスケジュールされるのを待つ時間。
- Apply Request Throughput:リクエストを適用する速度(バイト単位)。
- Downloaded File Size:ダウンロードされたファイルのサイズ(バイト単位)。
- Apply Batch Size:1回のバッチでRaftストアに適用するバイト数。
- Blocked by Concurrency Time:並行処理の制約により実行を待機するのに費やされた時間。
- Apply Request Speed: Raftストアへのリクエスト適用速度。
- Cached File in Memory:SSTインポーターのリクエストによってキャッシュされたファイル。
- Engine Requests Unfinished: Raftストアへの保留中のリクエスト数。
- Apply Time: Raftストアにデータを書き込むのに費やされた時間。
- Raft Store Memory Usage: Raftストアのメモリ使用量。
共通パラメータの説明
gRPC Message Type
トランザクションAPI:
- kv_get:
tsで指定された最新バージョンのデータを取得するコマンド - kv_scan: データ範囲をスキャンするコマンド
- kv_prewrite: 2PCの第1フェーズでコミットするデータを事前に書き込むコマンド
- kv_pessimistic_lock: キーに悲観的ロックを追加して、他のトランザクションがこのキーを変更するのを防ぐコマンド。
- kv_pessimistic_rollback: キーの悲観的ロックを削除するコマンド
- kv_txn_heart_beat:悲観的トランザクションまたは大規模トランザクションのロールバックを防ぐために、
lock_ttlを更新するコマンド。 - kv_check_txn_status: トランザクションのステータスを確認するコマンド
- kv_commit: prewriteコマンドによって書き込まれたデータをコミットするコマンド
- kv_cleanup: トランザクションをロールバックするコマンド。v4.0で非推奨になりました。
- kv_batch_get:
kv_getと同様に、バッチキーの値を一度に取得するコマンドです。 - kv_batch_rollback: 複数のプリライトトランザクションのバッチロールバックコマンド
- kv_scan_lock: 期限切れのトランザクションをクリーンアップするために、バージョン番号が
max_versionより前のすべてのロックをスキャンするコマンド - kv_resolve_lock: トランザクションの状態に応じて、トランザクションロックをコミットまたはロールバックするコマンド。
- kv_gc: GCのコマンド
- kv_delete_range: TiKVからデータ範囲を削除するコマンド
- kv_get:
生のAPI:
- raw_get: キーの値を取得するコマンド
- raw_batch_get: バッチキーの値を取得するコマンド
- raw_scan: データ範囲をスキャンするコマンド
- raw_batch_scan: 連続する複数のデータ範囲をスキャンするコマンド
- raw_put: キー/値ペアを書き込むコマンド
- raw_batch_put: キーと値のペアのバッチを書き込むコマンド
- raw_delete: キー/値ペアを削除するコマンド
- raw_batch_delete: キーと値のペアのバッチを削除するコマンド
- raw_delete_range: データ範囲を削除するコマンド
TiKV-FastTuneダッシュボード
TiKVのパフォーマンスに関する問題(QPSジッター、レイテンシージッター、レイテンシー増加傾向など)が発生した場合は、 TiKV-FastTuneダッシュボードを確認してください。このダッシュボードには、特にクラスタ内の書き込みワークロードが中規模または大規模の場合に、診断に役立つ一連のパネルが含まれています。
書き込み関連のパフォーマンス問題が発生した場合は、まずTiDB関連のダッシュボードを確認してください。ストレージ側に問題がある場合は、 TiKV-FastTuneページを開き、すべてのパネルを確認してください。
TiKV-FastTuneのダッシュボードには、パフォーマンス問題の考えられる原因を示すタイトルが表示されます。提示された原因が正しいかどうかを確認するには、ページ上のグラフを確認してください。
グラフの左側のY軸はストレージ側の書き込みRPC QPSを表し、右側のY軸上のグラフは上下反転して描かれています。左側のグラフの形状が右側のグラフの形状と一致する場合、示唆された原因は正しいと言えます。
詳細なメトリクスと説明については、ダッシュボードユーザーマニュアルを参照してください。