PDの主要なモニタリング指標
TiUPを使用してTiDBクラスターをデプロイする場合、監視システム(PrometheusとGrafana)も同時にデプロイされます。詳細については、 監視フレームワークの概要を参照してください。
Grafanaダッシュボードは、Overview、PD、TiDB、TiKV、Node_exporter、Disk Performance、Performance_overviewといった一連のサブダッシュボードに分かれています。診断に役立つ多くの指標が用意されています。
PDダッシュボードでは、コンポーネントのPDステータスの概要と主要な指標を確認できます。このドキュメントでは、これらの主要な指標について詳しく説明します。
PD ダッシュボード メトリック項目の説明は次のとおりです。
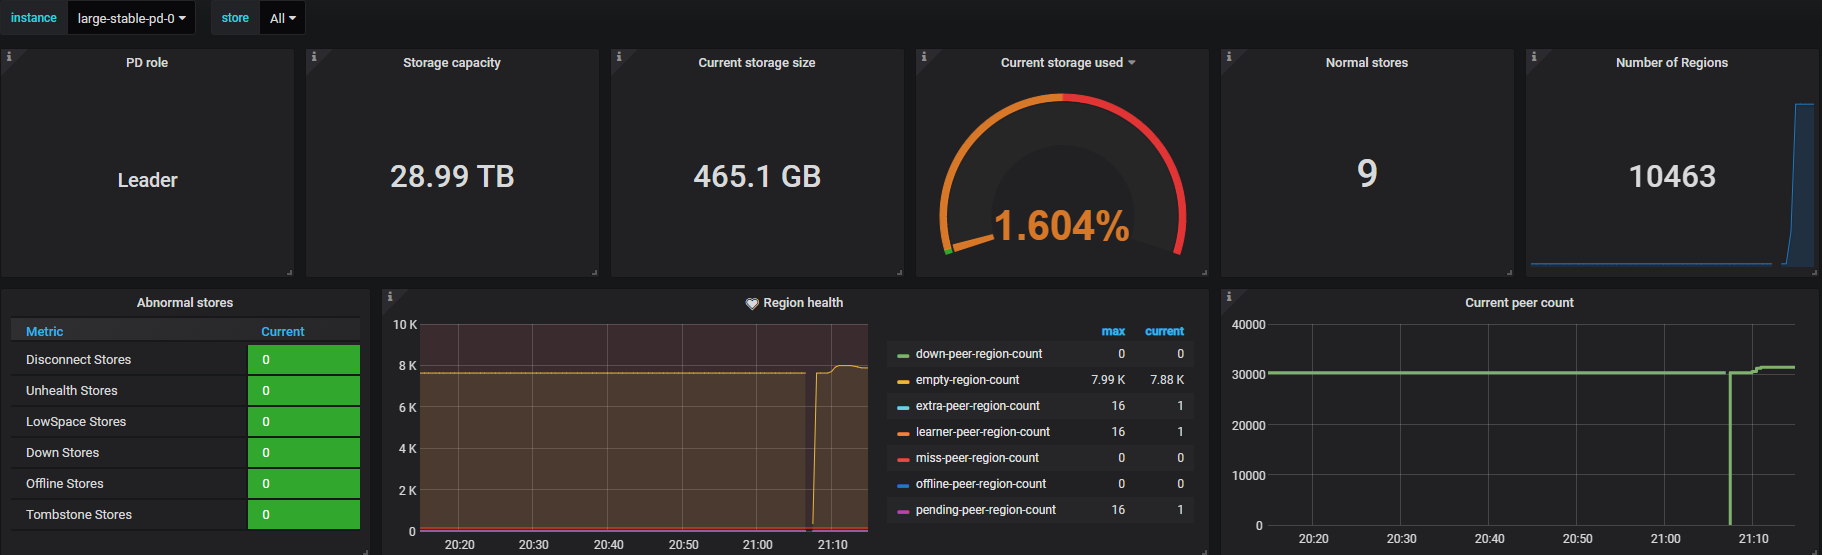
- PD role: 現在のPDインスタンスのロール
- Storage capacity: この TiDB クラスターの合計ストレージ容量
- Current storage size: TiDB クラスターで現在使用されているストレージサイズ
- Current storage usage: 現在のストレージ使用率
- Normal stores: 正常なストレージインスタンスの数
- Number of Regions: クラスターリージョンの総数
- Abnormal stores: 不健全なストアの数。正常値は
0です。この数値が0より大きい場合、少なくとも 1つのインスタンスが異常であることを意味します。 - Region health: 保留中のピア、ダウン中のピア、余分なピア、オフラインのピア、欠落しているピア、学習中のピア、不正な名前空間など、異常なリージョンの数でリージョンの健全性を示します。通常、保留中のピアの数は
100未満である必要があります。欠落しているピアの数が持続的に0を超えてはなりません。空のリージョンが多数存在する場合は、リージョンマージを適時に有効化してください。 - Current peer count: すべてのクラスタピアの現在の数
主要な指標の説明
Cluster
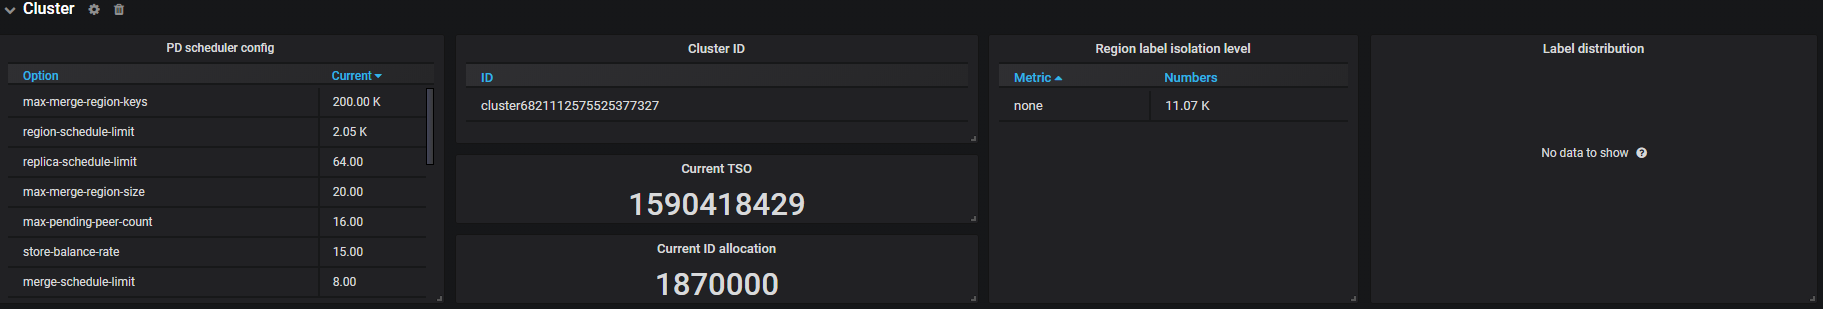
- PD scheduler config: PDスケジューラ設定のリスト
- Cluster ID: クラスターの一意の識別子
- Current TSO: 現在割り当てられているTSOの物理部分
- Current ID allocation: 新しいストア/ピアに割り当てられる最大ID
- Region label isolation level: 異なるラベルレベルのリージョン数
- Label distribution: クラスタ内のラベルの配布状態
- Store Limit: ストアでのスケジュールのフロー制御制限
Operator
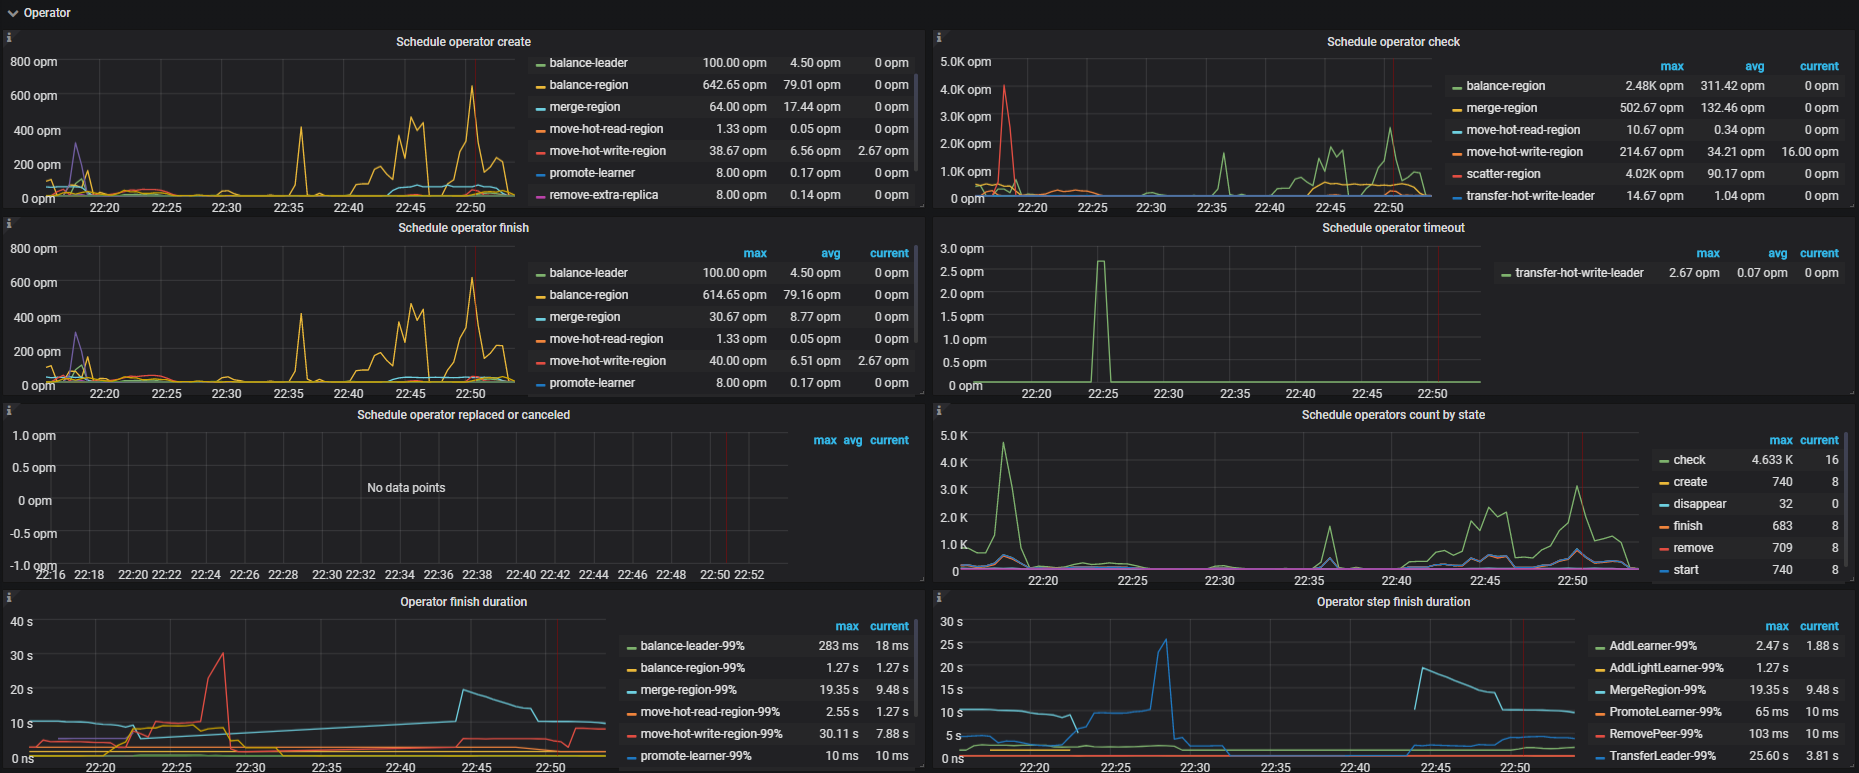
- Schedule operator create: タイプごとに新しく作成されるオペレーターの数
- Schedule operator check: 種類ごとにチェックされるオペレーターの数。主に現在のステップが完了したかどうかをチェックし、完了している場合は次に実行するステップを返します。
- Schedule operator finish: タイプごとに終了したオペレーターの数
- Schedule operator timeout: タイプごとのタイムアウトオペレーターの数
- Schedule operator replaced or canceled: タイプごとに交代またはキャンセルされたオペレーターの数
- Schedule operators count by state: 状態ごとのオペレーター数
- Operator finish duration: 終了したオペレーターの最大時間
- Operator step duration: 完了したオペレーターステップの最大所要時間
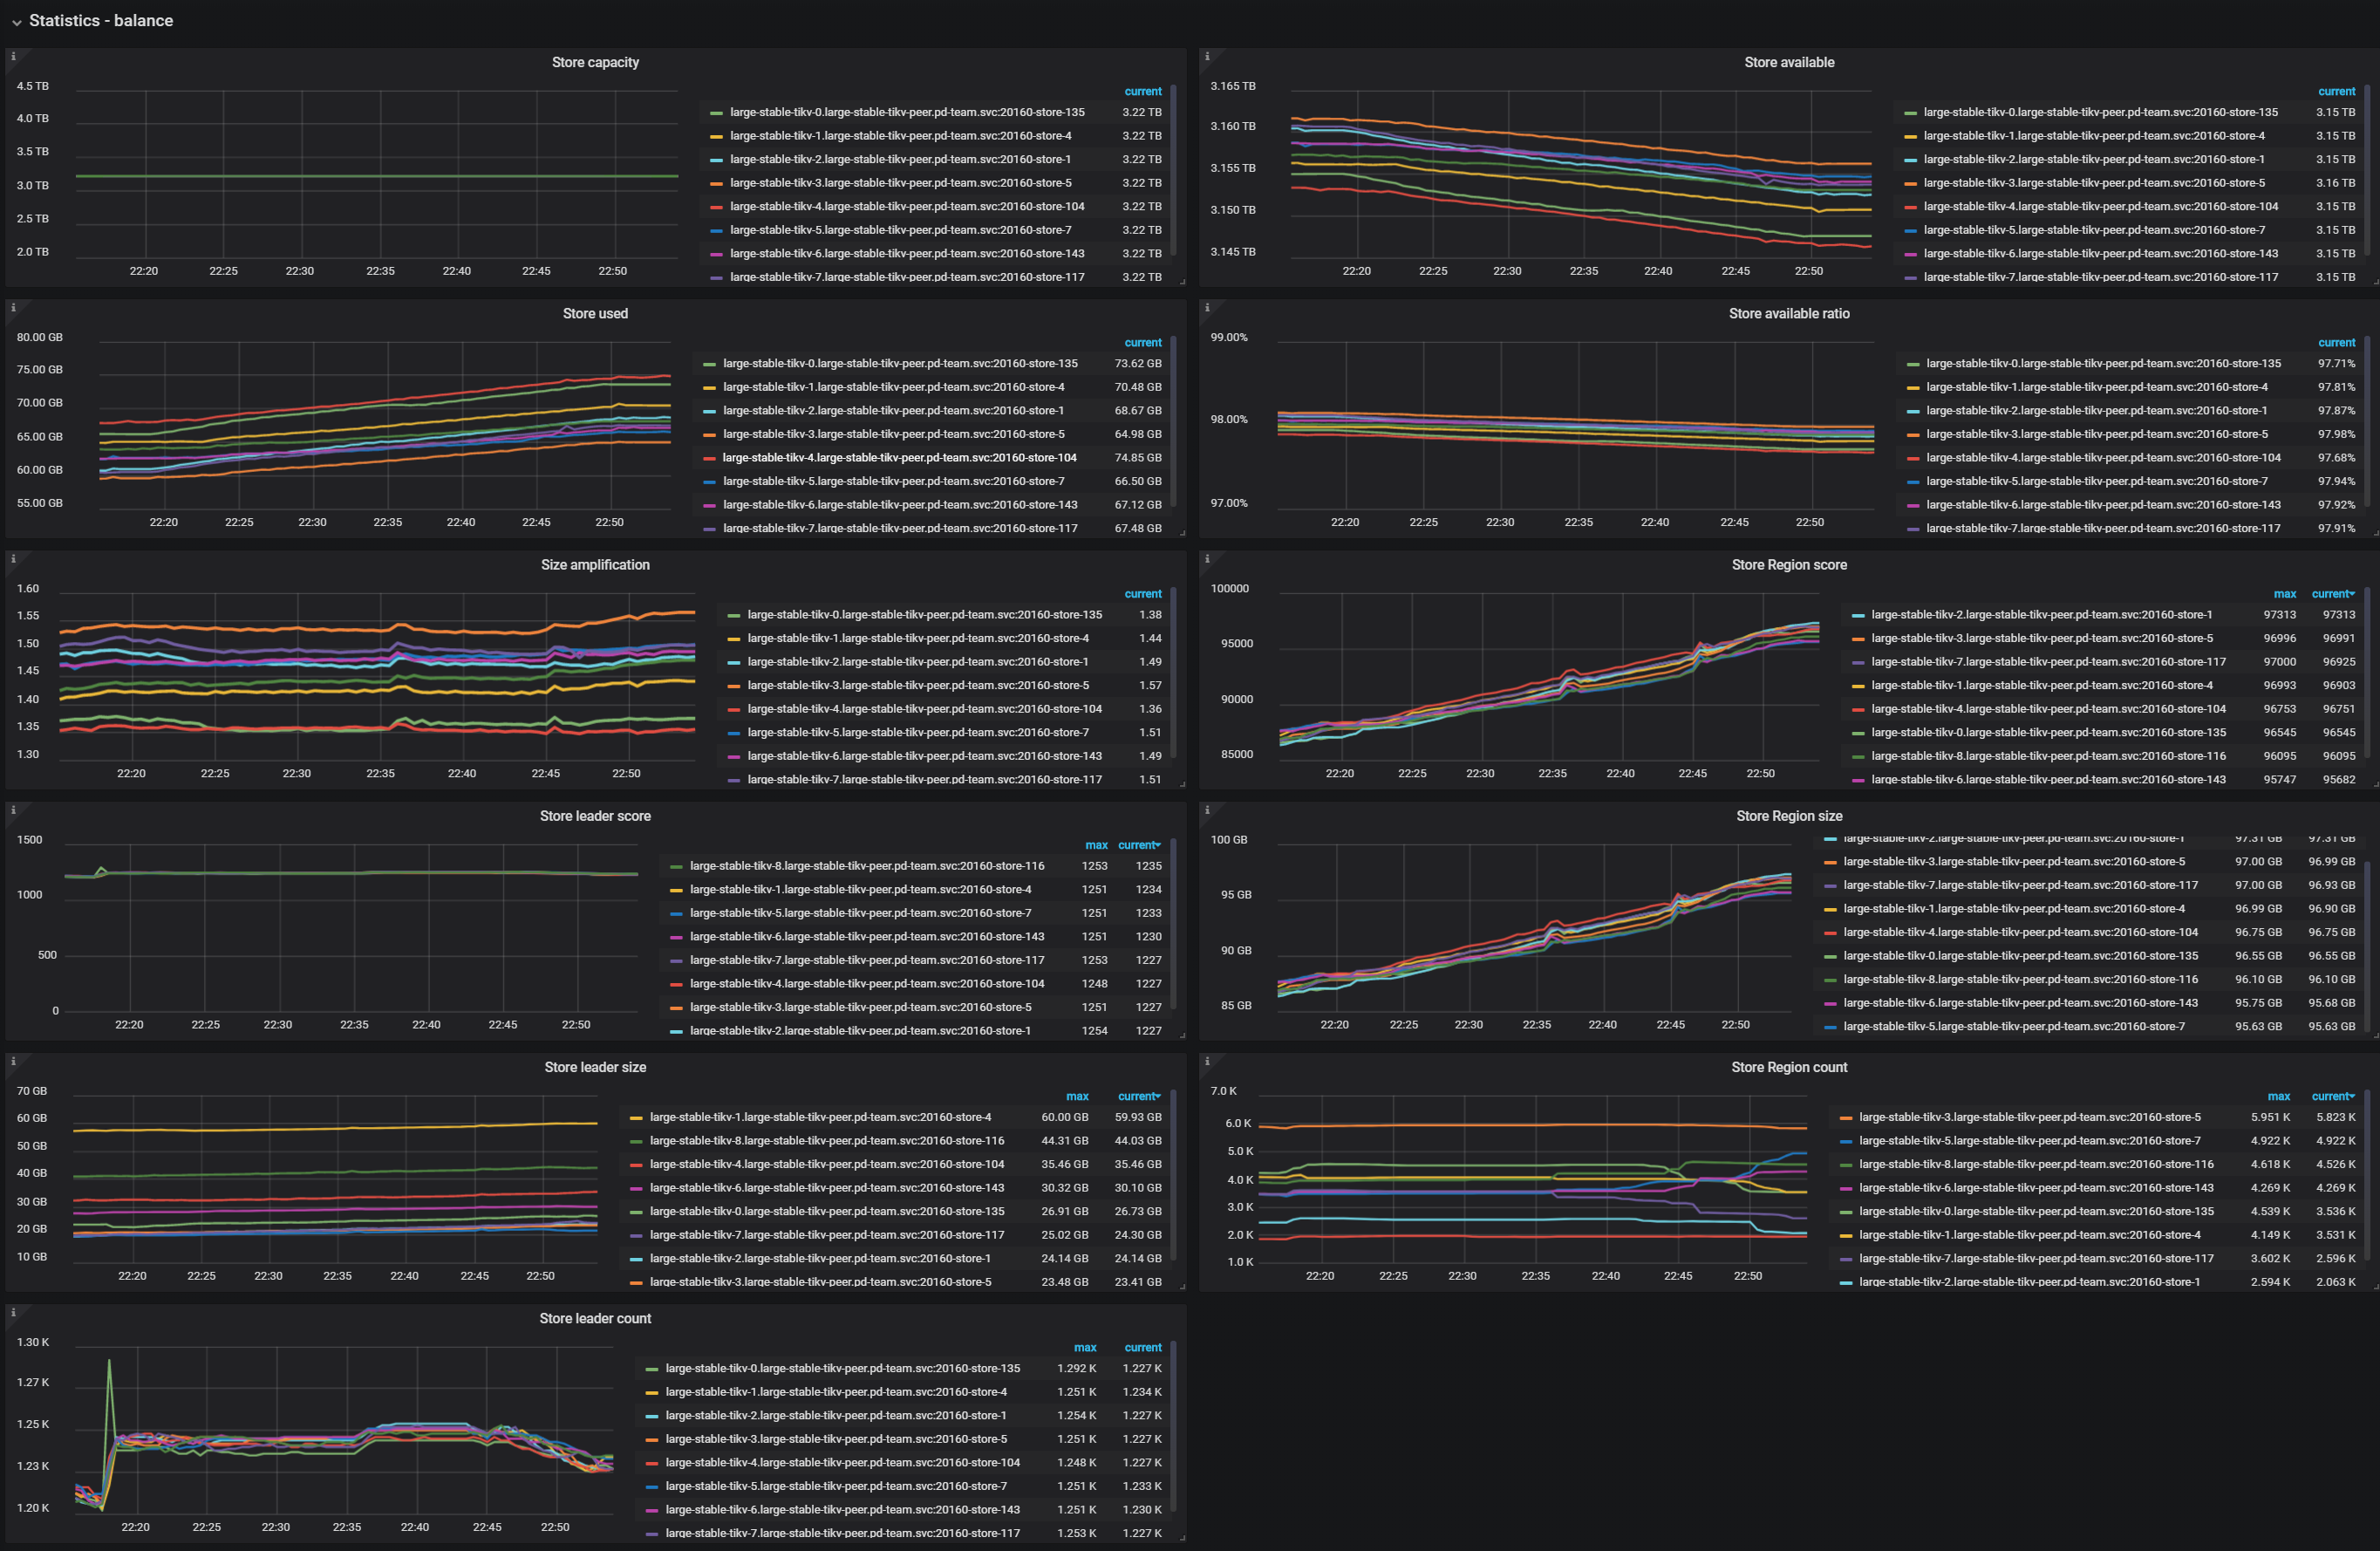
Statistics - Balance
- Store capacity: TiKVインスタンスあたりの容量サイズ
- Store available: TiKVインスタンスあたりの利用可能な容量サイズ
- Store used: TiKVインスタンスごとの使用済み容量サイズ
- Size amplification: TiKVインスタンスあたりのサイズ増幅率。これは、(Store Region size)/(Store used capacity size)に等しくなります。
- Size available ratio: TiKVインスタンスあたりの利用可能なサイズ比率。これは、(Store available capacity size)/(Store capacity size)に等しくなります。
- Store leader score: TiKVインスタンスごとのリーダースコア
- Store Region score: TiKVインスタンスごとのリージョンスコア
- Store leader size: TiKVインスタンスあたりのリーダーサイズの合計
- Store Region size: TiKVインスタンスあたりのリージョンサイズの合計
- Store leader count: TiKVインスタンスあたりのリーダー数
- Store Region count: TiKVインスタンスあたりのリージョン数
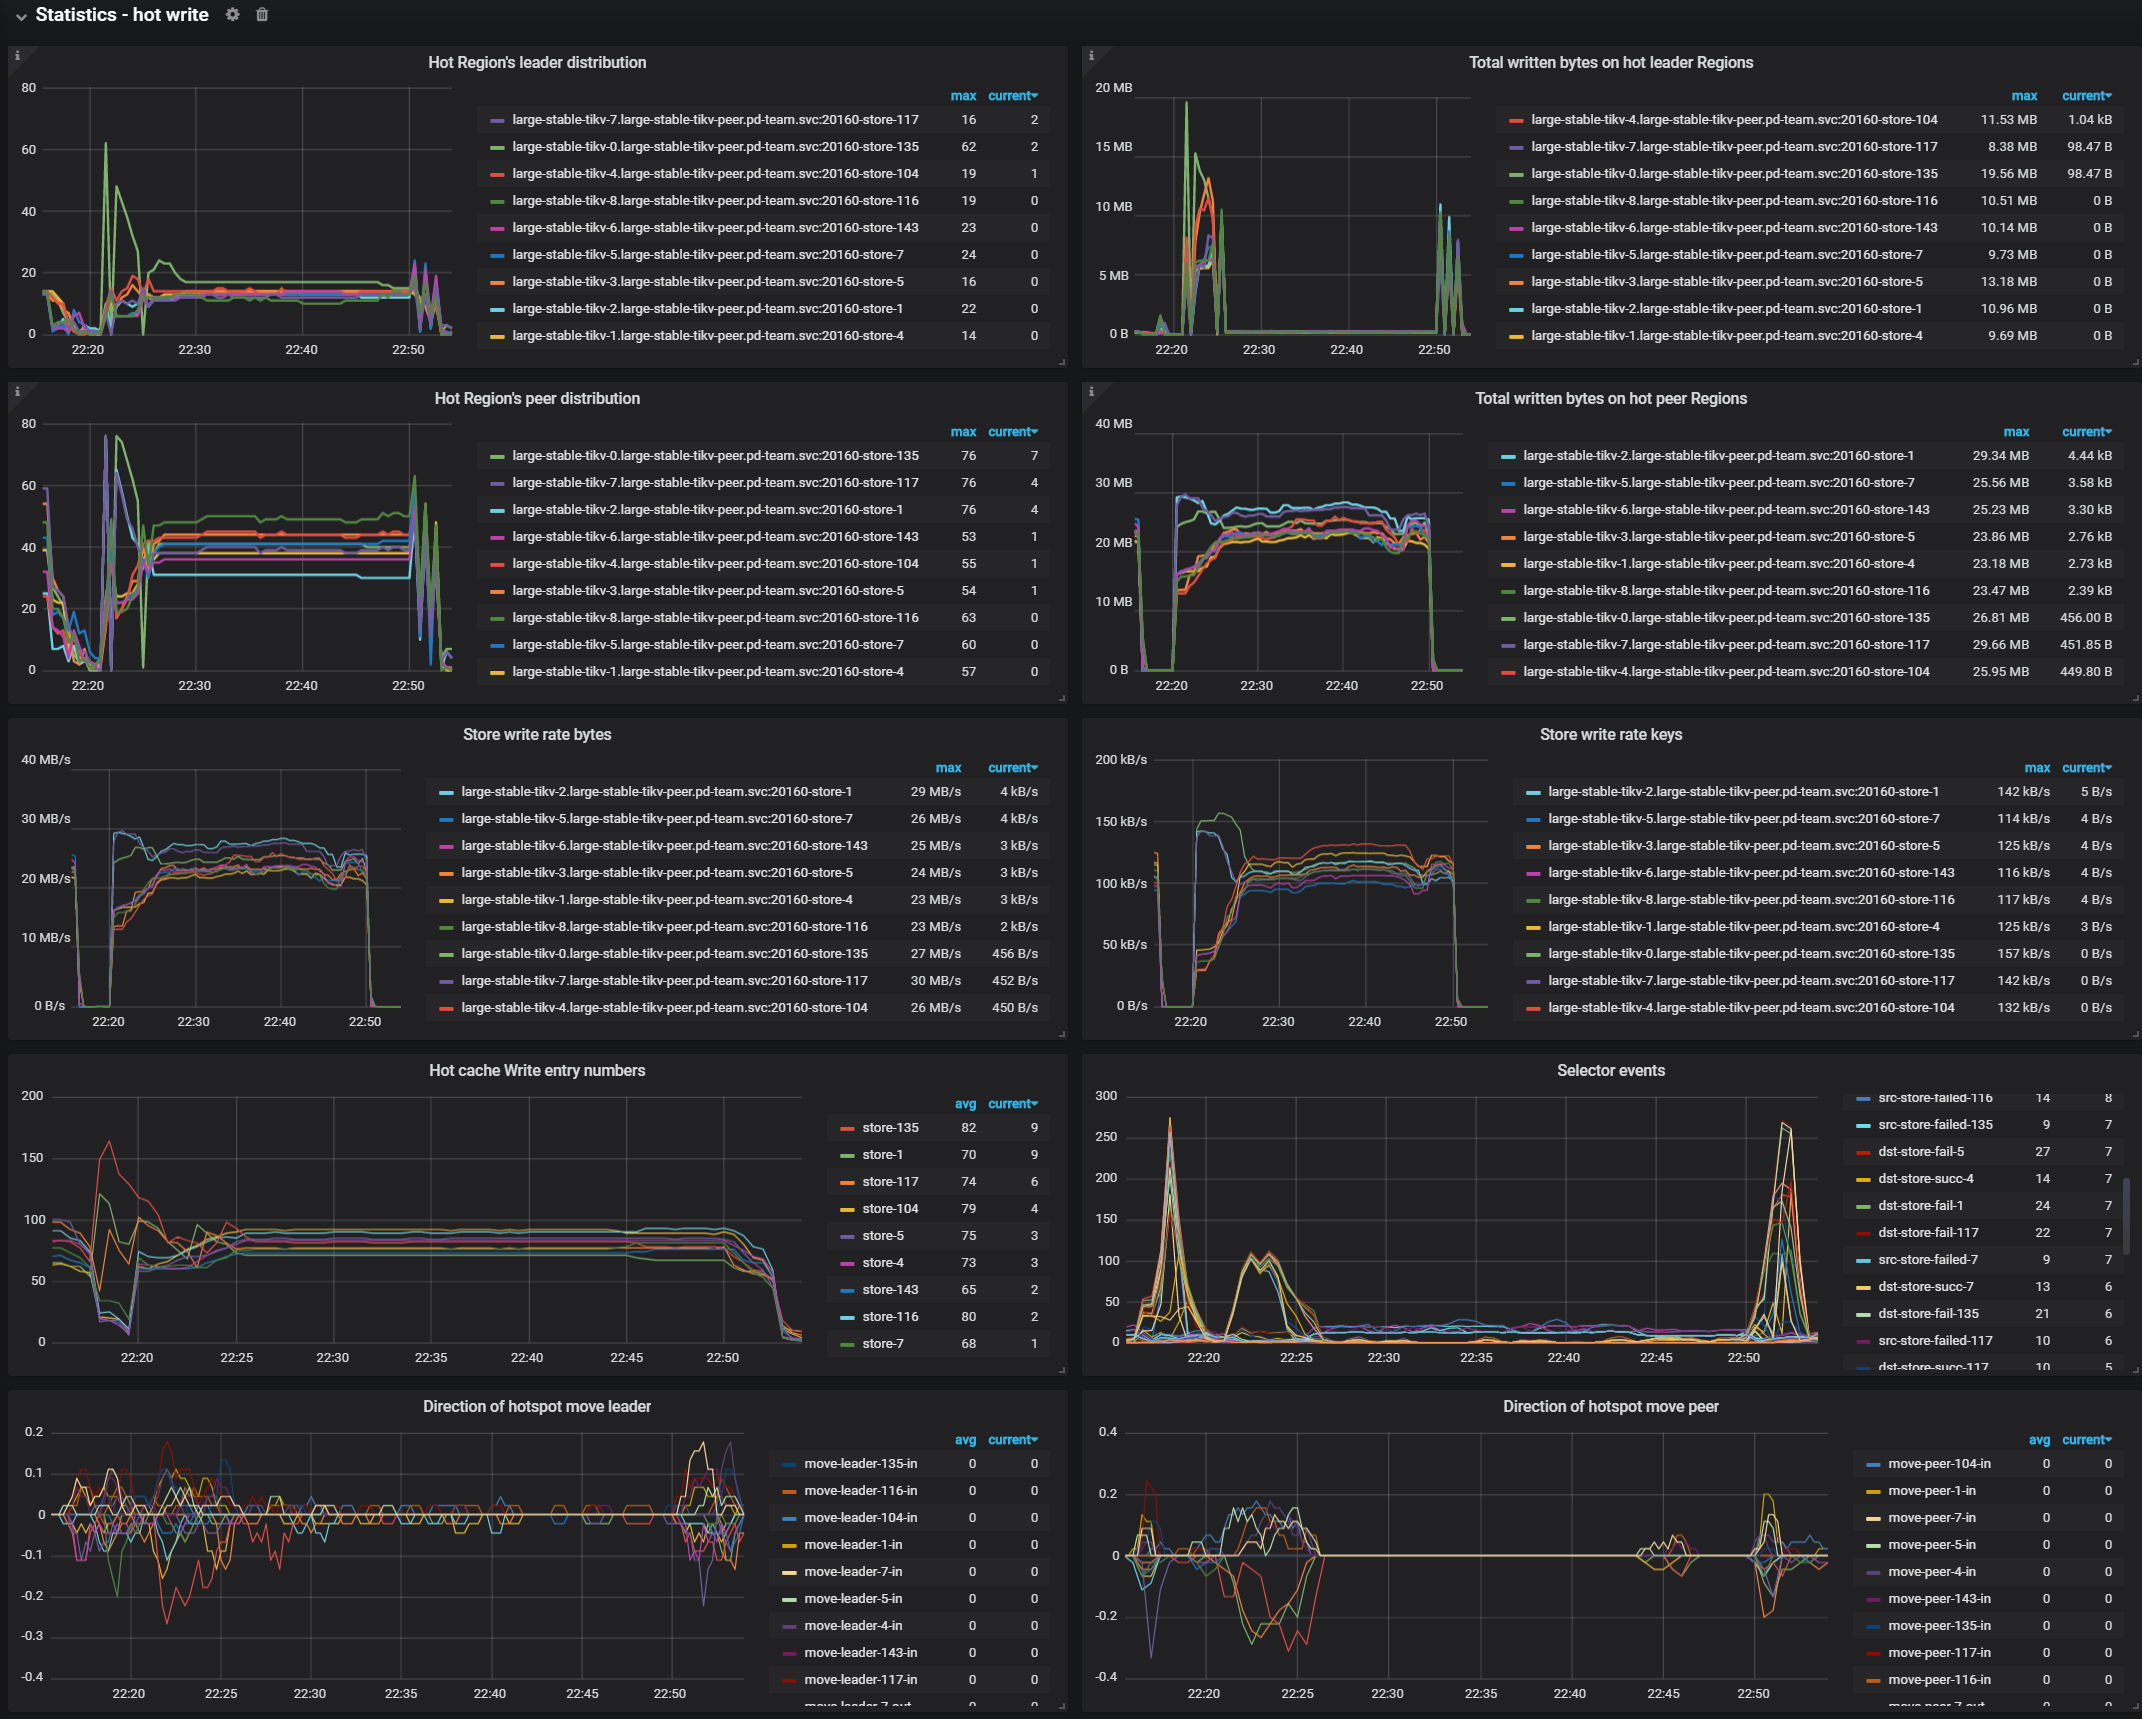
Statistics - hot write
- Hot Region's leader distribution: 各 TiKV インスタンスで書き込みホットスポットとなったリーダーリージョンの合計数
- Total written bytes on hot leader Regions: 各 TiKV インスタンスで書き込みホットスポットとなったリーダーリージョンによる合計書き込みバイト数
- Hot write Region's peer distribution: 各 TiKV インスタンスで書き込みホットスポットとなったピアリージョンの合計数
- Total written bytes on hot peer Regions: 各 TiKV インスタンスで書き込みホットスポットとなったすべてのピアリージョンの書き込みバイト数
- Store Write rate bytes: 各 TiKV インスタンスに書き込まれた合計バイト数
- Store Write rate keys: 各 TiKV インスタンスに書き込まれたキーの合計
- Hot cache write entry number: 書き込みホットスポット統計モジュールにある各 TiKV インスタンス上のピアの数
- Selector events: ホットスポットスケジューリングモジュールのセレクタのイベント数
- Direction of hotspot move leader: ホットスポットスケジューリングにおけるリーダーの移動方向。正の数値はインスタンスへのスケジューリングを意味し、負の数値はインスタンスからのスケジューリングを意味します。
- Direction of hotspot move peer: ホットスポットスケジューリングにおけるピアの移動方向。正の数値はインスタンスへのスケジューリングを意味し、負の数値はインスタンスからのスケジューリングを意味します。
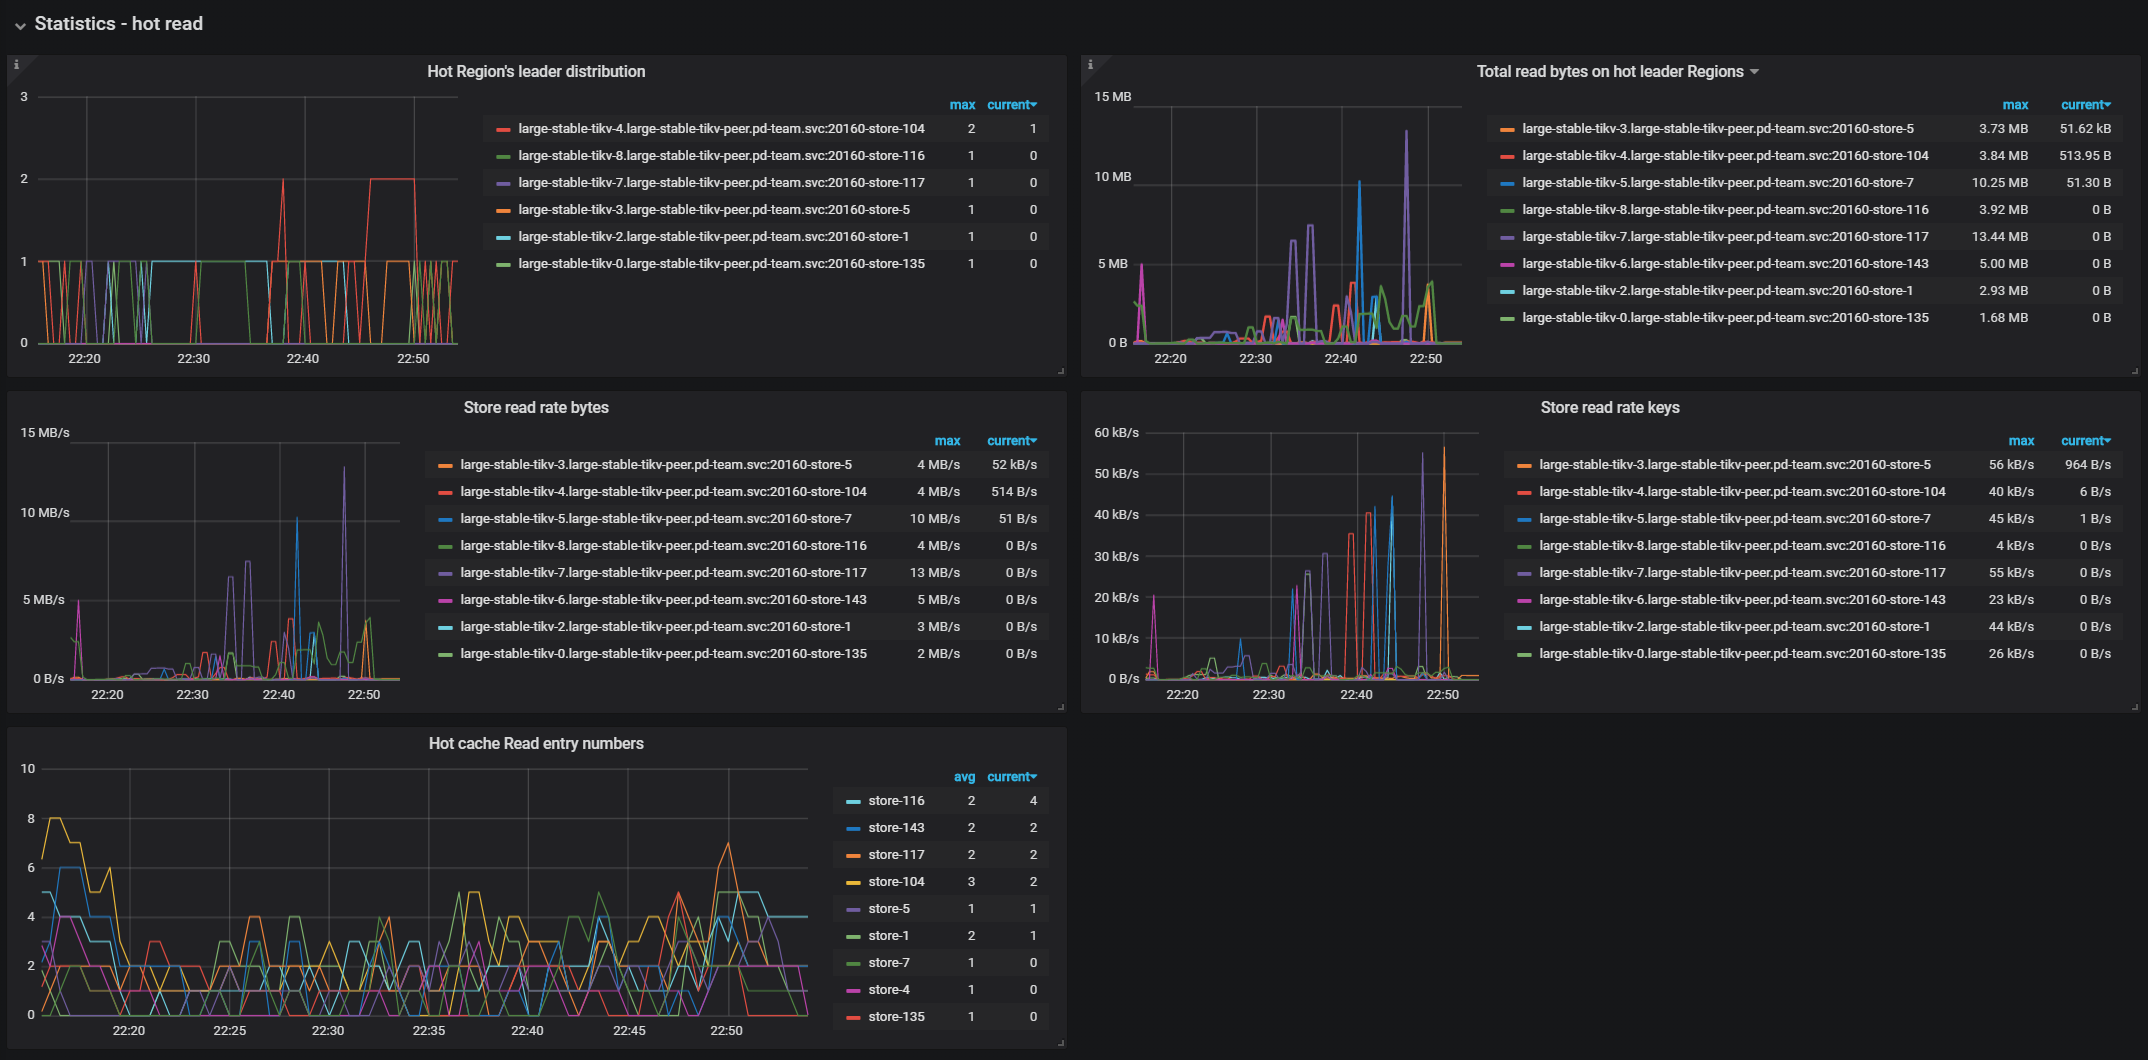
Statistics - hot read
- Hot Region's peer distribution: 各 TiKV インスタンスで読み取りホットスポットとなったピアリージョンの合計数
- Total read bytes on hot peer Regions: 各 TiKV インスタンスで読み取りホットスポットとなったピアの合計読み取りバイト数
- Store read rate bytes: 各 TiKV インスタンスの合計読み取りバイト数
- Store read rate keys: 各 TiKV インスタンスの合計読み取りキー
- Store read cpu: 各 TiKV インスタンスの読み取り CPU 使用率。PD は v8.5.7 以降、このメトリクスを CPU 対応の読み取りホットスポットスケジューリングに使用します。
- Hot cache read entry number: 各 TiKV インスタンスの読み取りホットスポット統計モジュールにあるピアの数
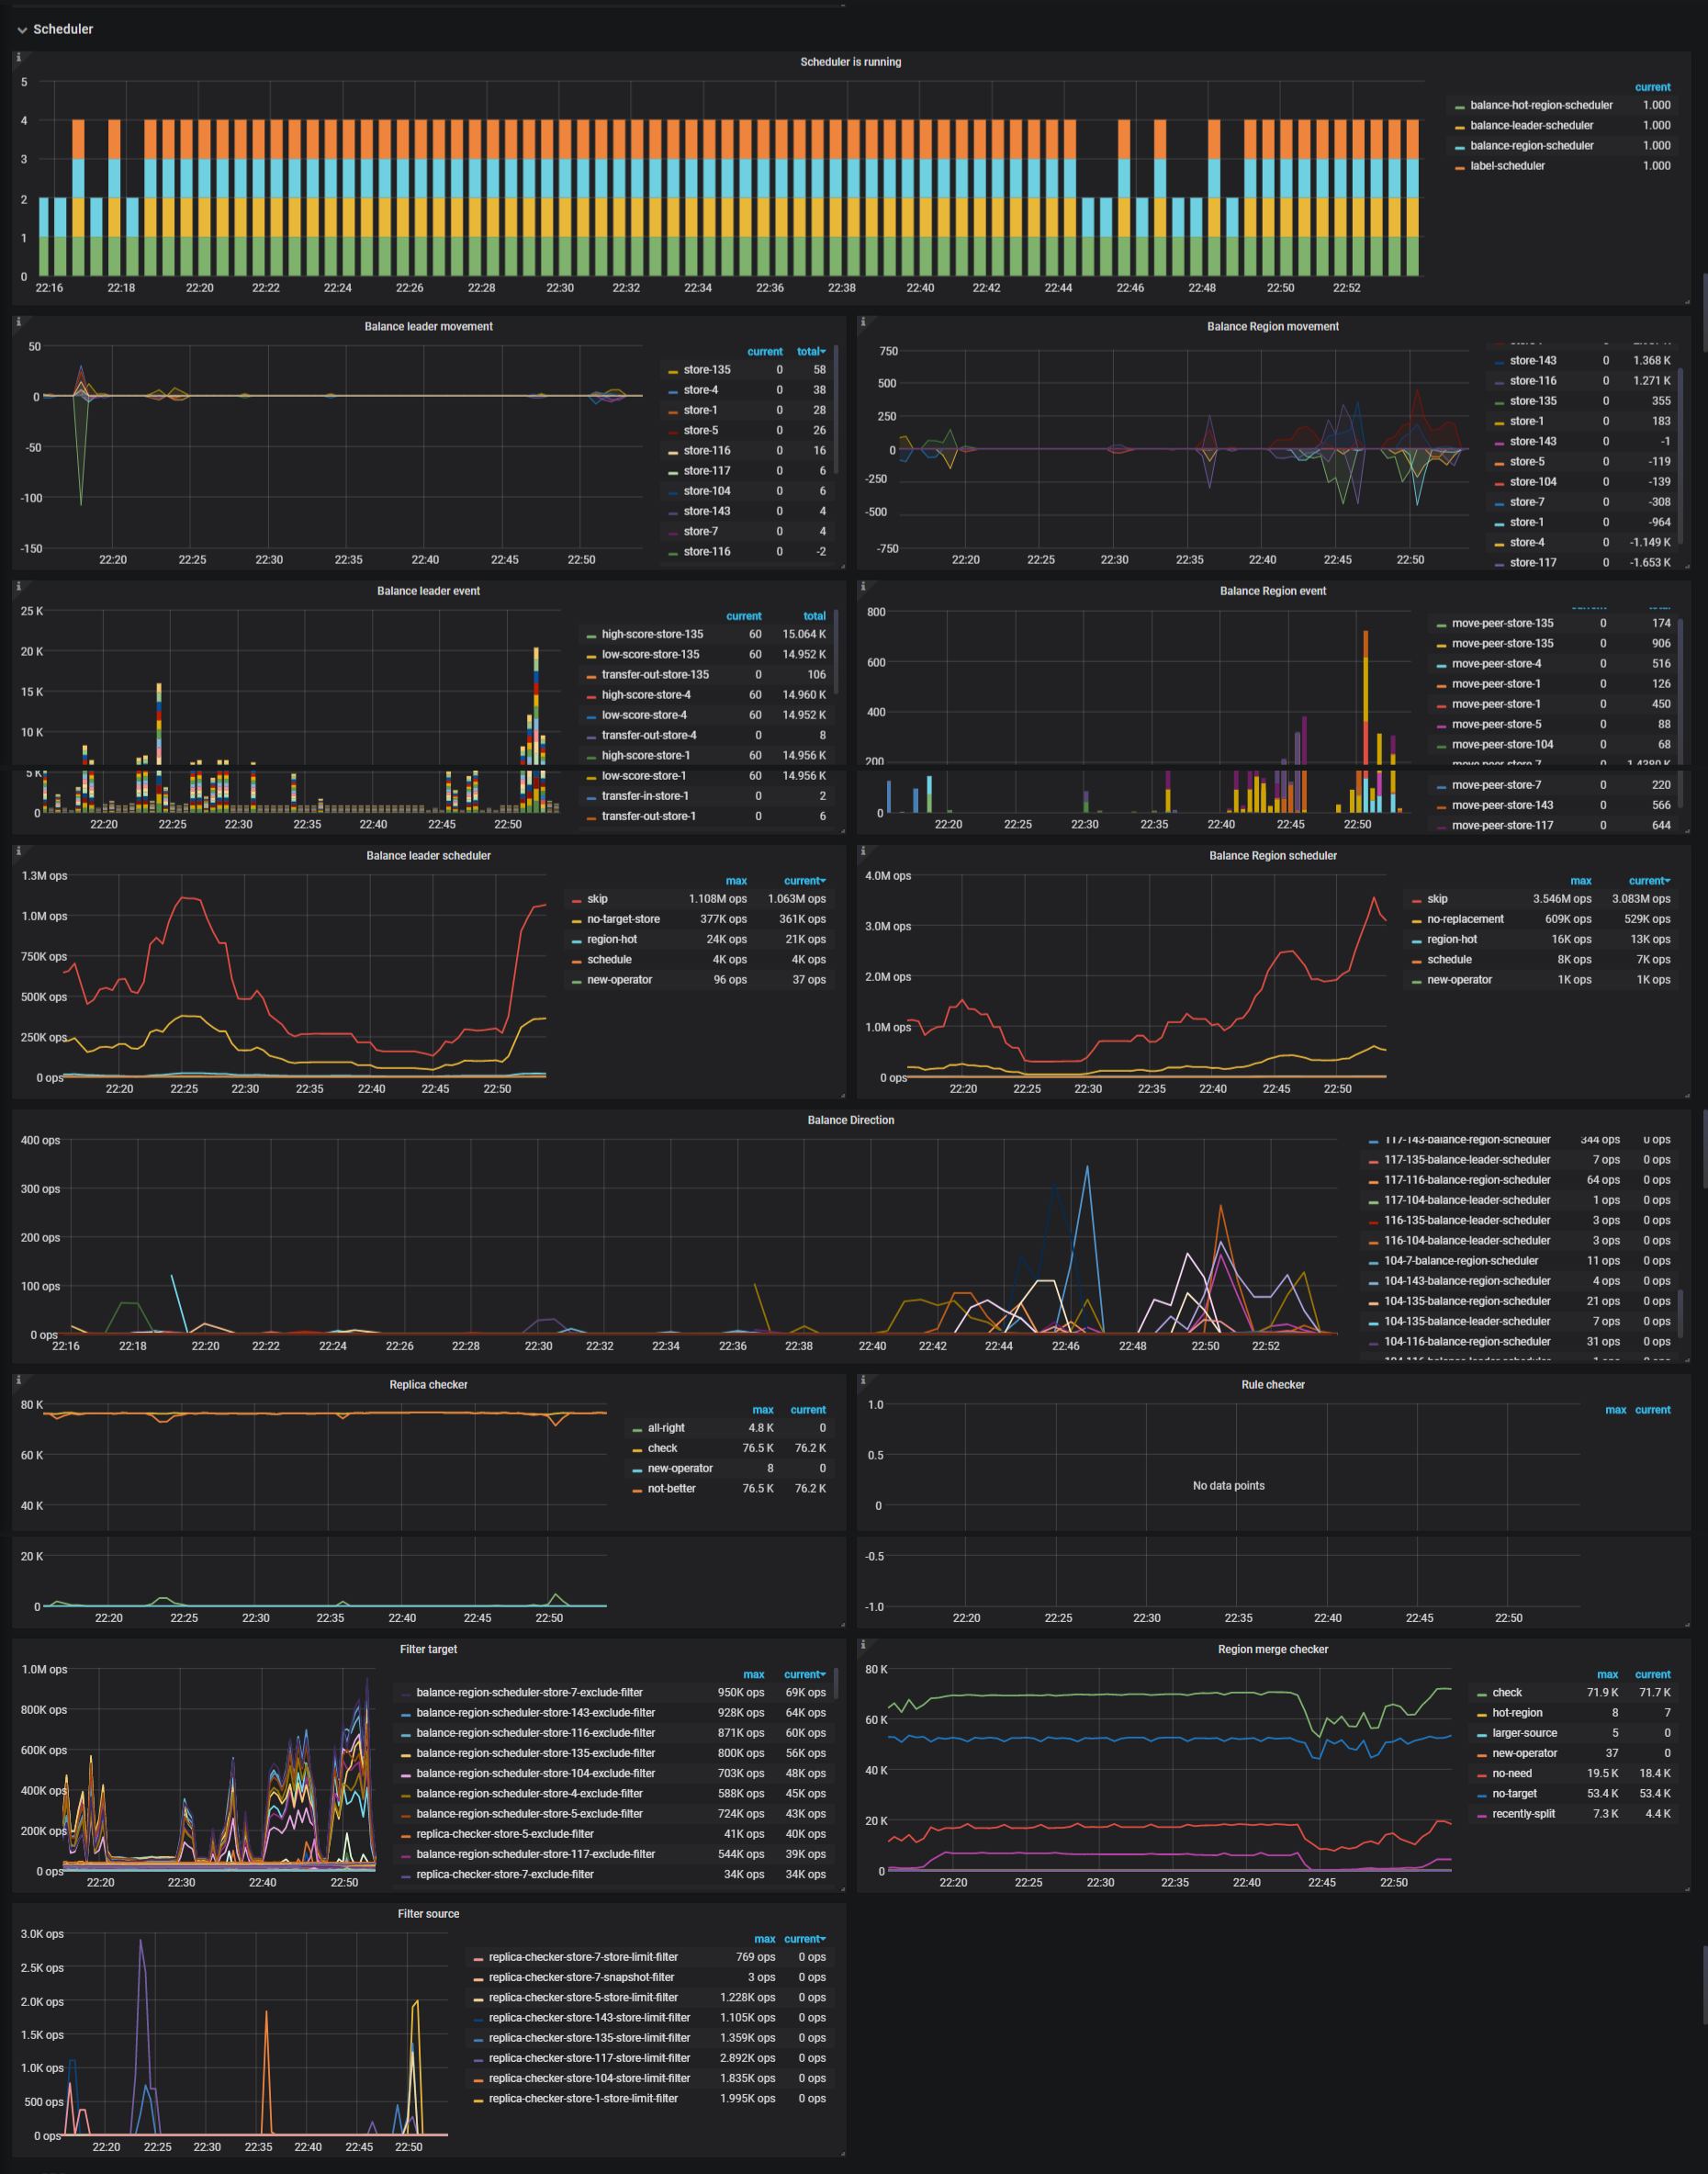
Scheduler
- Scheduler is running: 現在実行中のスケジューラ
- Balance leader movement: TiKVインスタンス間のリーダーの移動の詳細
- Balance Region movement: TiKVインスタンス間のリージョン移動の詳細
- Balance leader event:バランスリーダーイベントの数
- Balance Region event: バランスリージョンイベントの数
- Balance leader scheduler: バランスリーダースケジューラの内部状態
- Balance Region scheduler: バランスリージョンスケジューラの内部状態
- Replica checker:レプリカチェッカーのステータス
- Rule checker: ルールチェッカーのステータス
- Region merge checker: マージチェッカーのステータス
- Filter target: ストアがスケジュールターゲットとして選択されたが、フィルターを通過できなかった試行回数
- Filter source: ストアがスケジュールソースとして選択されたが、フィルターを通過できなかった試行回数
- Balance Direction: ストアがスケジュールの対象またはソースとして選択された回数
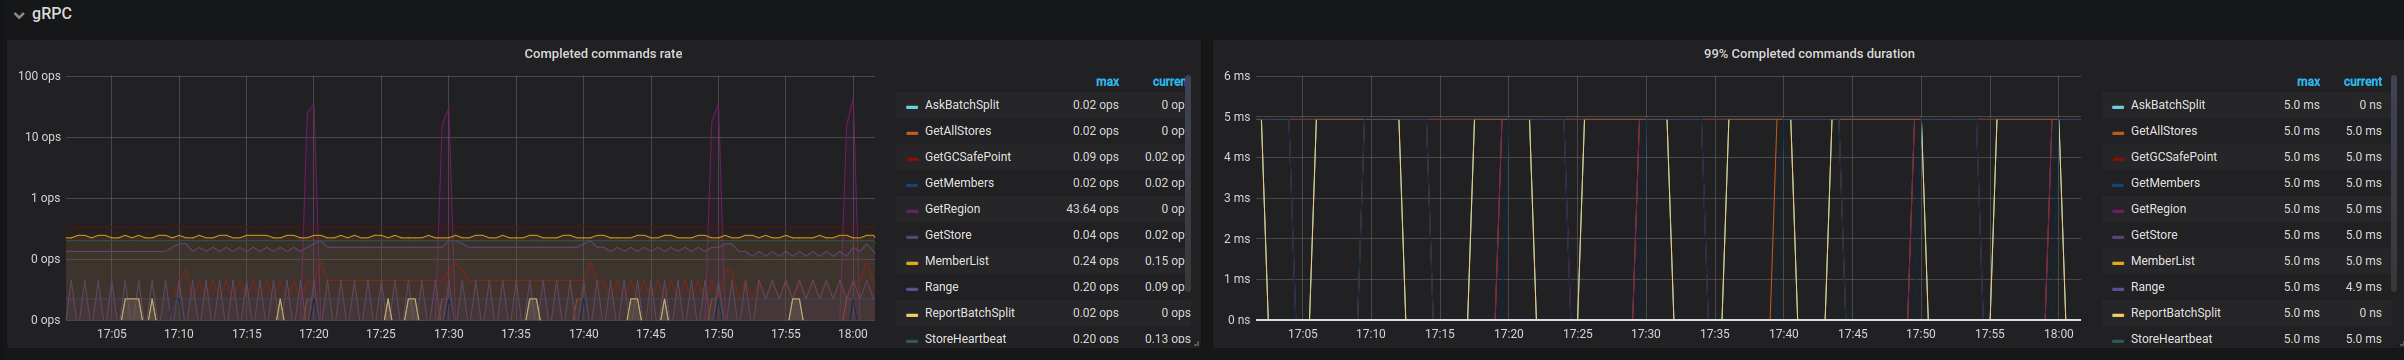
gRPC
- Completed commands rate: gRPC コマンドが完了するコマンド タイプごとの率
- 99% Completed commands duration: gRPC コマンドが完了するコマンド タイプごとの所要時間 (P99)
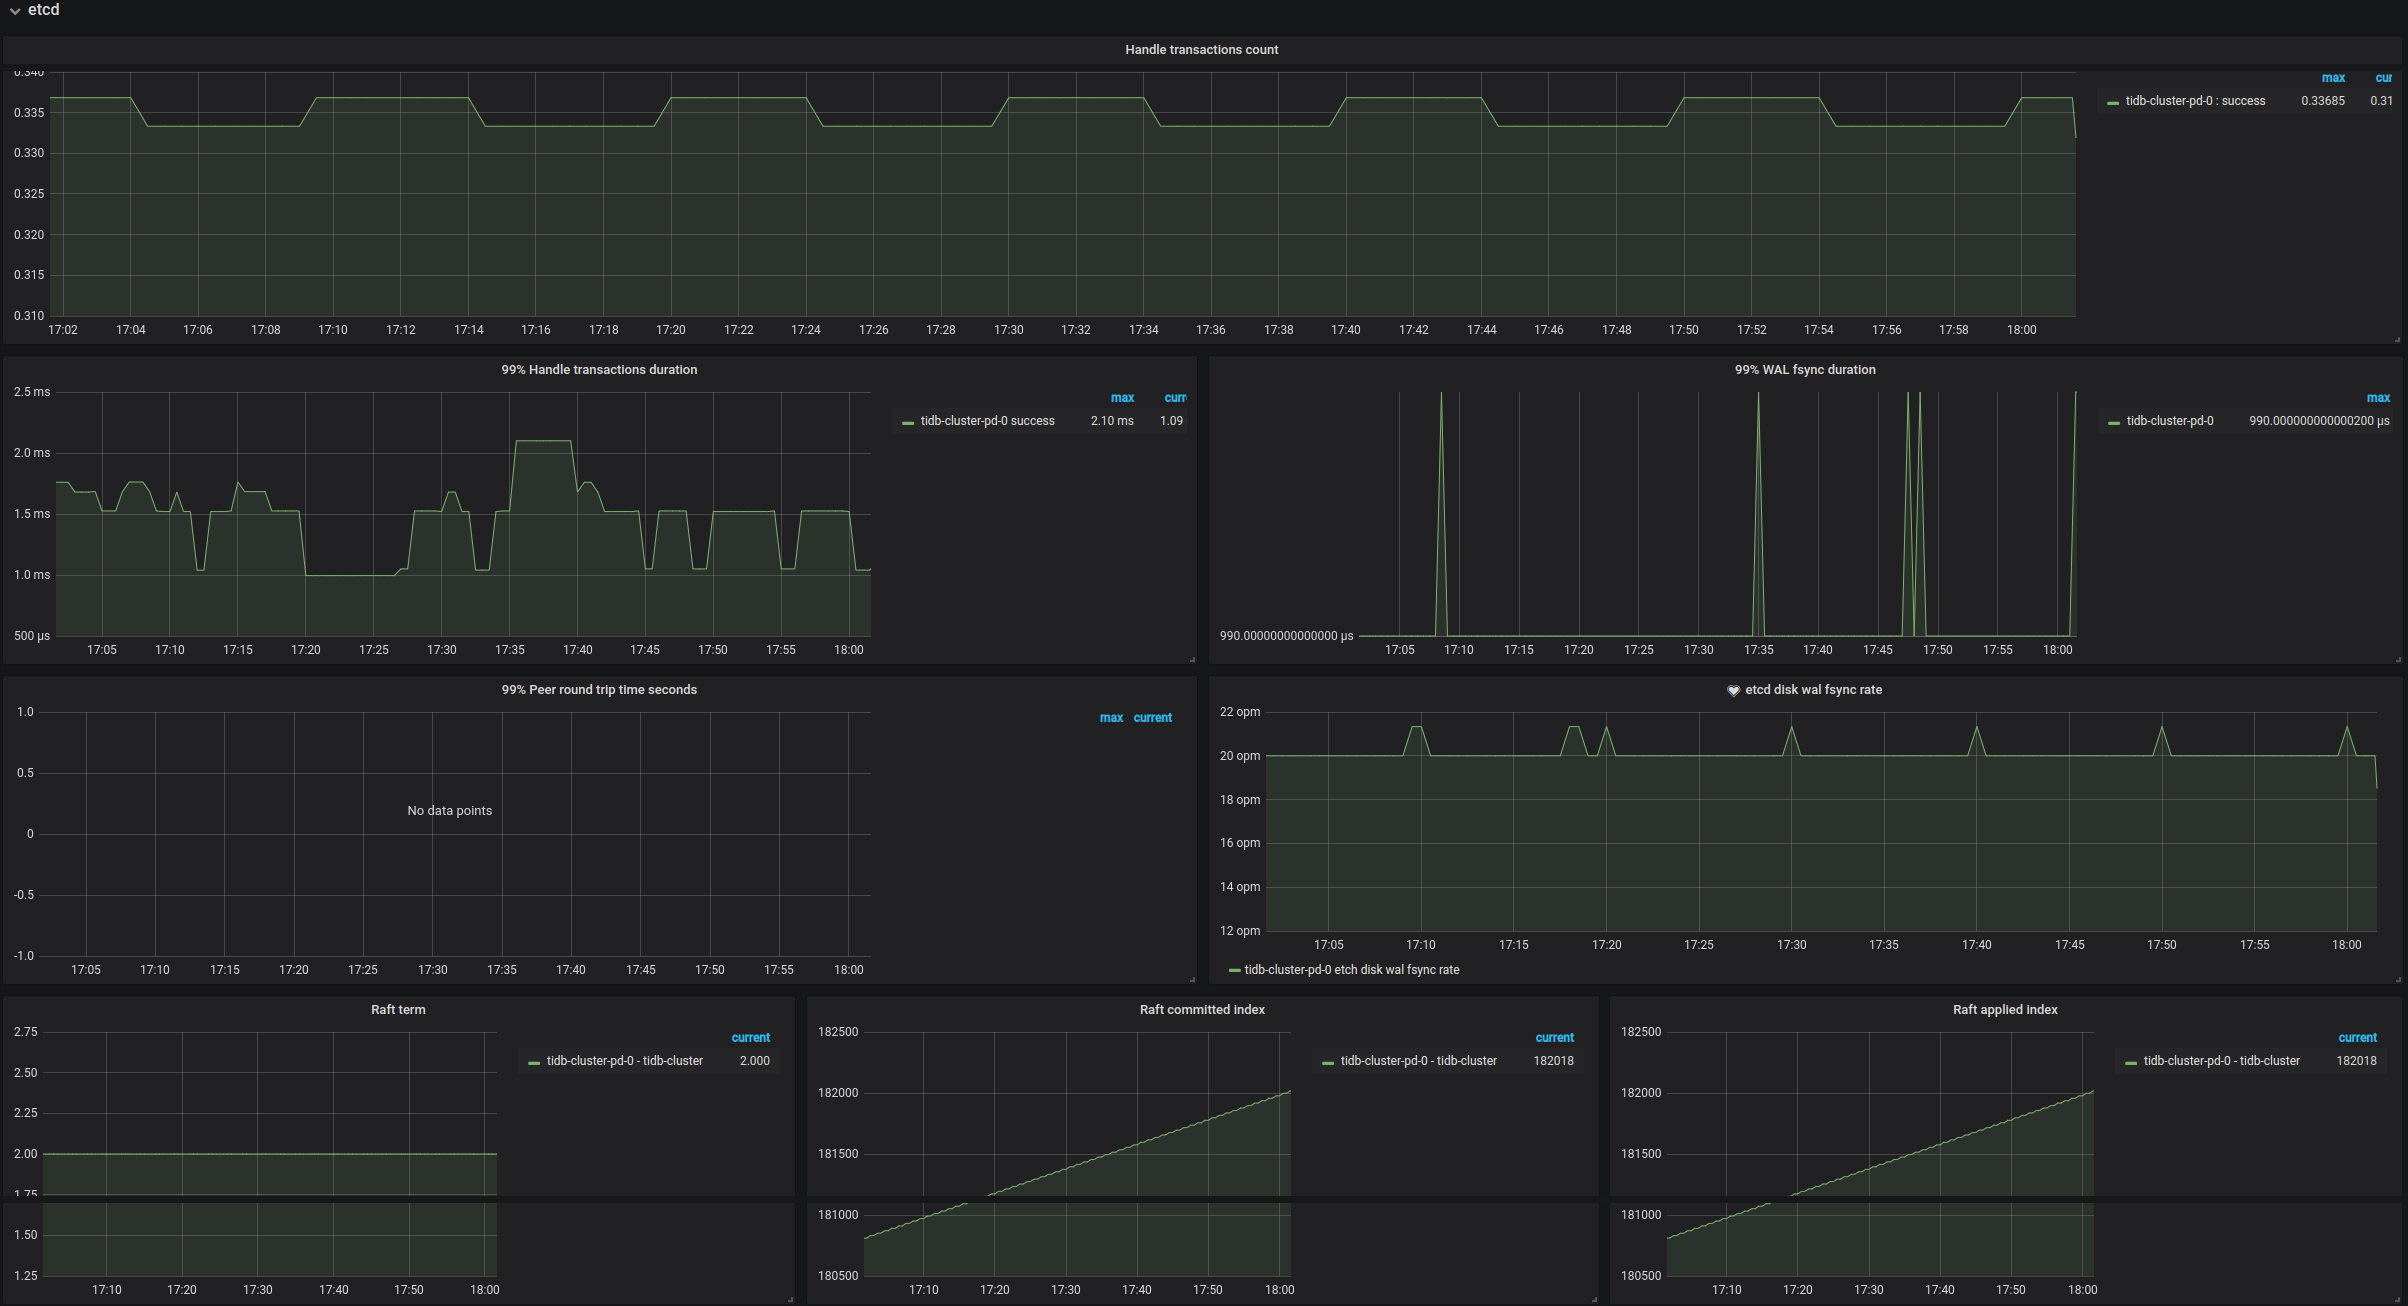
etcd
- Handle transactions count: etcdがトランザクションを処理する速度
- 99% Handle transactions duration: トランザクション処理率 (P99)
- 99% WAL fsync duration: WAL を永続ストレージに書き込むのにかかる時間。
1s(P99) 未満です。 - 99% Peer round trip time seconds: etcd のネットワークレイテンシー(P99)| 値は
1s未満です - etcd disk WAL fsync rate: 永続ストレージへの WAL の書き込みレート
- Raft term: Raftの現在のterm
- Raft committed index: Raftの最後にコミットされたインデックス
- Raft applied index: Raftの最後に適用されたインデックス
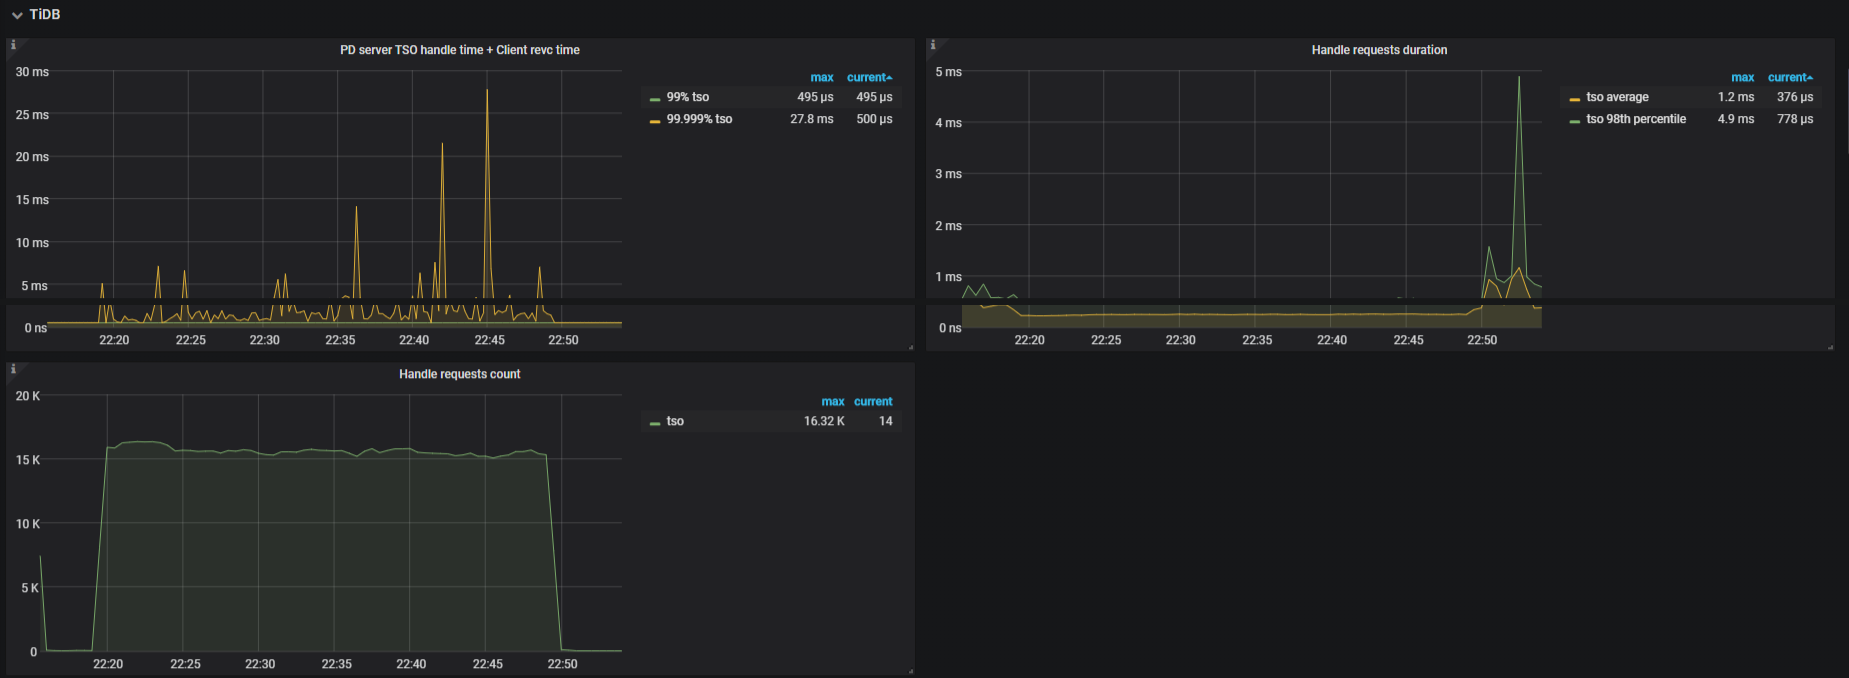
TiDB
- PD Server TSO handle time and Client recv time: PDがTSOリクエストを受信してからPDクライアントがTSO応答を受信するまでの時間
- Handle requests count: TiDB リクエストの数
- Handle requests duration: TiDBリクエストの処理に要した時間。(P99) は
100ms未満である必要があります。
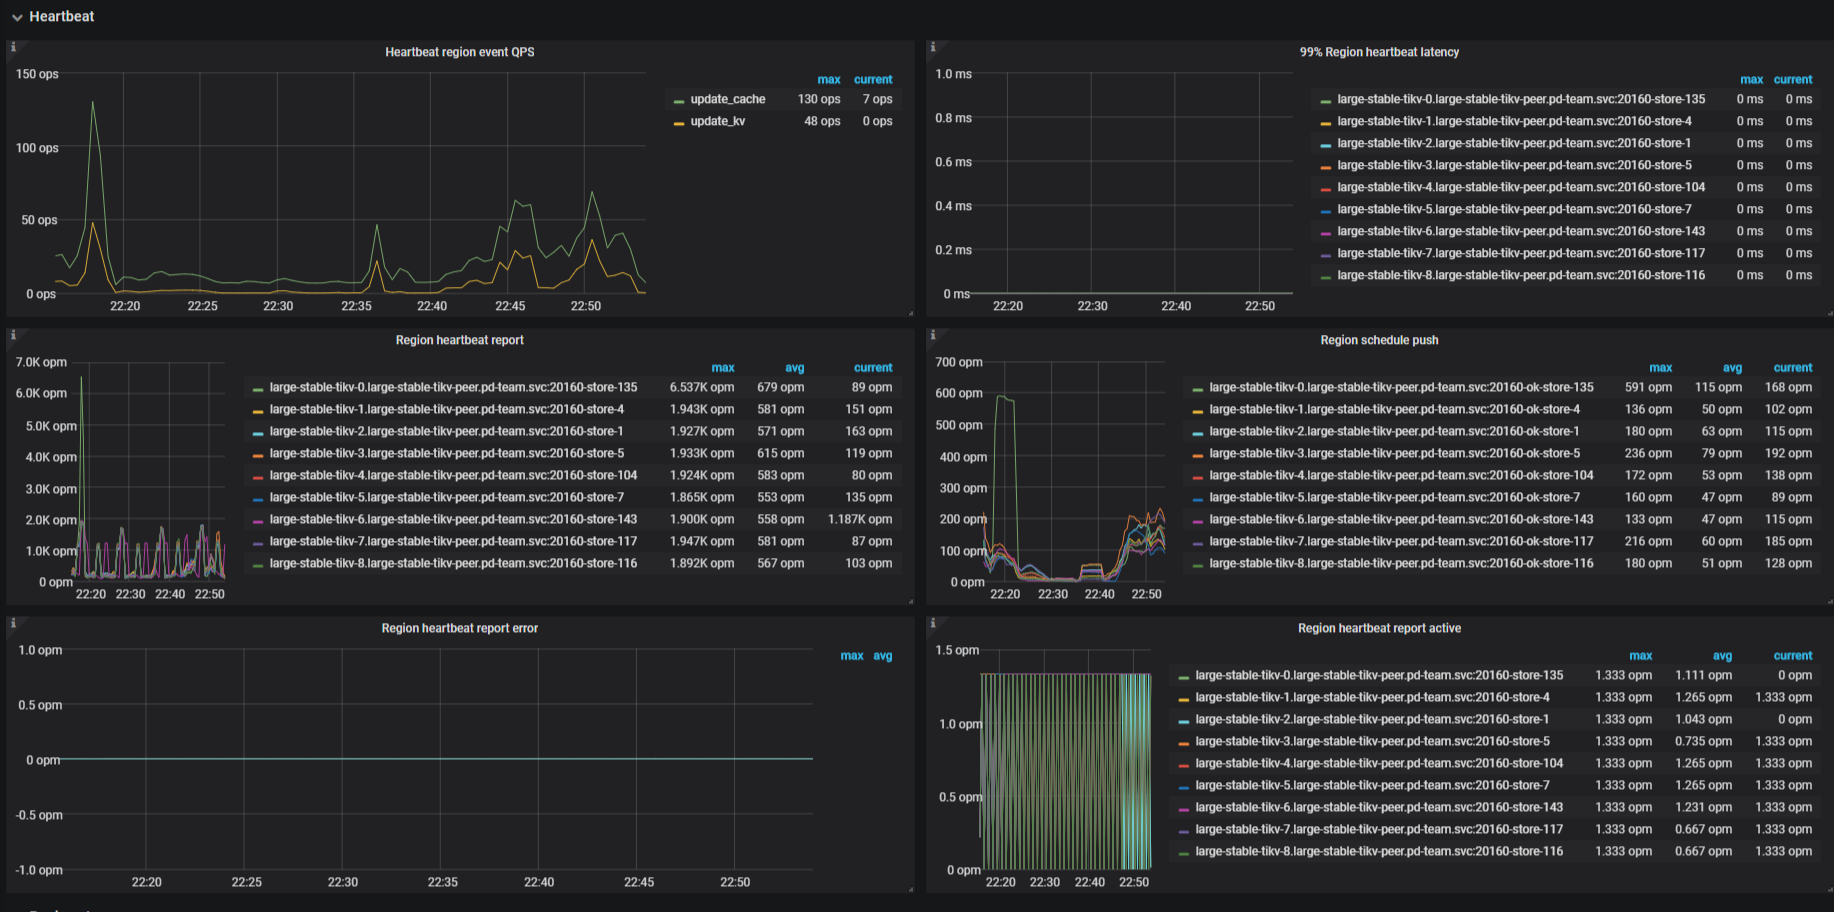
Heartbeat
- Heartbeat region event QPS: キャッシュの更新やデータの永続化を含むハートビートメッセージの処理のQPS
- Region heartbeat report: インスタンスごとにPDに報告されたハートビートの数
- Region heartbeat report error: ステータスが
errorのハートビートの数 - Region heartbeat report active: ステータスが
okのハートビートの数 - Region schedule push: TiKVインスタンスごとにPDから送信された対応するスケジュールコマンドの数
- 99% Region heartbeat latency: TiKVインスタンスあたりのハートビートレイテンシー(P99)
Region storage
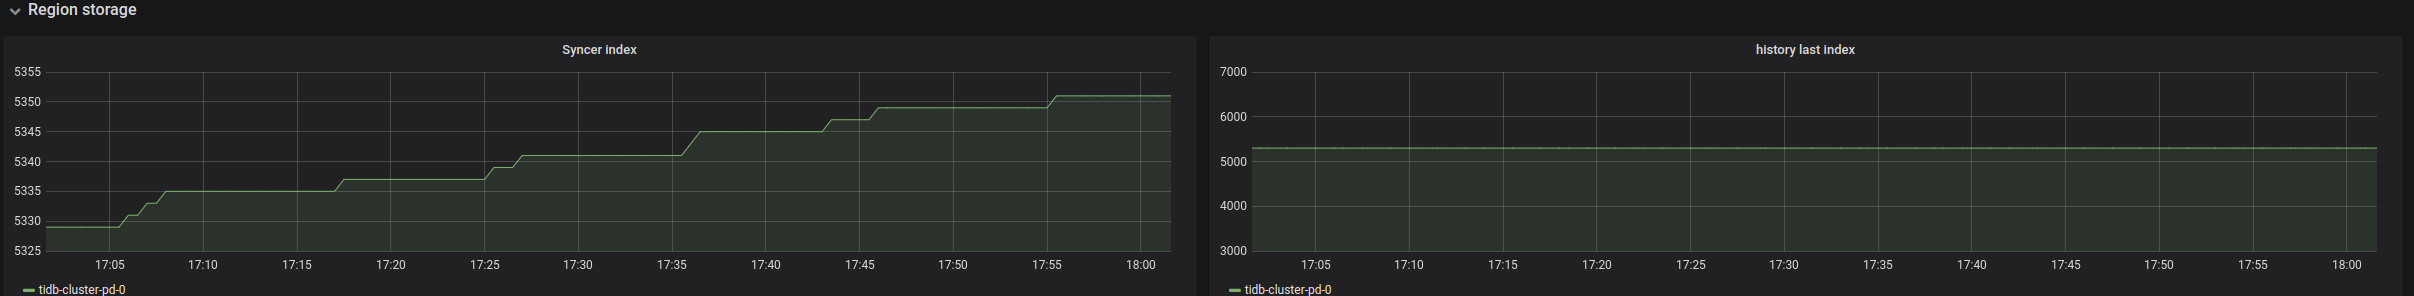
- Syncer Index: リーダーによって記録されたリージョン変更履歴の最大インデックス
- history last index:リージョン変更履歴がフォロワーと正常に同期された最後のインデックス