バケットからのロード
データファイルが Amazon S3 などのオブジェクトストレージのバケットに保存されている場合、COPY INTO コマンドを使用してそれらを TiDB Cloud Lake に直接ロードできます。ファイルは TiDB Cloud Lake がサポートする形式である必要があり、そうでない場合はデータをインポートできないことに注意してください。TiDB Cloud Lake がサポートするファイル形式の詳細については、入出力ファイル形式 を参照してください。
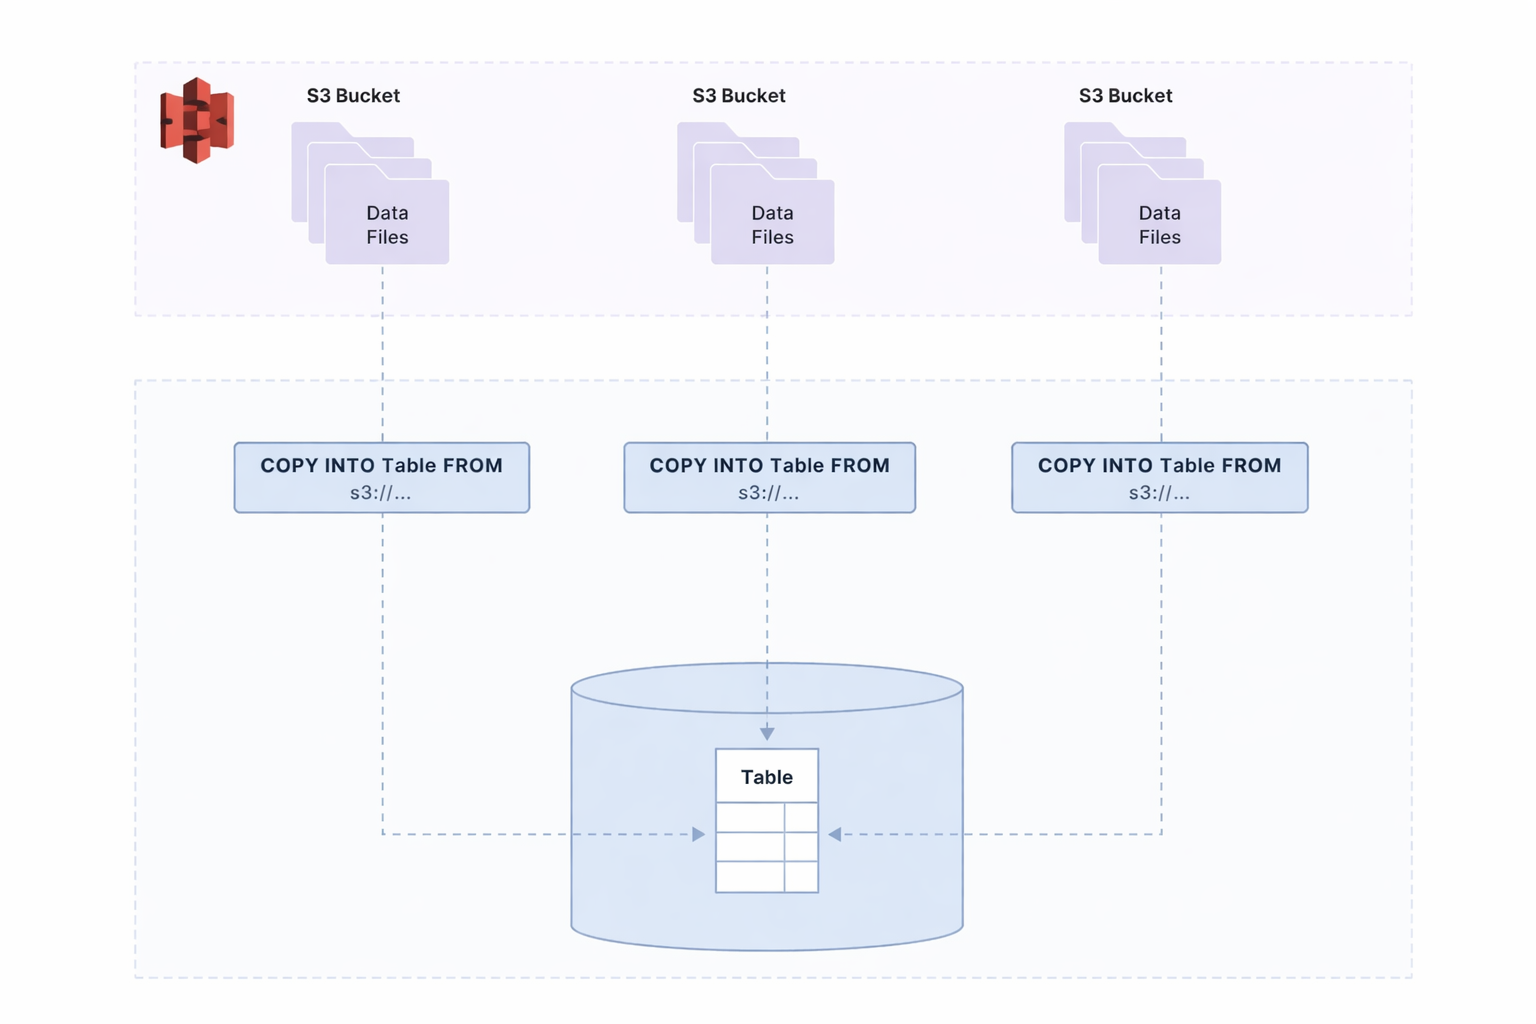
このチュートリアルでは Amazon S3 バケットを例として使用し、バケットに保存されたファイルからデータをロード (load) するプロセスを効果的に進められるよう、詳細なステップバイステップのガイドを提供します。
チュートリアル: Amazon S3 バケットからのロード
始める前に
開始する前に、次のタスクを完了していることを確認してください。
サンプルファイル books.parquet をダウンロードし、ローカルフォルダに保存します。このファイルには 2 件のレコードが含まれています。
Transaction Processing,Jim Gray,1992
Readings in Database Systems,Michael Stonebraker,2004
Amazon S3 にバケットを作成し、そのバケットにサンプルファイルをアップロードします。手順については、次のリンクを参照してください。
- バケットの作成: https://docs.aws.amazon.com/AmazonS3/latest/userguide/create-bucket-overview.html
- オブジェクトのアップロード: https://docs.aws.amazon.com/AmazonS3/latest/userguide/upload-objects.html
このチュートリアルでは、US East (Ohio) リージョン(ID: us-east-2)に lake-toronto という名前のバケットを作成しています。
ステップ 1. 対象テーブルを作成する
TiDB Cloud Lake で次の SQL 文を使用してテーブルを作成します。
USE default;
CREATE TABLE books
(
    title VARCHAR,
    author VARCHAR,
    date VARCHAR
);
ステップ 2. テーブルにデータをコピーする
COPY INTO コマンドを使用して、対象テーブルにデータをロードします。
COPY INTO books
FROM 's3://lake-toronto/'
CONNECTION = (
    ACCESS_KEY_ID = '<your-access-key-id>',
    SECRET_ACCESS_KEY = '<your-secret-access-key>'
)
PATTERN = '.*[.]parquet'
FILE_FORMAT = (
    TYPE = 'PARQUET'
);
ロードされたデータを確認します。
SELECT * FROM books;

---
title                       |author             |date|
----------------------------+-------------------+----+
Transaction Processing      |Jim Gray           |1992|
Readings in Database Systems|Michael Stonebraker|2004|