COPY INTO <table>
COPY INTO を使用すると、以下のいずれかの場所にあるファイルからデータをロード (load) できます。
- ユーザー / 内部 / 外部 stage: TiDB Cloud Lake の stage については、Stage とは? を参照してください。
- ストレージサービスで作成されたバケットまたはコンテナ。
- URL(
https://で始まる)でファイルにアクセスできるリモートサーバー。 - IPFS および Hugging Face リポジトリ。
関連情報: COPY INTO <location>
構文
/* Standard data load */
COPY INTO [<database_name>.]<table_name> [ ( <col_name> [ , <col_name> ... ] ) ]
     FROM { userStage | internalStage | externalStage | externalLocation }
[ FILES = ( '<file_name>' [ , '<file_name>' ] [ , ... ] ) ]
[ PATTERN = '<regex_pattern>' ]
[ FILE_FORMAT = (
         FORMAT_NAME = '<your-custom-format>'
         | TYPE = { CSV | TSV | NDJSON | PARQUET | ORC | AVRO } [ formatTypeOptions ]
       ) ]
[ copyOptions ]

/* Data load with transformation */
COPY INTO [<database_name>.]<table_name> [ ( <col_name> [ , <col_name> ... ] ) ]
     FROM (
        SELECT {
            [<alias>.]<column> [, [<alias>.]<column> ...] -- Query columns by name
            | [<alias>.]$<col_position> [, [<alias>.]$<col_position> ...] -- Query columns by position
            | [<alias>.]$1[:<column>] [, [<alias>.]$1[:<column>]  ...] -- Query rows as Variants
            } ]
        FROM {@<stage_name>[/<path>] | '<uri>'}
    )
[ FILES = ( '<file_name>' [ , '<file_name>' ] [ , ... ] ) ]
[ PATTERN = '<regex_pattern>' ]
[ FILE_FORMAT = (
         FORMAT_NAME = '<your-custom-format>'
         | TYPE = { CSV | TSV | NDJSON | PARQUET | ORC | AVRO } [ formatTypeOptions ]
       ) ]
[ copyOptions ]
以下のとおりです。
userStage ::= @~[/<path>]

internalStage ::= @<internal_stage_name>[/<path>]

externalStage ::= @<external_stage_name>[/<path>]

externalLocation ::=
  /* Amazon S3-like Storage */
  's3://<bucket>[/<path>]'
  CONNECTION = (
    [ CONNECTION_NAME = '<connection-name>' ]
    | [ ENDPOINT_URL = '<endpoint-url>' ]
    [ ACCESS_KEY_ID = '<your-access-key-ID>' ]
    [ SECRET_ACCESS_KEY = '<your-secret-access-key>' ]
    [ ENABLE_VIRTUAL_HOST_STYLE = TRUE | FALSE ]
    [ MASTER_KEY = '<your-master-key>' ]
    [ REGION = '<region>' ]
    [ SECURITY_TOKEN = '<security-token>' ]
    [ ROLE_ARN = '<role-arn>' ]
    [ EXTERNAL_ID = '<external-id>' ]
  )

  /* Azure Blob Storage */
  | 'azblob://<container>[/<path>]'
    CONNECTION = (
      [ CONNECTION_NAME = '<connection-name>' ]
      | ENDPOINT_URL = '<endpoint-url>'
      ACCOUNT_NAME = '<account-name>'
      ACCOUNT_KEY = '<account-key>'
    )

  /* Google Cloud Storage */
  | 'gcs://<bucket>[/<path>]'
    CONNECTION = (
      [ CONNECTION_NAME = '<connection-name>' ]
      | CREDENTIAL = '<your-base64-encoded-credential>'
    )

  /* Alibaba Cloud OSS */
  | 'oss://<bucket>[/<path>]'
    CONNECTION = (
      [ CONNECTION_NAME = '<connection-name>' ]
      | ACCESS_KEY_ID = '<your-ak>'
      ACCESS_KEY_SECRET = '<your-sk>'
      ENDPOINT_URL = '<endpoint-url>'
      [ PRESIGN_ENDPOINT_URL = '<presign-endpoint-url>' ]
    )

  /* Tencent Cloud Object Storage */
  | 'cos://<bucket>[/<path>]'
    CONNECTION = (
      [ CONNECTION_NAME = '<connection-name>' ]
      | SECRET_ID = '<your-secret-id>'
      SECRET_KEY = '<your-secret-key>'
      ENDPOINT_URL = '<endpoint-url>'
    )

  /* Remote Files */
  | 'https://<url>'

  /* IPFS */
  | 'ipfs://<your-ipfs-hash>'
    CONNECTION = (ENDPOINT_URL = 'https://<your-ipfs-gateway>')

  /* Hugging Face */
  | 'hf://<repo-id>[/<path>]'
    CONNECTION = (
      [ REPO_TYPE = 'dataset' | 'model' ]
      [ REVISION = '<revision>' ]
      [ TOKEN = '<your-api-token>' ]
    )

formatTypeOptions ::=
  /* Common options for all formats */
  [ COMPRESSION = AUTO | GZIP | BZ2 | BROTLI | ZSTD | DEFLATE | RAW_DEFLATE | XZ | NONE ]

  /* CSV specific options */
  [ RECORD_DELIMITER = '<character>' ]
  [ FIELD_DELIMITER = '<character>' ]
  [ SKIP_HEADER = <integer> ]
  [ QUOTE = '<character>' ]
  [ ESCAPE = '<character>' ]
  [ NAN_DISPLAY = '<string>' ]
  [ NULL_DISPLAY = '<string>' ]
  [ ERROR_ON_COLUMN_COUNT_MISMATCH = TRUE | FALSE ]
  [ EMPTY_FIELD_AS = null | string | field_default ]
  [ BINARY_FORMAT = HEX | BASE64 ]
  [ TRIM_SPACE = TRUE | FALSE ]
  [ ENCODING = '<encoding_label>' ]
  [ ENCODING_ERROR_MODE = STRICT | REPLACE ]

  /* TSV specific options */
  [ RECORD_DELIMITER = '<character>' ]
  [ FIELD_DELIMITER = '<character>' ]
  [ TRIM_SPACE = TRUE | FALSE ]
  [ ENCODING = '<encoding_label>' ]
  [ ENCODING_ERROR_MODE = STRICT | REPLACE ]

  /* NDJSON specific options */
  [ NULL_FIELD_AS = NULL | FIELD_DEFAULT ]
  [ MISSING_FIELD_AS = ERROR | NULL | FIELD_DEFAULT ]
  [ NULL_IF = ('value1', 'value2', ...) ]

  /* PARQUET specific options */
  [ MISSING_FIELD_AS = ERROR | FIELD_DEFAULT ]
  [ NULL_IF = ('value1', 'value2', ...) ]
  [ USE_LOGIC_TYPE = TRUE | FALSE ]

  /* ORC specific options */
  [ MISSING_FIELD_AS = ERROR | FIELD_DEFAULT ]

  /* AVRO specific options */
  [ MISSING_FIELD_AS = ERROR | FIELD_DEFAULT ]
  [ NULL_IF = ('value1', 'value2', ...) ]
  [ USE_LOGIC_TYPE = TRUE | FALSE ]

copyOptions ::=
  [ PURGE = <bool> ]
  [ FORCE = <bool> ]
  [ DISABLE_VARIANT_CHECK = <bool> ]
  [ ON_ERROR = { continue | abort | abort_N } ]
  [ MAX_FILES = <num> ]
  [ RETURN_FAILED_ONLY = <bool> ]
  [ COLUMN_MATCH_MODE = { case-sensitive | case-insensitive } ]
  [ SCHEMA_EVOLUTION = (
      [ SAMPLE_FILES = AUTO | <positive_integer> ]
      [ , SAMPLE_RECORDS_PER_FILE = AUTO | <positive_integer> ]
      [ , SAMPLE_TOTAL_RECORDS = AUTO | <positive_integer> ]
    ) ]
主なパラメータ
FILES: ロードする 1 つ以上のファイル名(カンマ区切り)を指定します。
PATTERN: 一致させるファイル名を指定する、PCRE2 ベースの正規表現パターン文字列です。stage からロードする場合、このパターンは
@<stage_name>[/<path>]より後ろのファイルパス部分に対して一致します。PATTERN を使用した stage ファイルのフィルタリング および 例 4: PATTERN を使用したファイルのフィルタリング を参照してください。
フォーマットタイプのオプション
FILE_FORMAT パラメータはさまざまなファイルタイプをサポートしており、それぞれに固有のフォーマットオプションがあります。以下に、サポートされている各ファイル形式で使用可能なオプションを示します。すべてのオプションの詳細については、入出力ファイル形式 を参照してください。
これらのオプションは、すべてのファイル形式で使用できます。
コピーオプション
SCHEMA_EVOLUTION のオプション
SCHEMA_EVOLUTION は、TiDB Cloud Lake がロード前に stage 上の NDJSON ファイルをどのようにサンプリングするかを制御します。ターゲットテーブルで ENABLE_SCHEMA_EVOLUTION = true が設定されている場合に、FILE_FORMAT = (TYPE = NDJSON ...) と組み合わせて使用します。
stage またはロケーションからのロードで Schema Evolution の推論が実行される場合、COPY INTO <table> を実行するロールには、ターゲットテーブルに対する INSERT 権限と ALTER 権限の両方が必要です。COPY INTO <table> FROM (SELECT ... FROM @stage) のようなクエリベースの COPY では、既存の権限要件が維持されます。
SCHEMA_EVOLUTION を省略した場合、TiDB Cloud Lake は 3 つのサンプリングオプションすべてに AUTO を使用します。現在の AUTO の動作では、最大 64 ファイル、各ファイルあたり 1,000 レコード、合計 10,000 レコードまでサンプリングします。これらの内部デフォルト値は、将来のバージョンで変更される可能性があります。ロードがサンプリング戦略に敏感な場合は、SAMPLE_FILES、SAMPLE_RECORDS_PER_FILE、SAMPLE_TOTAL_RECORDS を明示的に設定してください。サンプルで検出されなかったカラムがロード中の後続データに現れた場合、COPY は失敗し、追加のカラム名を報告するため、サンプリング値を増やすことができます。
出力
COPY INTO は、以下のカラムを含むデータロード結果のサマリーを提供します。
RETURN_FAILED_ONLY が true に設定されている場合、出力にはロードに失敗したファイルのみが含まれます。
例
外部ストレージソースでは、COPY 文で認証情報を直接指定する代わりに、CONNECTION_NAME パラメータを使用して事前作成済みの接続を利用することを推奨します。この方法により、セキュリティ、管理性、再利用性が向上します。接続の作成方法の詳細については、CREATE CONNECTION を参照してください。
例 1: stage からのロード
以下の例は、さまざまな種類の stage から TiDB Cloud Lake にデータをロードする方法を示しています。
COPY INTO mytable
    FROM @~
    PATTERN = '.*[.]parquet'
    FILE_FORMAT = (TYPE = PARQUET);
COPY INTO mytable
    FROM @my_internal_stage
    PATTERN = '.*[.]parquet'
    FILE_FORMAT = (TYPE = PARQUET);
COPY INTO mytable
    FROM @my_external_stage
    PATTERN = '.*[.]parquet'
    FILE_FORMAT = (TYPE = PARQUET);
例 2: 外部ロケーションからのロード
以下の例では、さまざまな種類の外部ソースから TiDB Cloud Lake にデータをロードする方法を示します。
この例では、事前に作成した接続を使用して Amazon S3 からデータをロードします。
-- First create a connection (you only need to do this once)
CREATE CONNECTION my_s3_conn
    STORAGE_TYPE = 's3'
    ACCESS_KEY_ID = '<your-access-key-ID>'
    SECRET_ACCESS_KEY = '<your-secret-access-key>';

-- Use the connection to load data
COPY INTO mytable
    FROM 's3://mybucket/data.csv'
    CONNECTION = (CONNECTION_NAME = 'my_s3_conn')
    FILE_FORMAT = (
        TYPE = CSV,
        FIELD_DELIMITER = ',',
        RECORD_DELIMITER = '\n',
        SKIP_HEADER = 1
    );
IAM ロールを使用する場合(本番環境では推奨)
-- Create connection using IAM role (more secure, recommended for production)
CREATE CONNECTION my_iam_conn
    STORAGE_TYPE = 's3'
    ROLE_ARN = 'arn:aws:iam::123456789012:role/my_iam_role';

-- Load CSV files using the IAM role connection
COPY INTO mytable
    FROM 's3://mybucket/'
    CONNECTION = (CONNECTION_NAME = 'my_iam_conn')
    PATTERN = '.*[.]csv'
    FILE_FORMAT = (
        TYPE = CSV,
        FIELD_DELIMITER = ',',
        RECORD_DELIMITER = '\n',
        SKIP_HEADER = 1
    );
この例では、Azure Blob Storage に接続し、'data.csv' から TiDB Cloud Lake にデータをロードします。
-- Create connection for Azure Blob Storage
CREATE CONNECTION my_azure_conn
    STORAGE_TYPE = 'azblob'
    ENDPOINT_URL = 'https://<account_name>.blob.core.windows.net'
    ACCOUNT_NAME = '<account_name>'
    ACCOUNT_KEY = '<account_key>';

-- Use the connection to load data
COPY INTO mytable
    FROM 'azblob://mybucket/data.csv'
    CONNECTION = (CONNECTION_NAME = 'my_azure_conn')
    FILE_FORMAT = (type = CSV);
この例では、Google Cloud Storage に接続してデータをロードします。
-- Create connection for Google Cloud Storage
CREATE CONNECTION my_gcs_conn
    STORAGE_TYPE = 'gcs'
    CREDENTIAL = '<your-base64-encoded-credential>';

-- Use the connection to load data
COPY INTO mytable
    FROM 'gcs://mybucket/data.csv'
    CONNECTION = (CONNECTION_NAME = 'my_gcs_conn')
    FILE_FORMAT = (
        TYPE = CSV,
        FIELD_DELIMITER = ',',
        RECORD_DELIMITER = '\n',
        SKIP_HEADER = 1
    );
この例では、3 つのリモート CSV ファイルからデータをロードし、エラーが発生した場合はそのファイルをスキップします。
COPY INTO mytable
    FROM 'https://lakesql-bin.tidbcloud.com/datasets/ontime_200{6,7,8}_200.csv'
    FILE_FORMAT = (type = CSV)
    ON_ERROR = continue;
この例では、IPFS 上の CSV ファイルからデータをロードします。
COPY INTO mytable
    FROM 'ipfs://<your-ipfs-hash>'
    CONNECTION = (
        ENDPOINT_URL = 'https://<your-ipfs-gateway>'
    )
    FILE_FORMAT = (
        TYPE = CSV,
        FIELD_DELIMITER = ',',
        RECORD_DELIMITER = '\n',
        SKIP_HEADER = 1
    );
例 3: 圧縮データのロード
この例では、Amazon S3 上の GZIP 圧縮された CSV ファイルを TiDB Cloud Lake にロードします。
-- Create connection for compressed data loading
CREATE CONNECTION compressed_s3_conn
    STORAGE_TYPE = 's3'
    ACCESS_KEY_ID = '<your-access-key-ID>'
    SECRET_ACCESS_KEY = '<your-secret-access-key>';

-- Load GZIP-compressed CSV file using the connection
COPY INTO mytable
    FROM 's3://mybucket/data.csv.gz'
    CONNECTION = (CONNECTION_NAME = 'compressed_s3_conn')
    FILE_FORMAT = (
        TYPE = CSV,
        FIELD_DELIMITER = ',',
        RECORD_DELIMITER = '\n',
        SKIP_HEADER = 1,
        COMPRESSION = AUTO
    );
例 4: PATTERN を使用したファイルのフィルタリング
この例では、PATTERN パラメータによるパターンマッチングを使用して、Amazon S3 から CSV ファイルをロードする方法を示します。ファイル名に 'sales' を含み、拡張子が '.csv' のファイルをフィルタリングします。
-- Create connection for pattern-based file loading
CREATE CONNECTION pattern_s3_conn
    STORAGE_TYPE = 's3'
    ACCESS_KEY_ID = '<your-access-key-ID>'
    SECRET_ACCESS_KEY = '<your-secret-access-key>';

-- Load CSV files with 'sales' in their names using pattern matching
COPY INTO mytable
    FROM 's3://mybucket/'
    CONNECTION = (CONNECTION_NAME = 'pattern_s3_conn')
    PATTERN = '.*sales.*[.]csv'
    FILE_FORMAT = (
        TYPE = CSV,
        FIELD_DELIMITER = ',',
        RECORD_DELIMITER = '\n',
        SKIP_HEADER = 1
    );
ここで、.* は任意の文字が 0 回以上出現することを意味します。角括弧は、ファイル拡張子の前にあるピリオド文字 . をエスケープしています。
接続を使用してすべての CSV ファイルからロードするには、次のようにします。
COPY INTO mytable
    FROM 's3://mybucket/'
    CONNECTION = (CONNECTION_NAME = 'pattern_s3_conn')
    PATTERN = '.*[.]csv'
    FILE_FORMAT = (
        TYPE = CSV,
        FIELD_DELIMITER = ',',
        RECORD_DELIMITER = '\n',
        SKIP_HEADER = 1
    );
複数のフォルダを含むパス内の stage 上のファイルに対してパターンを指定する場合、パターンは @<stage_name>[/<path>] より後のパス部分にのみ一致することに注意してください。たとえば、FROM @sales_stage/raw/ の場合、ファイル @sales_stage/raw/year=2025/month=01/sales_20250101.parquet は year=2025/month=01/sales_20250101.parquet としてマッチされます。
プレフィックスに続く特定のサブパスに一致させたい場合は、そのプレフィックスをパターンに含めて(例: 'year=2025/month=01/')、そのサブパス内で一致させたいパターン(例: 'sales_')を指定します。
-- File path: raw/year=2025/month=01/sales_20250101.parquet
COPY INTO ... FROM @sales_stage/raw/ PATTERN = 'year=2025/month=01/.*sales_.*[.]parquet') ...
ファイルパス内の任意の場所に目的のパターンを含む部分に一致させたい場合は、パターンの前後に '.' を付けて(例: '.sales_20250101.*')、パス内の 'sales_20250101' の任意の出現箇所に一致させます。
-- File path: raw/year=2025/month=01/sales_20250101.parquet
COPY INTO ... FROM @sales_stage/raw/ PATTERN = '.*sales_20250101.*') ...
例 5: 追加カラムを持つテーブルへのロード
このセクションでは、サンプルファイル books.csv を使用して、追加カラムを持つテーブルにデータをロードする方法を示します。
Transaction Processing,Jim Gray,1992
Readings in Database Systems,Michael Stonebraker,2004
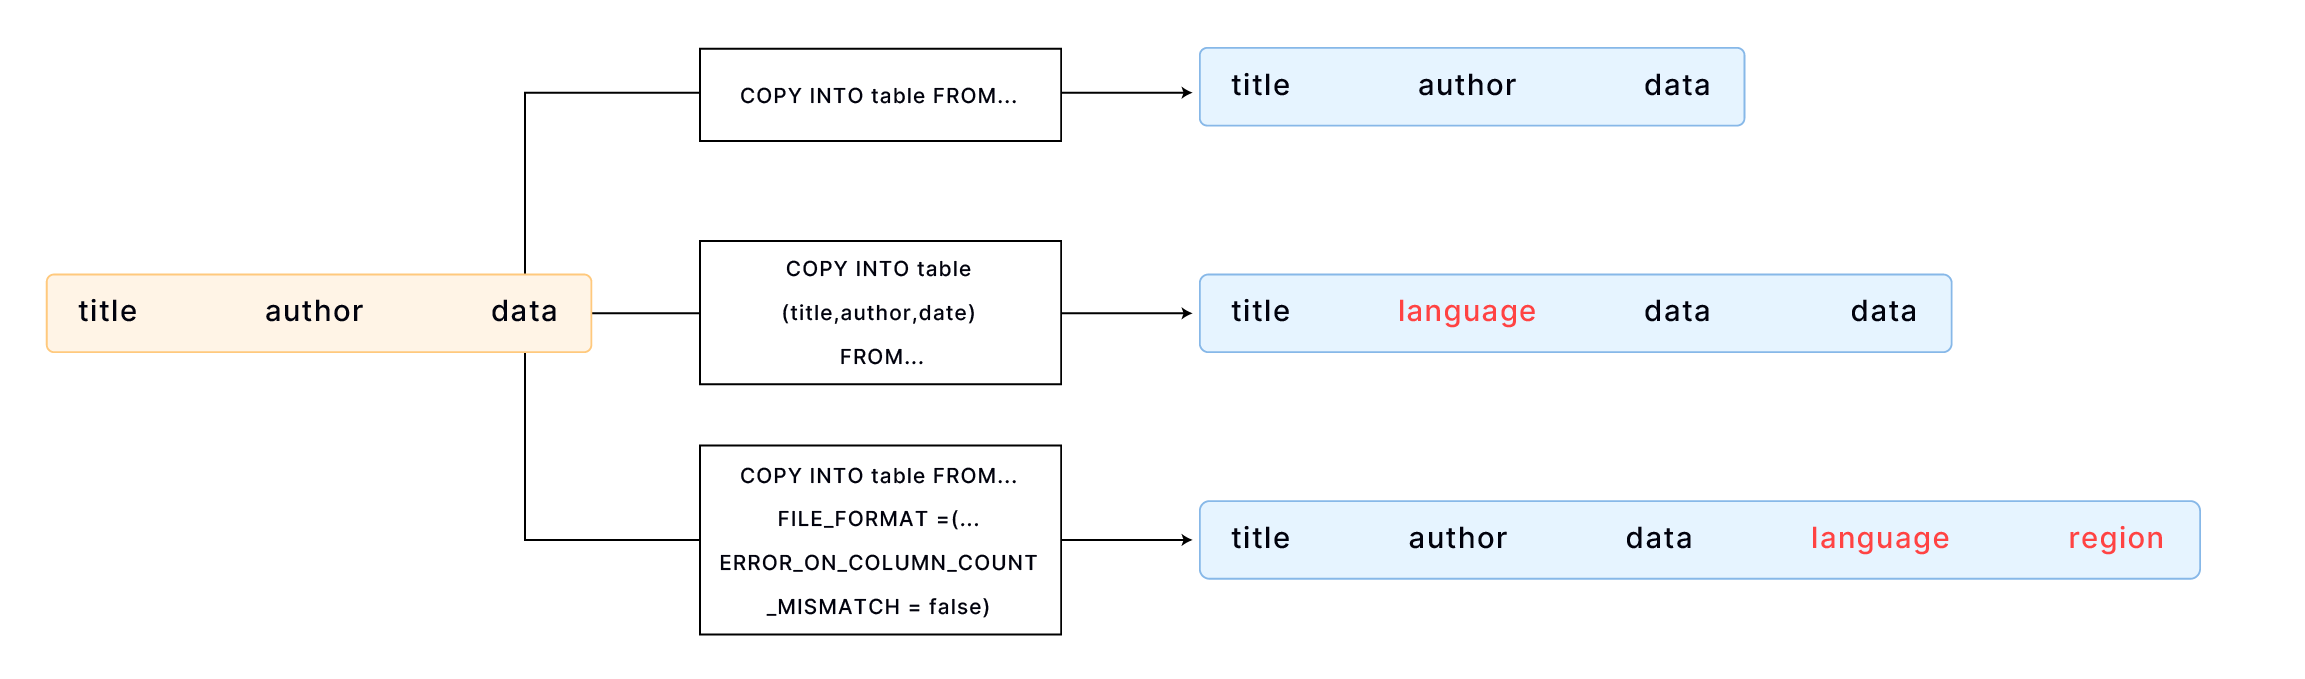
デフォルトでは、COPY INTO はファイル内のフィールドの順序をテーブル内の対応するカラムに対応付けて、テーブルにデータをロードします。ファイルとテーブルの間でデータが正しく対応していることを確認することが重要です。たとえば、次のようになります。
CREATE TABLE books
(
    title VARCHAR,
    author VARCHAR,
    date VARCHAR
);

COPY INTO books
    FROM 'https://lakesql-bin.tidbcloud.com/datasets/books.csv'
    FILE_FORMAT = (TYPE = CSV);
テーブルのカラム数がファイルより多い場合は、データをロードする対象のカラムを指定できます。たとえば、次のようになります。
CREATE TABLE books_with_language
(
    title VARCHAR,
    language VARCHAR,
    author VARCHAR,
    date VARCHAR
);

COPY INTO books_with_language (title, author, date)
    FROM 'https://lakesql-bin.tidbcloud.com/datasets/books.csv'
    FILE_FORMAT = (TYPE = CSV);
テーブルのカラム数がファイルより多く、追加カラムがテーブルの末尾にある場合は、FILE_FORMAT オプション ERROR_ON_COLUMN_COUNT_MISMATCH を使用してデータをロードできます。これにより、各カラムを個別に指定しなくてもデータをロードできます。なお、ERROR_ON_COLUMN_COUNT_MISMATCH は現在、CSV ファイル形式でのみ機能します。
CREATE TABLE books_with_extra_columns
(
    title VARCHAR,
    author VARCHAR,
    date VARCHAR,
    language VARCHAR,
    region VARCHAR
);

COPY INTO books_with_extra_columns
    FROM 'https://lakesql-bin.tidbcloud.com/datasets/books.csv'
    FILE_FORMAT = (TYPE = CSV, ERROR_ON_COLUMN_COUNT_MISMATCH = false);
例 6: カスタム形式での JSON のロード
この例では、次の内容を持つ CSV ファイル "data.csv" からデータをロードします。
1,"U00010","{\"carPriceList\":[{\"carTypeId\":10,\"distance\":5860},{\"carTypeId\":11,\"distance\":5861}]}"
2,"U00011","{\"carPriceList\":[{\"carTypeId\":12,\"distance\":5862},{\"carTypeId\":13,\"distance\":5863}]}"
各行には 3 つのカラムのデータが含まれており、3 番目のカラムは JSON データを含む文字列です。JSON フィールドを含む CSV データを正しくロードするには、適切なエスケープ文字を設定する必要があります。この例では、JSON データにダブルクォート " が含まれているため、バックスラッシュ \ をエスケープ文字として使用します。
ステップ 1: カスタムファイル形式を作成する
-- Define a custom CSV file format with the escape character set to backslash \
CREATE FILE FORMAT my_csv_format
    TYPE = CSV
    ESCAPE = '\\';
ステップ 2: ターゲットテーブルを作成する
CREATE TABLE t
  (
     id       INT,
     seq      VARCHAR,
     p_detail VARCHAR
  );
ステップ 3: カスタムファイル形式でロードする
COPY INTO t FROM @t_stage FILES=('data.csv')
FILE_FORMAT=(FORMAT_NAME='my_csv_format');
例 7: 無効な JSON のロード
Variant カラムにデータをロード (load) する際、TiDB Cloud Lake はデータの妥当性を自動的にチェックし、無効なデータがある場合はエラーを返します。たとえば、ユーザー stage に invalid_json_string.parquet という名前の Parquet ファイルがあり、その中に次のような無効な JSON データが含まれているとします。
SELECT *
FROM @~/invalid_json_string.parquet;

┌────────────────────────────────────┐
│        a        │         b        │
├─────────────────┼──────────────────┤
│               5 │ {"k":"v"}        │
│               6 │ [1,              │
└────────────────────────────────────┘

DESC t2;

┌──────────────────────────────────────────────┐
│  Field │   Type  │  Null  │ Default │  Extra │
├────────┼─────────┼────────┼─────────┼────────┤
│ a      │ VARCHAR │ YES    │ NULL    │        │
│ b      │ VARIANT │ YES    │ NULL    │        │
└──────────────────────────────────────────────┘
このデータをテーブルにロードしようとすると、エラーが発生します。
COPY INTO t2 FROM @~/invalid_json_string.parquet FILE_FORMAT = (TYPE = PARQUET) ON_ERROR = CONTINUE;
error: APIError: ResponseError with 1006: EOF while parsing a value, pos 3 while evaluating function `parse_json('[1,')`
JSON の妥当性チェックを行わずにロードするには、COPY INTO 文で DISABLE_VARIANT_CHECK オプションを true に設定します。
COPY INTO t2 FROM @~/invalid_json_string.parquet
FILE_FORMAT = (TYPE = PARQUET)
DISABLE_VARIANT_CHECK = true
ON_ERROR = CONTINUE;

┌───────────────────────────────────────────────────────────────────────────────────────────────┐
│             File            │ Rows_loaded │ Errors_seen │    First_error   │ First_error_line │
├─────────────────────────────┼─────────────┼─────────────┼──────────────────┼──────────────────┤
│ invalid_json_string.parquet │           2 │           0 │ NULL             │             NULL │
└───────────────────────────────────────────────────────────────────────────────────────────────┘

SELECT * FROM t2;
-- Invalid JSON is stored as null in the Variant column.
┌──────────────────────────────────────┐
│         a        │         b         │
├──────────────────┼───────────────────┤
│ 5                │ {"k":"v"}         │
│ 6                │ null              │
└──────────────────────────────────────┘
例 8: Schema Evolution を使用したロード
スキーマにターゲットテーブルに存在しないカラムを含む Parquet または NDJSON ファイルをロードする場合、Schema Evolution を使用して不足しているカラムを自動的に追加できます。Schema Evolution の推論を実行する stage またはロケーションからのロードでは、ロードを実行するロールにターゲットテーブルに対する INSERT および ALTER 権限が必要です。まず、テーブルで Schema Evolution を有効にします。
CREATE OR REPLACE TABLE invoices(order_id INT);

-- Enable schema evolution
ALTER TABLE invoices SET OPTIONS(ENABLE_SCHEMA_EVOLUTION = true);
Parquet
次に、異なるスキーマを持つ Parquet ファイルをロードします。TiDB Cloud Lake は新しいカラムを自動的に追加し、不足している値を NULL で埋めます。
-- Assume @my_stage contains Parquet files with extra columns (e.g., amount, currency)
COPY INTO invoices
    FROM @my_stage/
    FILE_FORMAT = (TYPE = PARQUET MISSING_FIELD_AS = FIELD_DEFAULT);
NDJSON
NDJSON の場合、COPY INTO はデフォルトのサンプリング値を使用して不足しているカラムを推論します。TiDB Cloud Lake が stage 上のファイルをどのようにサンプリングするかを上書きしたい場合にのみ、SCHEMA_EVOLUTION を追加してください。
CREATE OR REPLACE TABLE events(id INT);
ALTER TABLE events SET OPTIONS(ENABLE_SCHEMA_EVOLUTION = true);

-- Assume @events_stage contains NDJSON records such as:
-- {"id":1,"city":"SF","score":9}
COPY INTO events
    FROM @events_stage/
    FILE_FORMAT = (TYPE = NDJSON MISSING_FIELD_AS = FIELD_DEFAULT)
    SCHEMA_EVOLUTION = (
        SAMPLE_FILES = AUTO,
        SAMPLE_RECORDS_PER_FILE = AUTO,
        SAMPLE_TOTAL_RECORDS = AUTO
    );
TiDB Cloud Lake は stage 上の NDJSON ファイルをサンプリングし、city や score などの推論されたフィールドを NULL 許容カラムとして追加してから、データをロードします。
詳細は、Schema Evolution を参照してください。