TiDB Cloud Lake vs. Snowflake: データ取り込みベンチマーク
概要
TiDB Cloud Lake と Snowflake を評価するために、次の 4 つのベンチマークを実施しました。
- TPC-H SF100 データセットのロード: 大規模データセット(100GB、約 6 億行)のロード性能とコストに焦点を当てます。
- ClickBench Hits データセットのロード: ワイドテーブルのデータセット(76GB、約 1 億行、105 カラム)のロード効率をテストし、多数のカラムに伴う課題を重視します。
- 1 秒の鮮度: 1 秒という厳しい鮮度要件内でデータを取り込むプラットフォームの能力を測定します。
- 5 秒の鮮度: 5 秒の鮮度制約下での各プラットフォームのデータ取り込み能力を比較します。
プラットフォーム
- Snowflake: スケーラブルなコンピュートとデータ共有を重視した、広く知られたクラウドデータプラットフォームです。
- TiDB Cloud Lake: スケーラビリティとコスト効率に重点を置いたクラウドネイティブのデータウェアハウスです。
ベンチマーク条件
同じ S3 バケットのデータを使用し、Small-Size Warehouse で実施しました。
性能とコストの比較
- TPC-H SF100 データ: TiDB Cloud Lake は Snowflake と比べて 48% のコスト削減を実現します。
- ClickBench Hits データ: TiDB Cloud Lake は 84% のコスト削減を達成します。
- 1 秒の鮮度: TiDB Cloud Lake は Snowflake より 400 倍多くのデータをロードします。
- 5 秒の鮮度: TiDB Cloud Lake は 27 倍超のデータをロードします。
データ取り込みベンチマーク
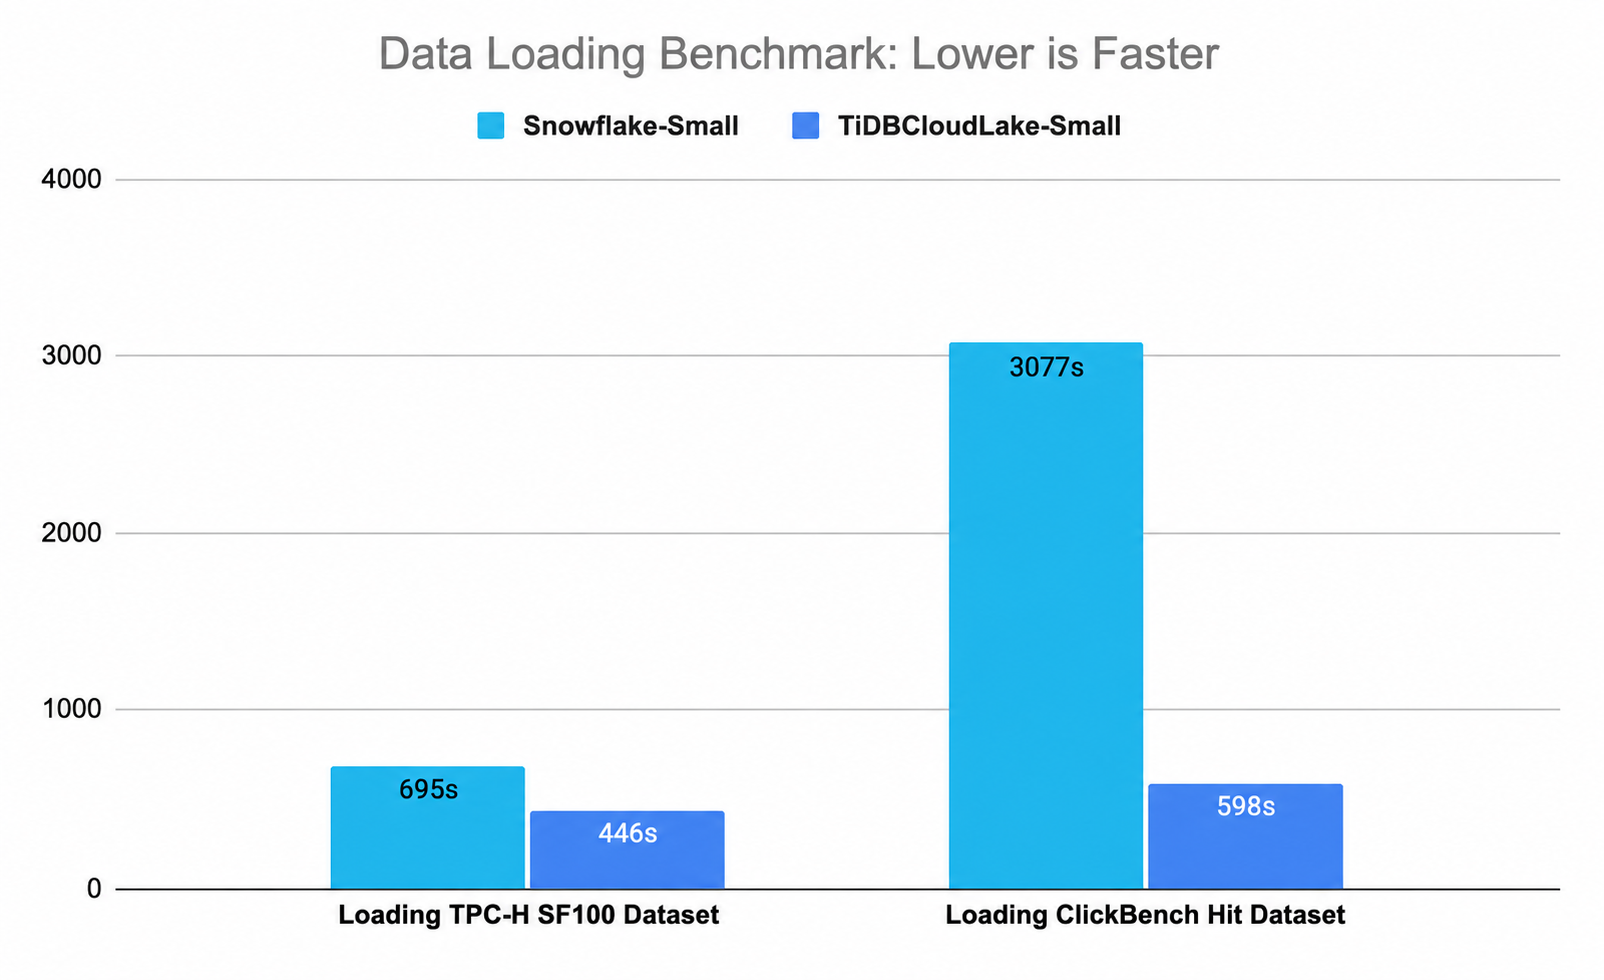
TPC-H SF100 データセット
- データ量: 100GB
- 行数: 約 6 億
ClickBench Hits データセット
- データ量: 76GB
- 行数: 約 1 億
- テーブル幅: 105 カラム
鮮度ベンチマーク
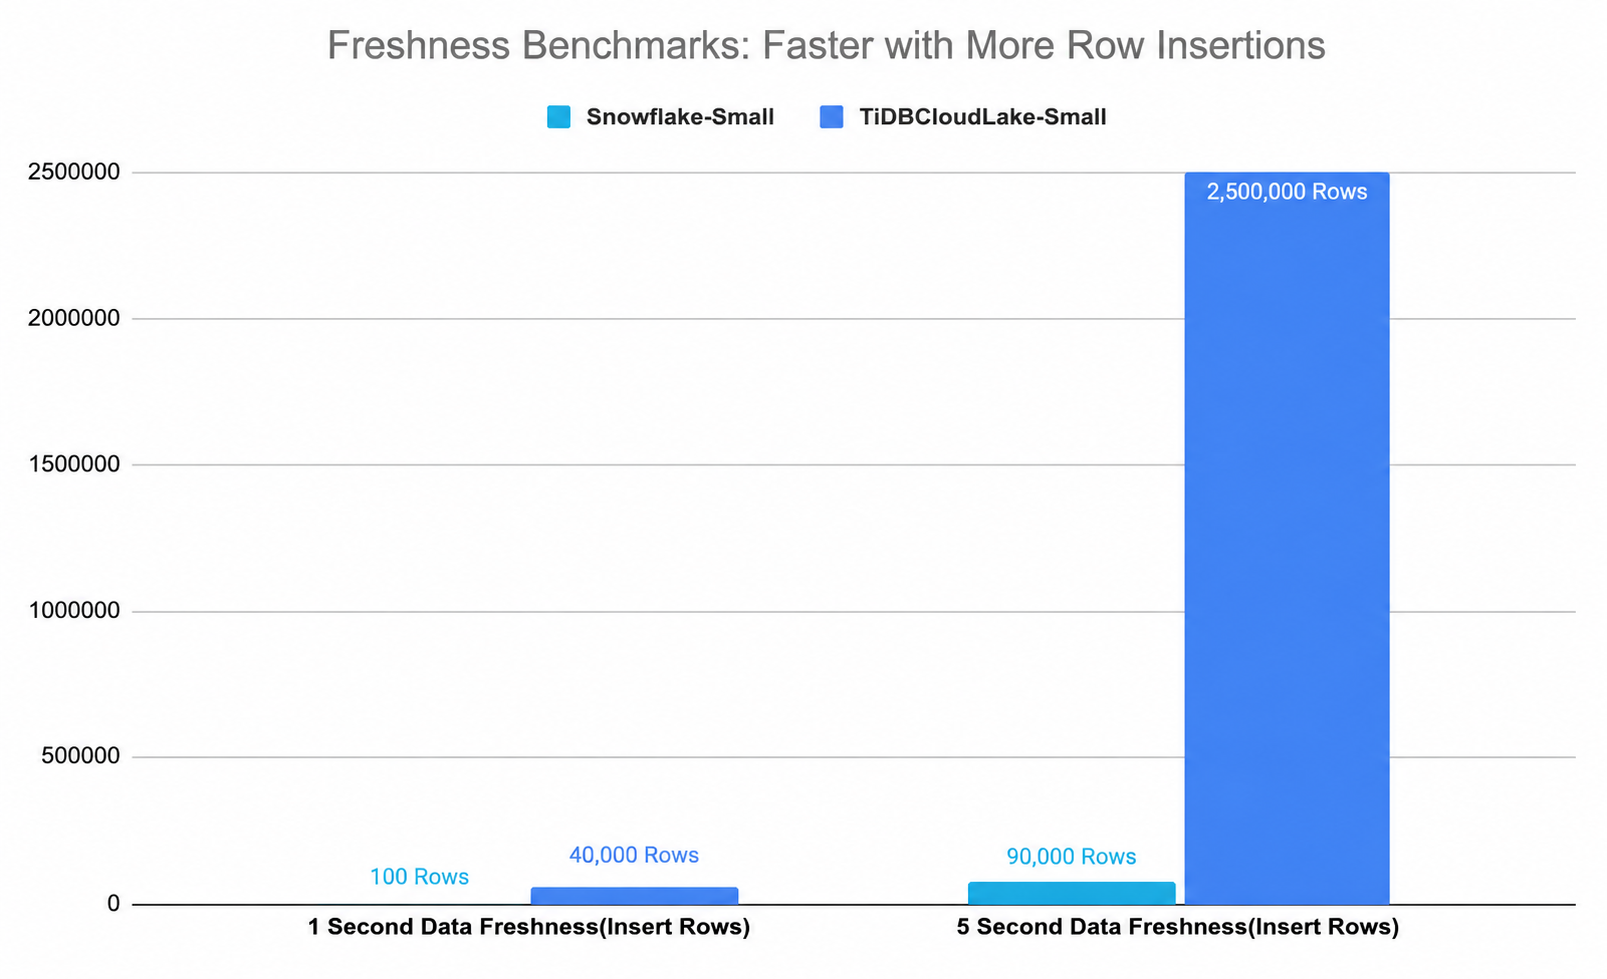
1 秒鮮度ベンチマーク
1 秒の鮮度要件内で取り込まれるデータ量を評価します。
5 秒鮮度ベンチマーク
5 秒の鮮度要件内で取り込めるデータ量を評価します。
ベンチマークの再現
以下の手順に従って、このベンチマークを再現できます。
ベンチマーク環境
このベンチマークでは、Snowflake と TiDB Cloud Lake の両方を同様の条件でテストしています。
- TPC-H SF100 データセットは、Amazon Redshift をソースとしています。
- ClickBench データセットは、ClickBench をソースとしています。
前提条件
- Snowflake アカウント を持っていること
- TiDB Cloud Lake アカウント を作成すること
データ取り込みベンチマーク
データ取り込みベンチマークは、次の手順で再現できます。
TPC-H データロード
Snowflake のデータロード:
- Snowflake アカウント にログインします。
- TPC-H スキーマに対応するテーブルを作成します。SQL スクリプト。
COPY INTOコマンドを使用して AWS S3 からデータをロードします。SQL スクリプト。
TiDB Cloud Lake のデータロード:
- TiDB Cloud Lake アカウント にサインインします。
- TPC-H スキーマに従って必要なテーブルを作成します。SQL スクリプト。
- Snowflake と同様の方法で AWS S3 からデータをロードします。SQL スクリプト。
ClickBench Hits データロード
Snowflake のデータロード:
- Snowflake アカウント にログインします。
hitsスキーマに対応するテーブルを作成します。SQL スクリプト。COPY INTOコマンドを使用して AWS S3 からデータをロードします。SQL スクリプト。
TiDB Cloud Lake のデータロード:
- TiDB Cloud Lake アカウント にサインインします。
hitsスキーマに従って必要なテーブルを作成します。SQL スクリプト。- Snowflake と同様の方法で AWS S3 からデータをロードします。SQL スクリプト。
鮮度ベンチマーク
鮮度ベンチマークのデータ生成とデータ取り込みは、次の手順で再現できます。
TiDB Cloud Lake で 外部 stage を作成します。
CREATE STAGE hits_unload_stage
URL = 's3://unload/files/'
CONNECTION = (
    ACCESS_KEY_ID = '<your-access-key-id>',
    SECRET_ACCESS_KEY = '<your-secret-access-key>'
);
データを外部 stage にアンロード (unload) します。
CREATE or REPLACE FILE FORMAT tsv_unload_format_gzip
    TYPE = TSV,
    COMPRESSION = gzip;

COPY INTO @hits_unload_stage
FROM (
    SELECT *
    FROM hits limit <the-rows-you-want>
)
FILE_FORMAT = (FORMAT_NAME = 'tsv_unload_format_gzip')
DETAILED_OUTPUT = true;
外部 stage から
hitsテーブルにデータをロード (load) します。COPY INTO hits FROM @hits_unload_stage PATTERN = '.*[.]tsv.gz' FILE_FORMAT = (TYPE = TSV, COMPRESSION=auto);ダッシュボードで結果を測定します。