计算集群
计算集群是 TiDB Cloud Lake 的核心组件。计算集群表示一组计算资源,包括 CPU、内存和本地缓存。你必须运行一个计算集群才能执行 SQL 任务,例如:
- 使用 SELECT 语句查询数据
- 使用 INSERT、UPDATE 或 DELETE 语句修改数据
- 使用 COPY INTO 命令将数据加载到表中
运行计算集群会产生费用。更多信息,请参见计算集群定价。
计算集群规格
在 TiDB Cloud Lake 中,计算集群提供多种规格,每种规格由其可处理的最大并发查询数定义。创建计算集群时,你可以从以下规格中进行选择:
为了选择合适的计算集群规格,TiDB Cloud Lake 建议从较小的规格开始。与中型或大型计算集群相比,较小的计算集群执行 SQL 任务可能需要更长时间。如果你发现查询执行时间过长(例如数分钟),请考虑扩展到中型或大型计算集群以获得更快的结果。
管理计算集群
一个组织可以根据需要拥有任意数量的计算集群。Warehouses 页面会显示你组织中的所有计算集群,并允许你对其进行管理。请注意,只有 account_admin 才能创建或删除计算集群。
提示:
你也可以使用 SQL 命令管理计算集群。详情请参见 计算集群 DDL 命令。
暂停 / 恢复计算集群
已暂停的计算集群不会消耗任何 credits。你可以通过点击计算集群上的 或 按钮手动暂停或恢复计算集群。不过,在以下场景中,计算集群也可以自动暂停或恢复:
- 如果没有活动,计算集群可以根据其自动暂停设置自动暂停。
- 当你选择一个已暂停的计算集群来执行 SQL 任务时,该计算集群会自动恢复。
执行批量操作
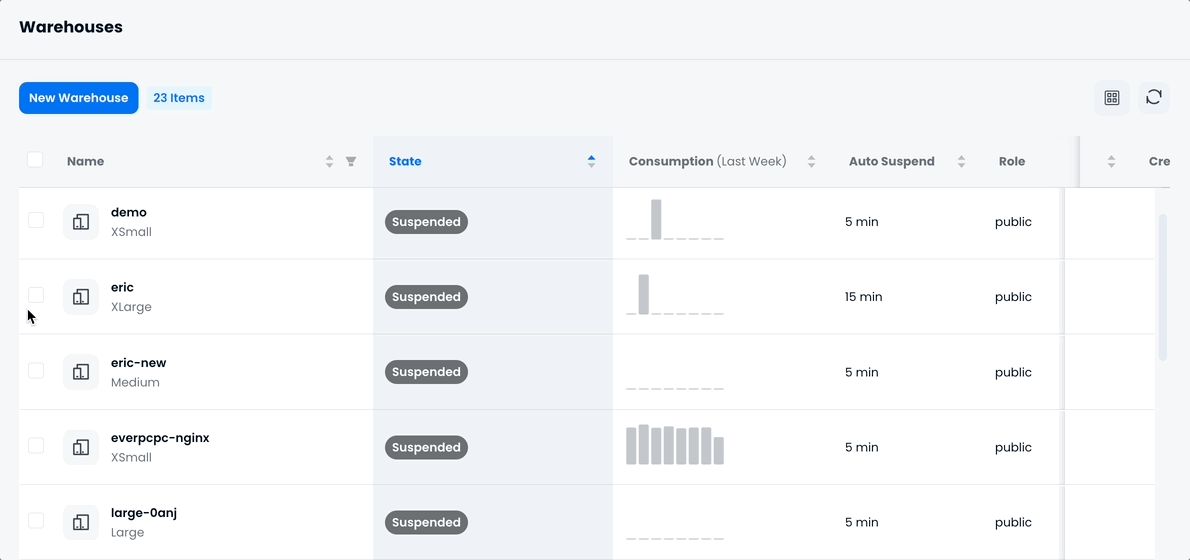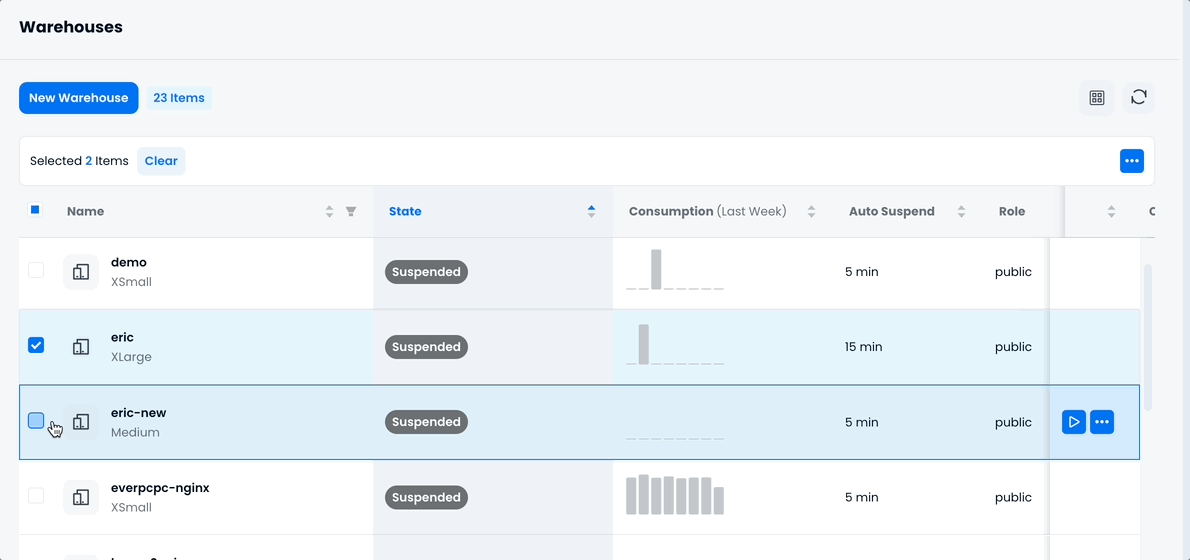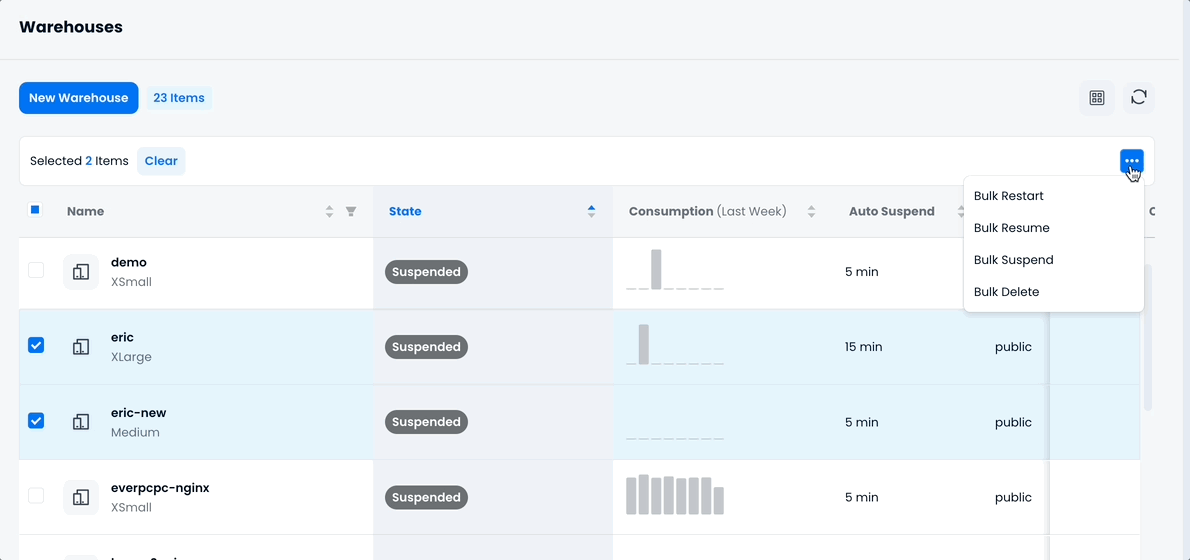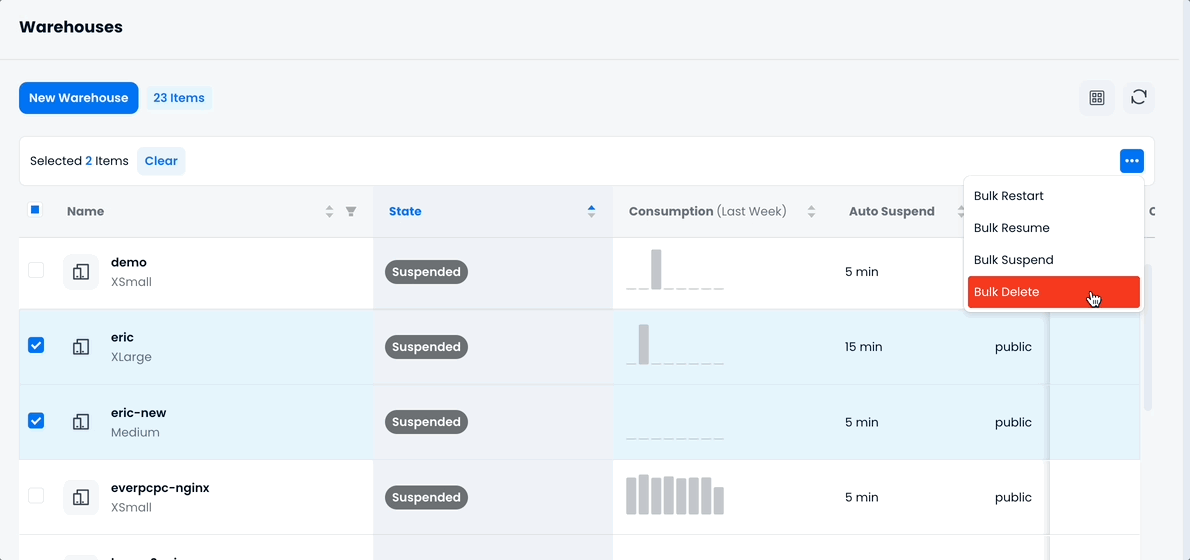
你可以对计算集群执行批量操作,包括批量重启、批量暂停、批量恢复和批量删除。为此,请在计算集群列表中勾选复选框 以选择要批量操作的计算集群,然后点击省略号按钮 执行所需操作。
为计算集群添加标签
你可以为计算集群附加标签,以便对其进行组织和分类,例如按环境、团队或成本中心分类。标签是键值对,会显示在计算集群列表中,你可以按标签进行筛选和排序。
约束:
- 每个计算集群最多 10 个标签
- 键:最多 128 个字符
- 值:最多 256 个字符
要添加标签,请在创建或编辑计算集群时展开 Tags 部分,并输入你的键值对。
标签会在计算集群列表中显示为 key: value,并可用于按键或值筛选计算集群。
最佳实践
为了有效管理你的计算集群并确保最佳性能和成本效率,请参考以下最佳实践。这些指南将帮助你针对不同负载和环境合理设置计算集群规格、组织方式并进行细致调优:
选择合适的规格
- 对于 开发与测试,使用较小的计算集群(XSmall、Small)。
- 对于 生产环境,选择较大的计算集群(Medium、Large、XLarge)。
分离计算集群
- 为数据加载和查询执行使用不同的计算集群。
- 为 开发、测试 和 生产 环境创建独立的计算集群。
数据加载建议
- 较小的计算集群(Small、Medium)适合数据加载。
- 优化文件大小和文件数量以提升性能。
优化成本与性能
- 避免运行
SELECT 1之类的简单查询,以尽量减少 credits 使用量。 - 使用批量加载(
COPY),而不是逐条执行INSERT语句。 - 监控长时间运行的查询,并对其进行优化以提升性能。
- 避免运行
自动暂停
- 在计算集群空闲时启用自动暂停以节省 credits。
对频繁查询禁用自动暂停
- 对于频繁或重复的查询,保持计算集群处于活动状态,以维持缓存并避免延迟。
使用自动扩缩容(仅限 Business 和 Dedicated 计划)
- 多集群扩缩容会根据工作负载需求自动调整资源。
监控并调整使用情况
- 定期检查计算集群使用情况,并根据需要调整规格,以平衡成本和性能。
计算集群访问控制
TiDB Cloud Lake 允许你通过基于角色的控制来管理计算集群访问权限,即为计算集群分配特定角色,从而只有拥有该角色的用户才能访问该计算集群。
要为计算集群分配角色,请在创建或修改计算集群时,在 Advanced Options 中选择所需角色:
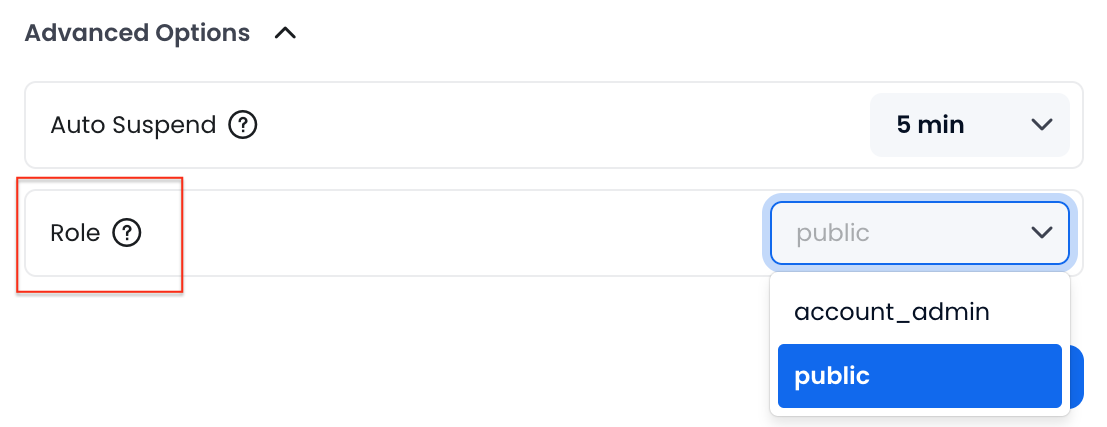
可供选择的有两个内置角色,你也可以使用 CREATE ROLE 命令创建其他角色。有关 TiDB Cloud Lake 角色的更多信息,请参见 角色。
未分配角色的计算集群默认使用
public角色,允许所有用户访问。你可以使用 GRANT 命令将角色授予用户(TiDB Cloud Lake 登录邮箱或 SQL 用户)。以下示例将角色
manager授予邮箱为name@example.com的用户,从而允许其访问任何分配给manager角色的计算集群:GRANT ROLE manager to 'name@example.com';
多集群计算集群
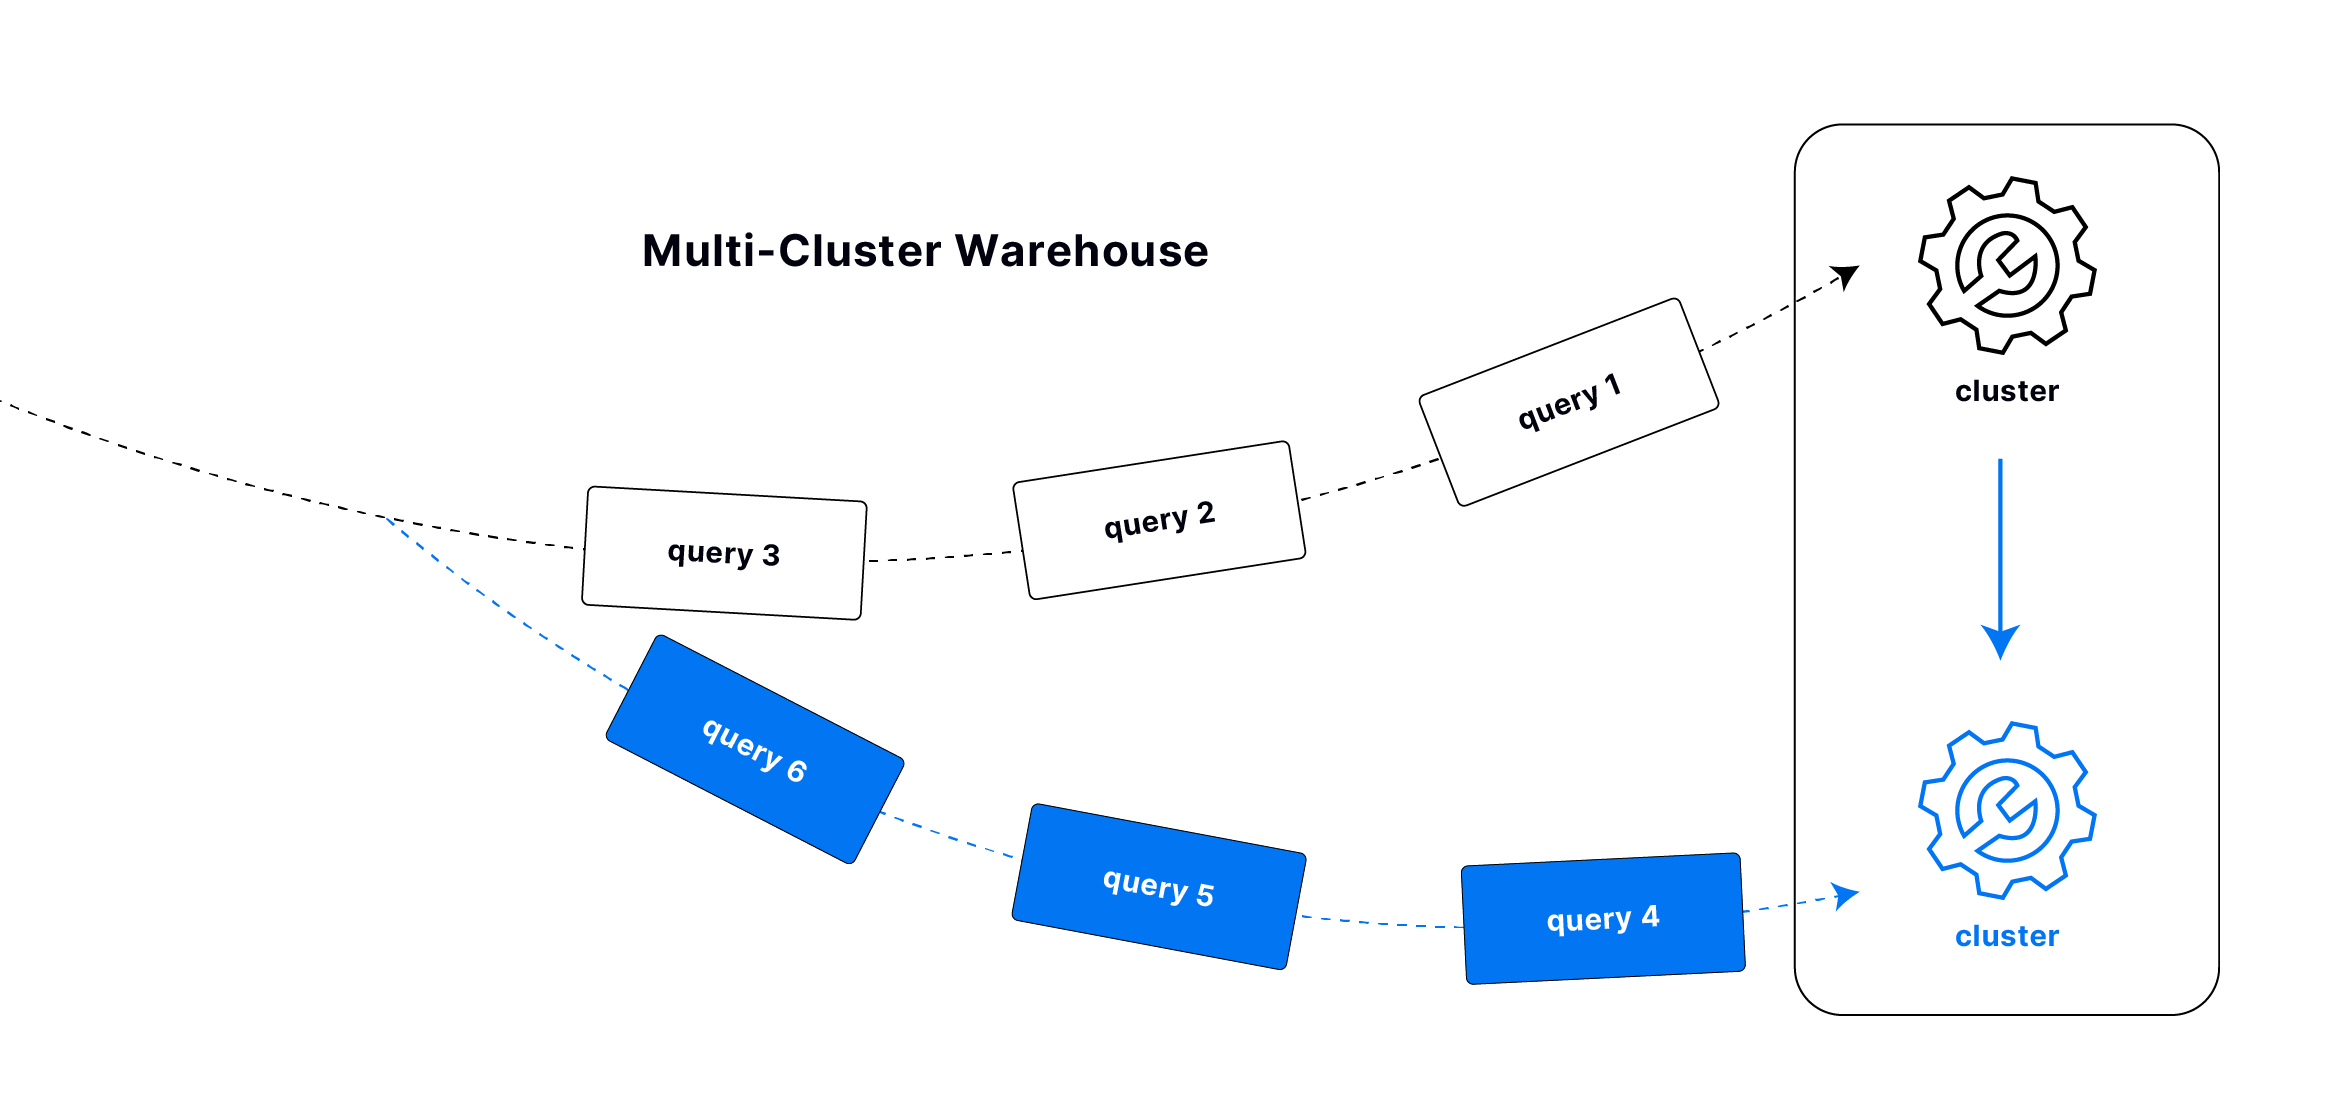
多集群计算集群会根据工作负载需求,通过添加或移除集群自动调整计算资源。它在根据需要扩容或缩容的同时,确保高并发和性能,并优化成本。
工作原理
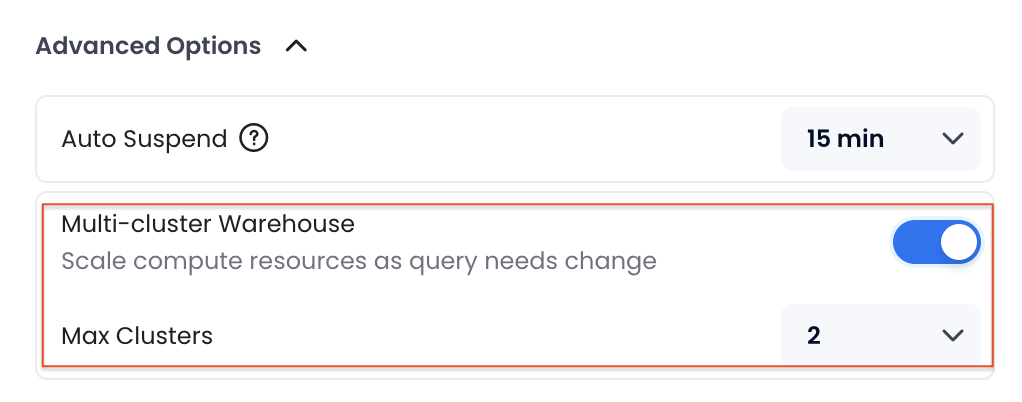
默认情况下,一个计算集群由单个计算资源集群组成,其可处理的最大并发查询数取决于其规格。当为某个计算集群启用 Multi-Cluster 后,它允许动态添加多个集群(由 Max Clusters 设置定义),以处理超出单个集群容量的工作负载。
当并发查询数量超过你的计算集群容量时,系统会添加一个额外集群来处理额外负载。如果需求持续增长,则会逐个添加更多集群。随着查询需求下降,超过 Auto Suspend 时长仍无活动的集群会被自动关闭。
启用 Multi-Cluster
你可以在创建计算集群时为其启用 Multi-Cluster,并设置该计算集群最多可以扩展到的集群数量。请注意,如果为某个计算集群启用了 Multi-Cluster,则 Auto Suspend 时长必须至少设置为 15 分钟。
成本计算
多集群计算集群按特定时间区间内使用的活动集群数量计费。
例如,对于一个价格为每小时 $1.6 的 XSmall 计算集群,如果从 13:00 到 14:00 有一个集群处于活动状态,而从 14:00 到 15:00 有两个集群处于活动状态,则从 13:00 到 15:00 产生的总费用为 $4.8((1 cluster × 1 hour × $1.6) + (2 clusters × 1 hour × $1.6))。
MySQL Endpoint
MySQL Endpoint 功能使计算集群能够接受来自仅支持 MySQL 协议的 BI 工具和应用程序的连接,例如 Tableau、Grafana 或其他兼容 MySQL 的客户端。
启用 MySQL Endpoint
你可以在创建计算集群时启用 MySQL Endpoint,也可以稍后修改时启用。该选项位于 Advanced Options 部分,以切换开关的形式提供。
通过 MySQL 协议连接
启用后,你可以使用任何兼容 MySQL 的客户端,通过 Connect 对话框中显示的标准 MySQL 连接信息连接到该计算集群。这对于集成那些原生不支持 TiDB Cloud Lake 协议的工具非常有用。
连接到计算集群
连接到计算集群可提供在 TiDB Cloud Lake 中运行查询和分析数据所需的计算资源。当你从应用程序或 SQL 客户端访问 TiDB Cloud Lake 时,需要建立此连接。
连接方式
TiDB Cloud Lake 支持多种连接方式,以满足你的特定需求。
SQL 客户端与工具
开发者驱动
获取连接信息
要获取某个计算集群 (Warehouse) 的连接信息,请执行以下操作:
- 点击 Overview > Connect。
- 选择要连接的 Database 和 Warehouse。连接信息会根据你的选择自动更新。
- 连接详情中包含一个名为
cloudapp的 SQL 用户及其随机生成的密码。TiDB Cloud Lake 不会存储该密码。请务必复制并安全保存。如果忘记密码,请点击 Reset 生成新密码(需要 Admin 才能重置)。
连接字符串格式
当你点击 Connect 时,TiDB Cloud Lake 会自动生成连接字符串:
lake://<username>:<password>@<tenant>.gw.<region>.default.tidbcloud.com:443/<database>?warehouse=<warehouse_name>
其中:
<username>:默认为cloudapp<password>:点击 Reset 可查看或修改<tenant>、<region>:你的账户信息(显示在连接详情中)<database>:所选数据库(显示在连接详情中)<warehouse_name>:所选计算集群(显示在连接详情中)
创建用于访问计算集群的 SQL 用户
除了默认的 cloudapp 用户外,你还可以创建额外的 SQL 用户,以获得更好的安全性和访问控制。
示例 1:跨所有数据库的完全访问权限
为用户授予对所有数据库的读写访问权限——适用于需要跨数据库操作的管理员账户或自动化流水线:
-- Create a role with global access
CREATE ROLE full_access_role;
GRANT ALL ON *.* TO ROLE full_access_role;

-- Create the user and assign the role
CREATE USER admin_user IDENTIFIED BY 'SecurePass456!' WITH DEFAULT_ROLE = 'full_access_role';
GRANT ROLE full_access_role TO admin_user;
示例 2:单个数据库访问权限
仅授予用户访问某个特定数据库的权限:
-- Create a role scoped to one database
CREATE ROLE warehouse_user1_role;
GRANT ALL ON my_database.* TO ROLE warehouse_user1_role;

-- Create a new SQL user and assign the role
CREATE USER warehouse_user1 IDENTIFIED BY 'StrongPassword123' WITH DEFAULT_ROLE = 'warehouse_user1_role';
GRANT ROLE warehouse_user1_role TO warehouse_user1;
示例 3:跨所有数据库的只读访问权限
适用于用户只应执行数据查询的场景(例如仪表盘、BI 工具、安全模式下的 AI 代理):
-- Create a read-only role
CREATE ROLE readonly_role;
GRANT SELECT ON *.* TO ROLE readonly_role;

-- Create the user
CREATE USER readonly_user IDENTIFIED BY 'ReadOnly789!' WITH DEFAULT_ROLE = 'readonly_role';
GRANT ROLE readonly_role TO readonly_user;
提示:
在 TiDB Cloud Lake 中,
CREATE DATABASE这类权限只能授予角色,不能直接授予用户。请始终先创建角色,再将权限授予该角色,最后把角色分配给用户。
更多信息,请参见 CREATE USER 和 GRANT 文档。
连接安全
所有到 TiDB Cloud Lake 计算集群的连接默认都使用 TLS 加密。对于需要更高安全性的企业用户,可以使用 AWS PrivateLink 在你的 VPC 与 TiDB Cloud Lake 之间建立私有连接。