Amazon S3 統合タスク
このページでは、S3 バケットから TiDB Cloud Lake にファイルをインポートする Amazon S3 統合タスクを作成する方法について説明します。CSV、Parquet、NDJSON のファイル形式がサポートされており、タスクは一度限りのインポートまたは継続的な取り込みとして設定できます。
再利用可能な AWS 認証情報を先に作成する必要がある場合は、Amazon S3 - Credentials を参照してください。
サポートされるファイル形式
前提条件
- Amazon S3 - Credentials データソースがすでに作成されていること
- AWS 認証情報に対象の S3 バケットへの読み取りアクセス権があること
- Clean Up Original Files を有効にする予定がある場合、認証情報には書き込み権限と削除権限も必要です
S3 統合タスクの作成
ステップ 1: 基本情報
Data > Data Integration に移動し、Create Task をクリックします。
S3 データソースを選択し、基本設定を構成します。
CSV オプション
ファイルタイプが CSV の場合、追加オプションを利用できます。
ファイルパスパターン
ファイルパスでは、複数のファイルに一致させるためのワイルドカードパターンをサポートしています。
s3://mybucket/data/2025-*.csv        # All CSV files starting with "2025-"
s3://mybucket/logs/*.parquet         # All Parquet files in the logs directory
s3://mybucket/events/data.ndjson     # A single specific file
ステップ 2: データのプレビュー
基本設定を構成したら、Next をクリックしてソースデータをプレビューします。
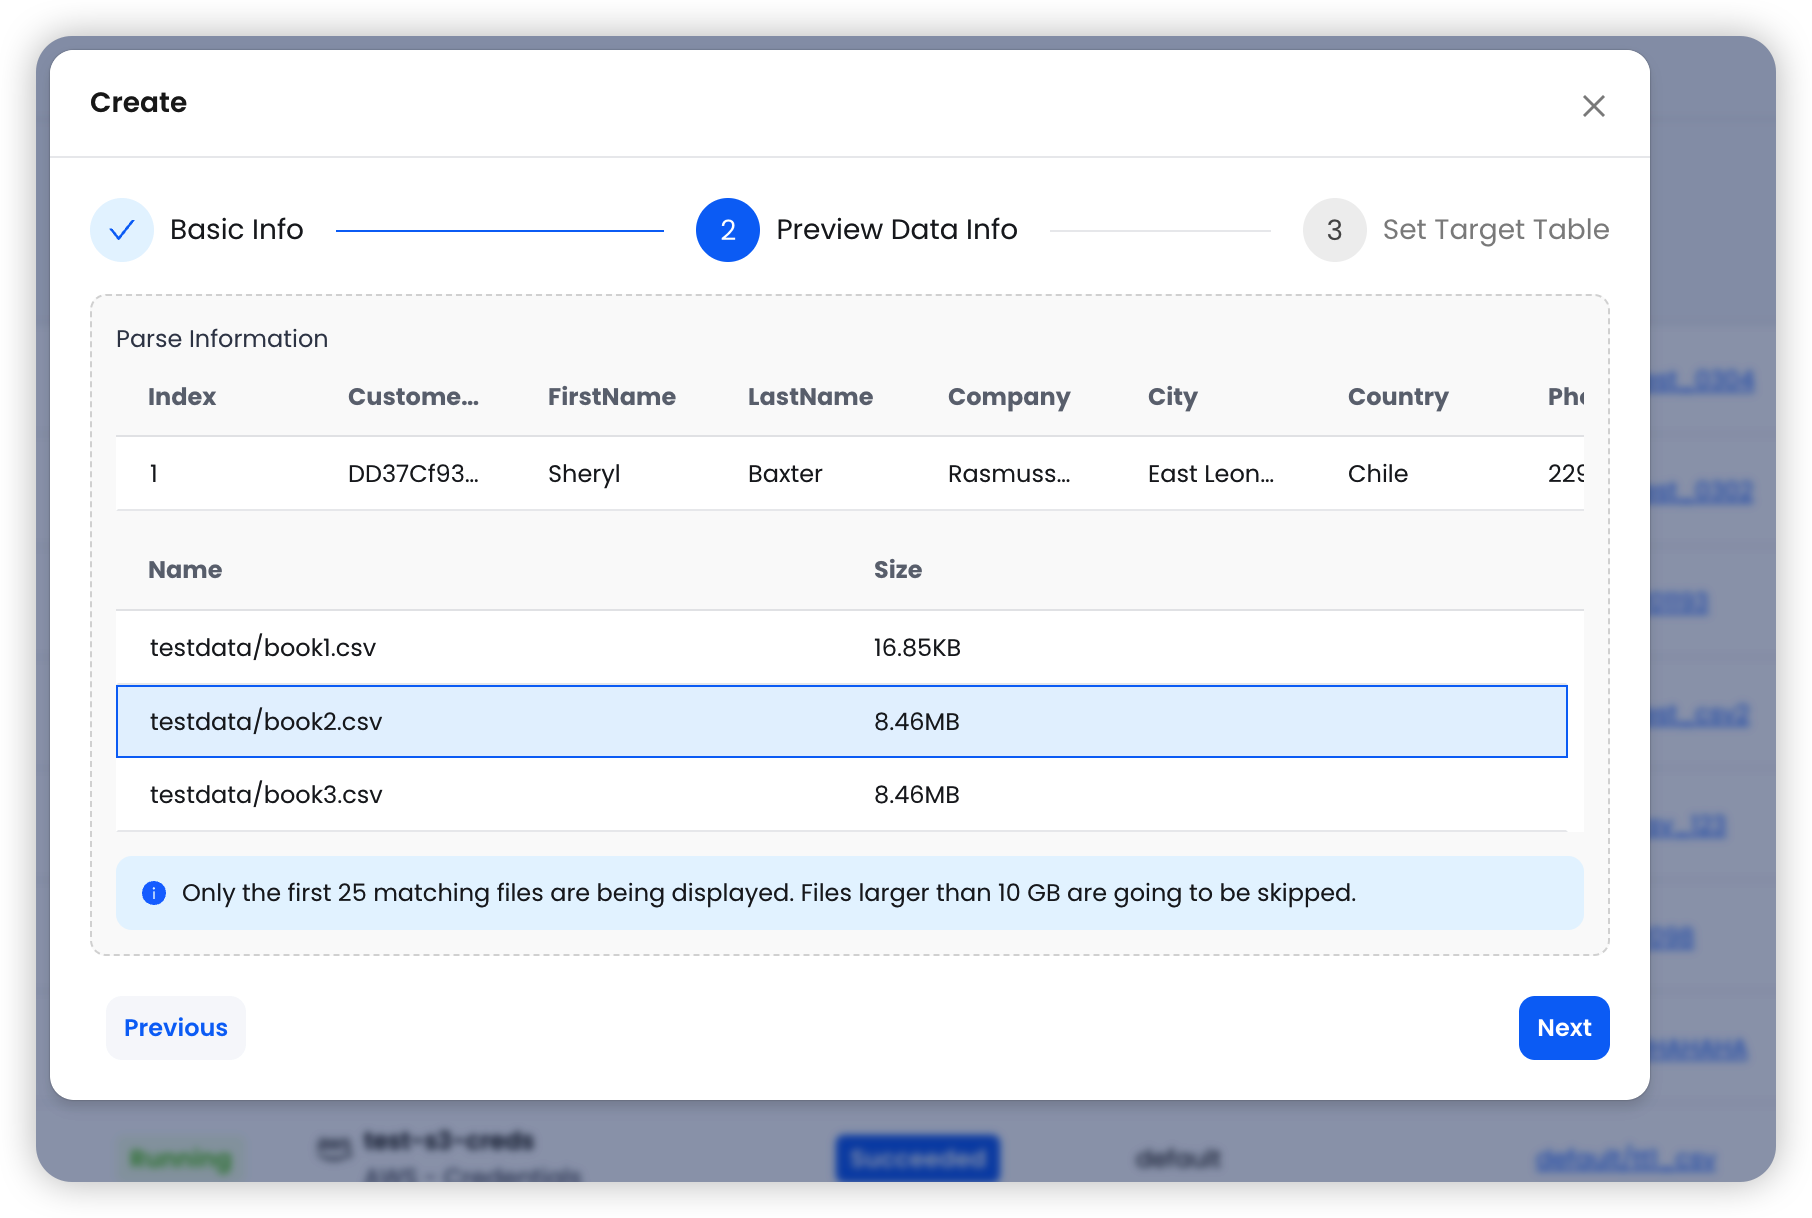
システムは最初に一致したファイルを読み取り、次を表示します。
- カラム名と型を含むサンプルデータ
- 一致したファイルの一覧(最大 25 ファイル)とそのサイズ
ステップ 3: ターゲットテーブルの設定
TiDB Cloud Lake の宛先を構成します。
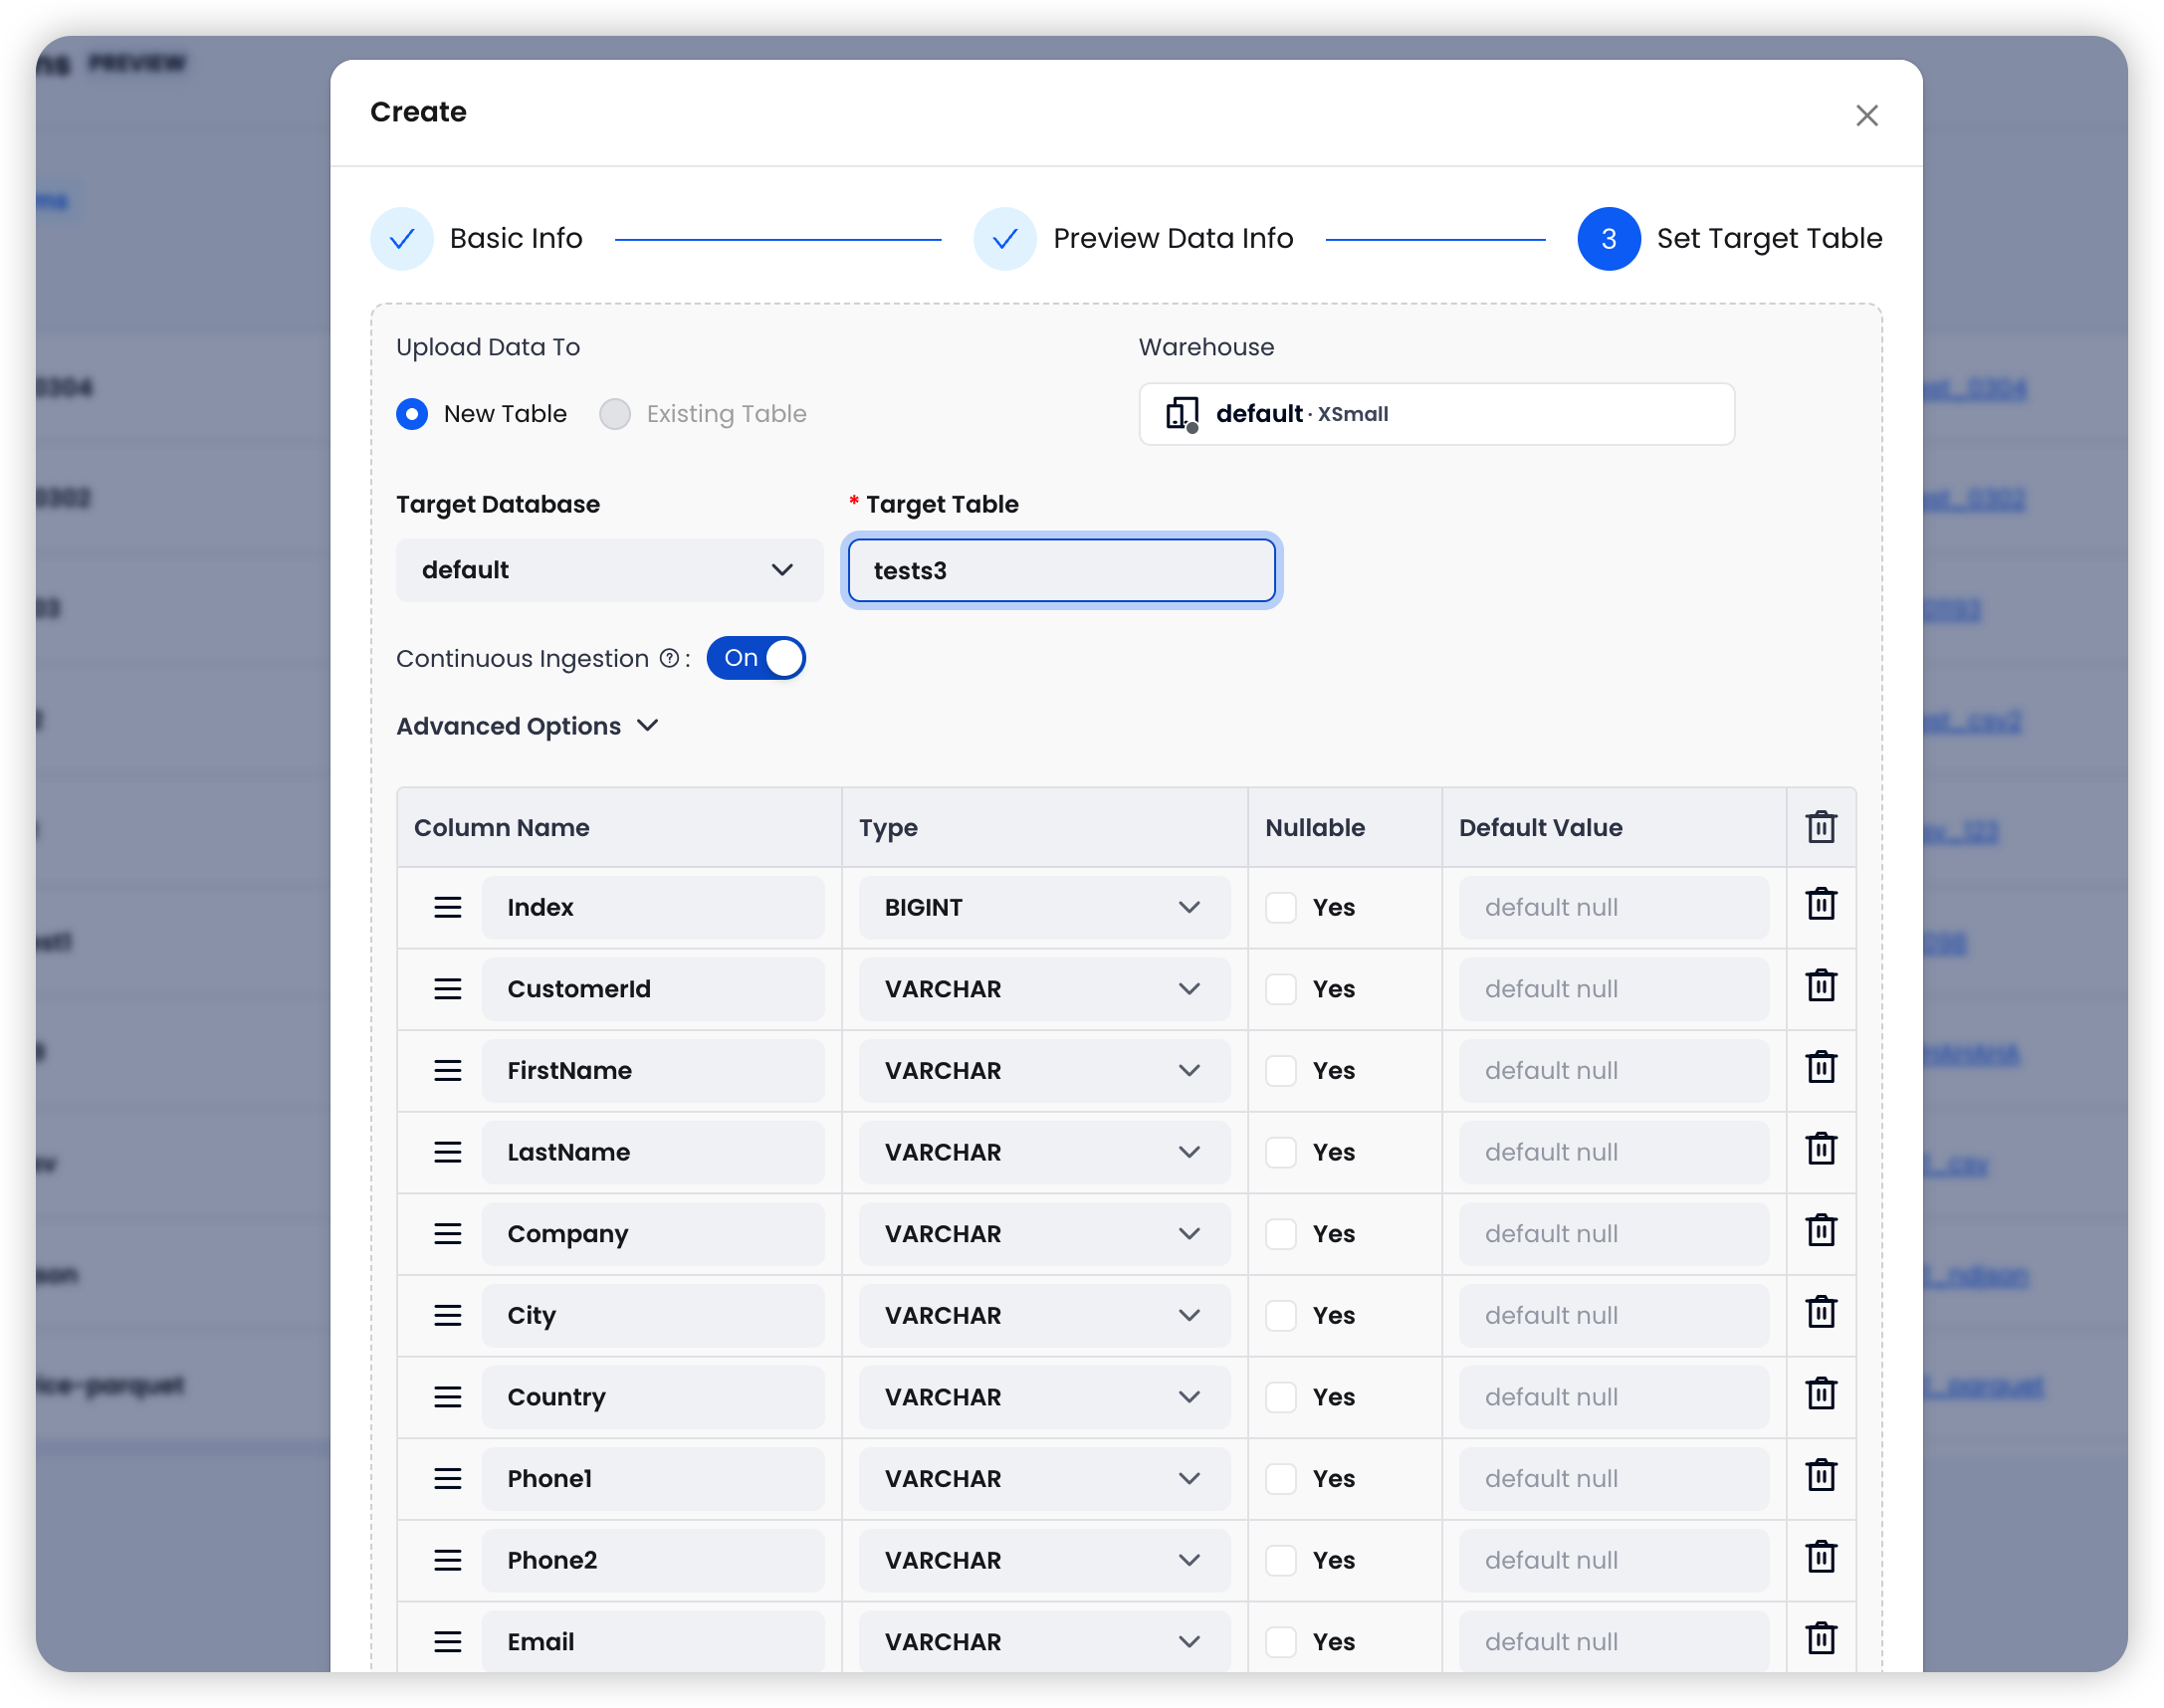
システムはソースファイルからカラムを自動検出します。続行する前に、カラム名と型を確認および編集できます。
取り込みオプション
統合タスクを確定するには、Create をクリックします。
タスクの動作
詳細設定
継続的な取り込み
有効にすると、タスクは長時間実行されるプロセスとして動作し、定期的に S3 パスをスキャンして新しいファイルを探します。各サイクルでは次を実行します。
- ファイルパスパターンに一致するオブジェクトを一覧表示する
- まだインポートされていない新しいファイルを特定する
COPY INTOを使用して新しいファイルをターゲットテーブルにインポートする- インポート結果をタスク履歴に記録する
これは、上流システムが継続的に新しいファイルを S3 に書き込むデータパイプラインで役立ちます。
エラーハンドリング
- Abort(デフォルト): 最初に発生したエラーでインポートを停止します。データ品質が重要で、続行前に問題を調査したい場合に使用します。
- Continue: エラーの原因となる行をスキップし、残りのデータのインポートを継続します。部分的なインポートを許容でき、データスループットを最大化したい場合に使用します。
Clean Up Original Files (PURGE)
有効にすると、ソースファイルは TiDB Cloud Lake へのインポート成功後に S3 から削除されます。これにより、ストレージコストの管理や再処理の防止に役立ちます。AWS 認証情報に対象バケットに対する s3:DeleteObject 権限があることを確認してください。
Allow Duplicate Imports (FORCE)
デフォルトでは、システムはどのファイルがインポート済みかを追跡し、後続の実行ではそれらをスキップします。このオプションを有効にすると、以前にインポートされたかどうかに関係なく、一致するすべてのファイルを強制的に再インポートします。これは、スキーマ変更やデータ修正の後にデータを再ロードする必要がある場合に役立ちます。