从 Snowflake 迁移到 TiDB Cloud Lake
能力:全量导入
本教程将指导你完成从 Snowflake 迁移数据到 TiDB Cloud Lake 的过程。迁移过程包括先将数据从 Snowflake 导出到 Amazon S3 存储桶,然后再将其加载到 TiDB Cloud Lake 中。整个过程分为三个主要步骤:
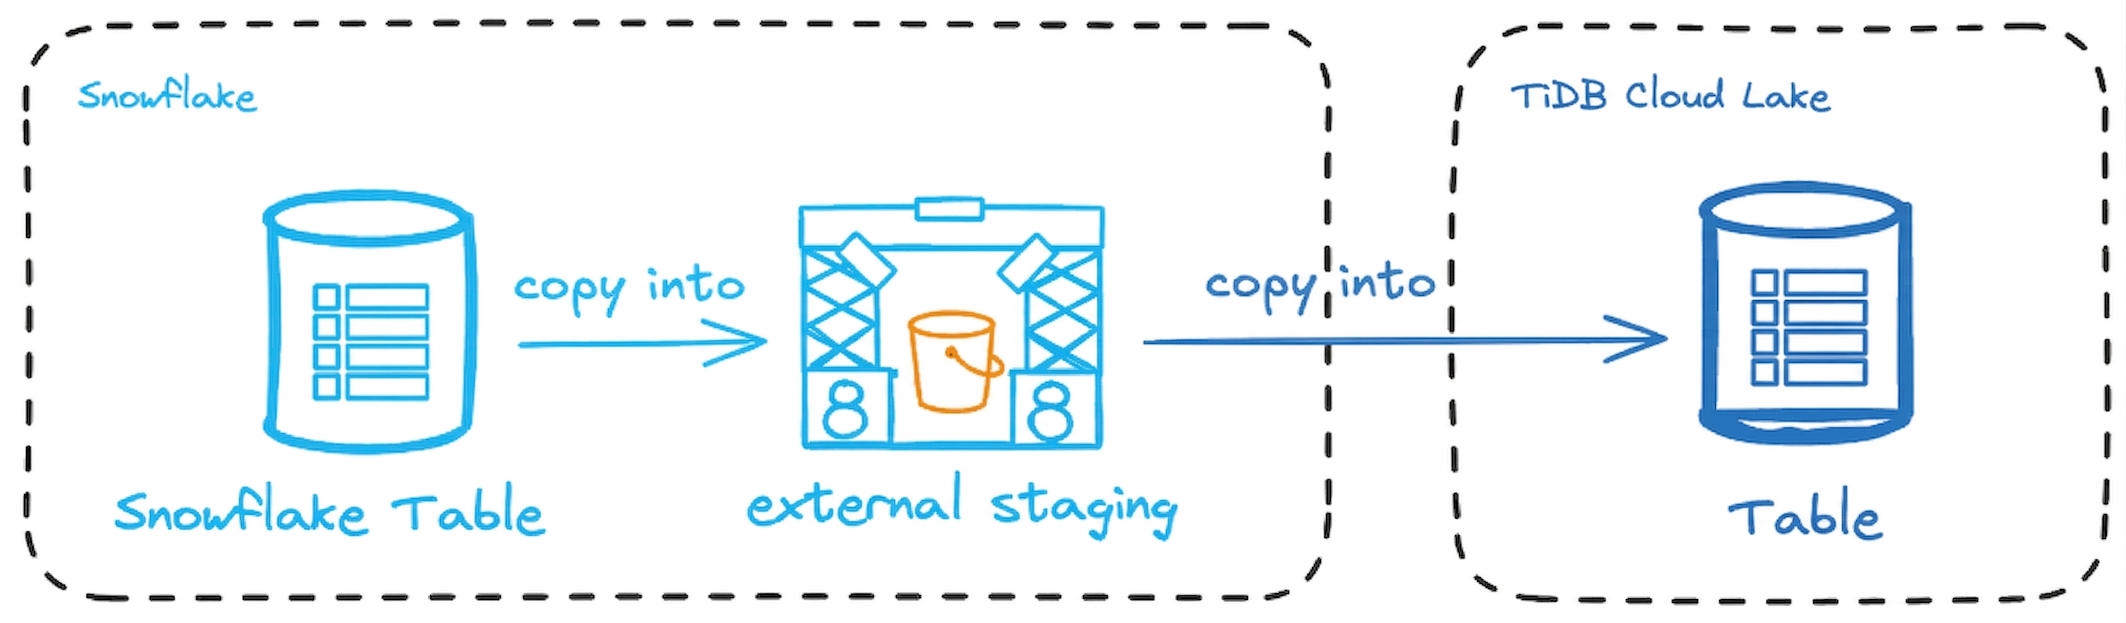
在本教程中,我们将指导你把 Snowflake 中的数据以 Parquet 格式导出到 Amazon S3 存储桶,然后再将其加载到 TiDB Cloud Lake 中。
开始之前
开始之前,请确保你已具备以下前提条件:
- Amazon S3 Bucket:一个用于存储导出数据的 S3 存储桶,以及上传文件所需的相应权限。了解如何创建 S3 存储桶。在本教程中,我们使用
s3://lake-doc/snowflake/作为导出数据的暂存位置。 - AWS Credentials:具有足够权限访问 S3 存储桶的 AWS Access Key ID 和 Secret Access Key。管理你的 AWS 凭证。
- 管理 IAM Roles 和 Policies 的权限:请确保你具有创建和管理 IAM roles 和 policies 所需的权限,这些权限用于配置 Snowflake 与 Amazon S3 之间的访问。了解 IAM roles 和 policies。
第 1 步:为 Amazon S3 配置 Snowflake Storage Integration
在这一步中,我们将配置 Snowflake 通过 IAM roles 访问 Amazon S3。首先,我们会创建一个 IAM role,然后使用该 role 建立 Snowflake Storage Integration,以实现安全的数据访问。
登录 AWS Management Console,然后在 IAM > Policies 中使用以下 JSON 代码创建一个 policy:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": [
        "s3:PutObject",
        "s3:GetObject",
        "s3:GetObjectVersion",
        "s3:DeleteObject",
        "s3:DeleteObjectVersion"
      ],
      "Resource": "arn:aws:s3:::lake-doc/snowflake/*"
    },
    {
      "Effect": "Allow",
      "Action": ["s3:ListBucket", "s3:GetBucketLocation"],
      "Resource": "arn:aws:s3:::lake-doc",
      "Condition": {
        "StringLike": {
          "s3:prefix": ["snowflake/*"]
        }
      }
    }
  ]
}
此 policy 适用于名为
lake-doc的 S3 存储桶,并且专门针对该存储桶中的snowflake文件夹。s3:PutObject,s3:GetObject,s3:GetObjectVersion,s3:DeleteObject,s3:DeleteObjectVersion:允许对 snowflake 文件夹中的对象执行操作(例如s3://lake-doc/snowflake/)。你可以在该文件夹中上传、读取和删除对象。s3:ListBucket,s3:GetBucketLocation:允许列出lake-doc存储桶中的内容并获取其位置。Condition元素确保列出操作仅限于snowflake文件夹中的对象。
在 IAM > Roles 中创建一个名为
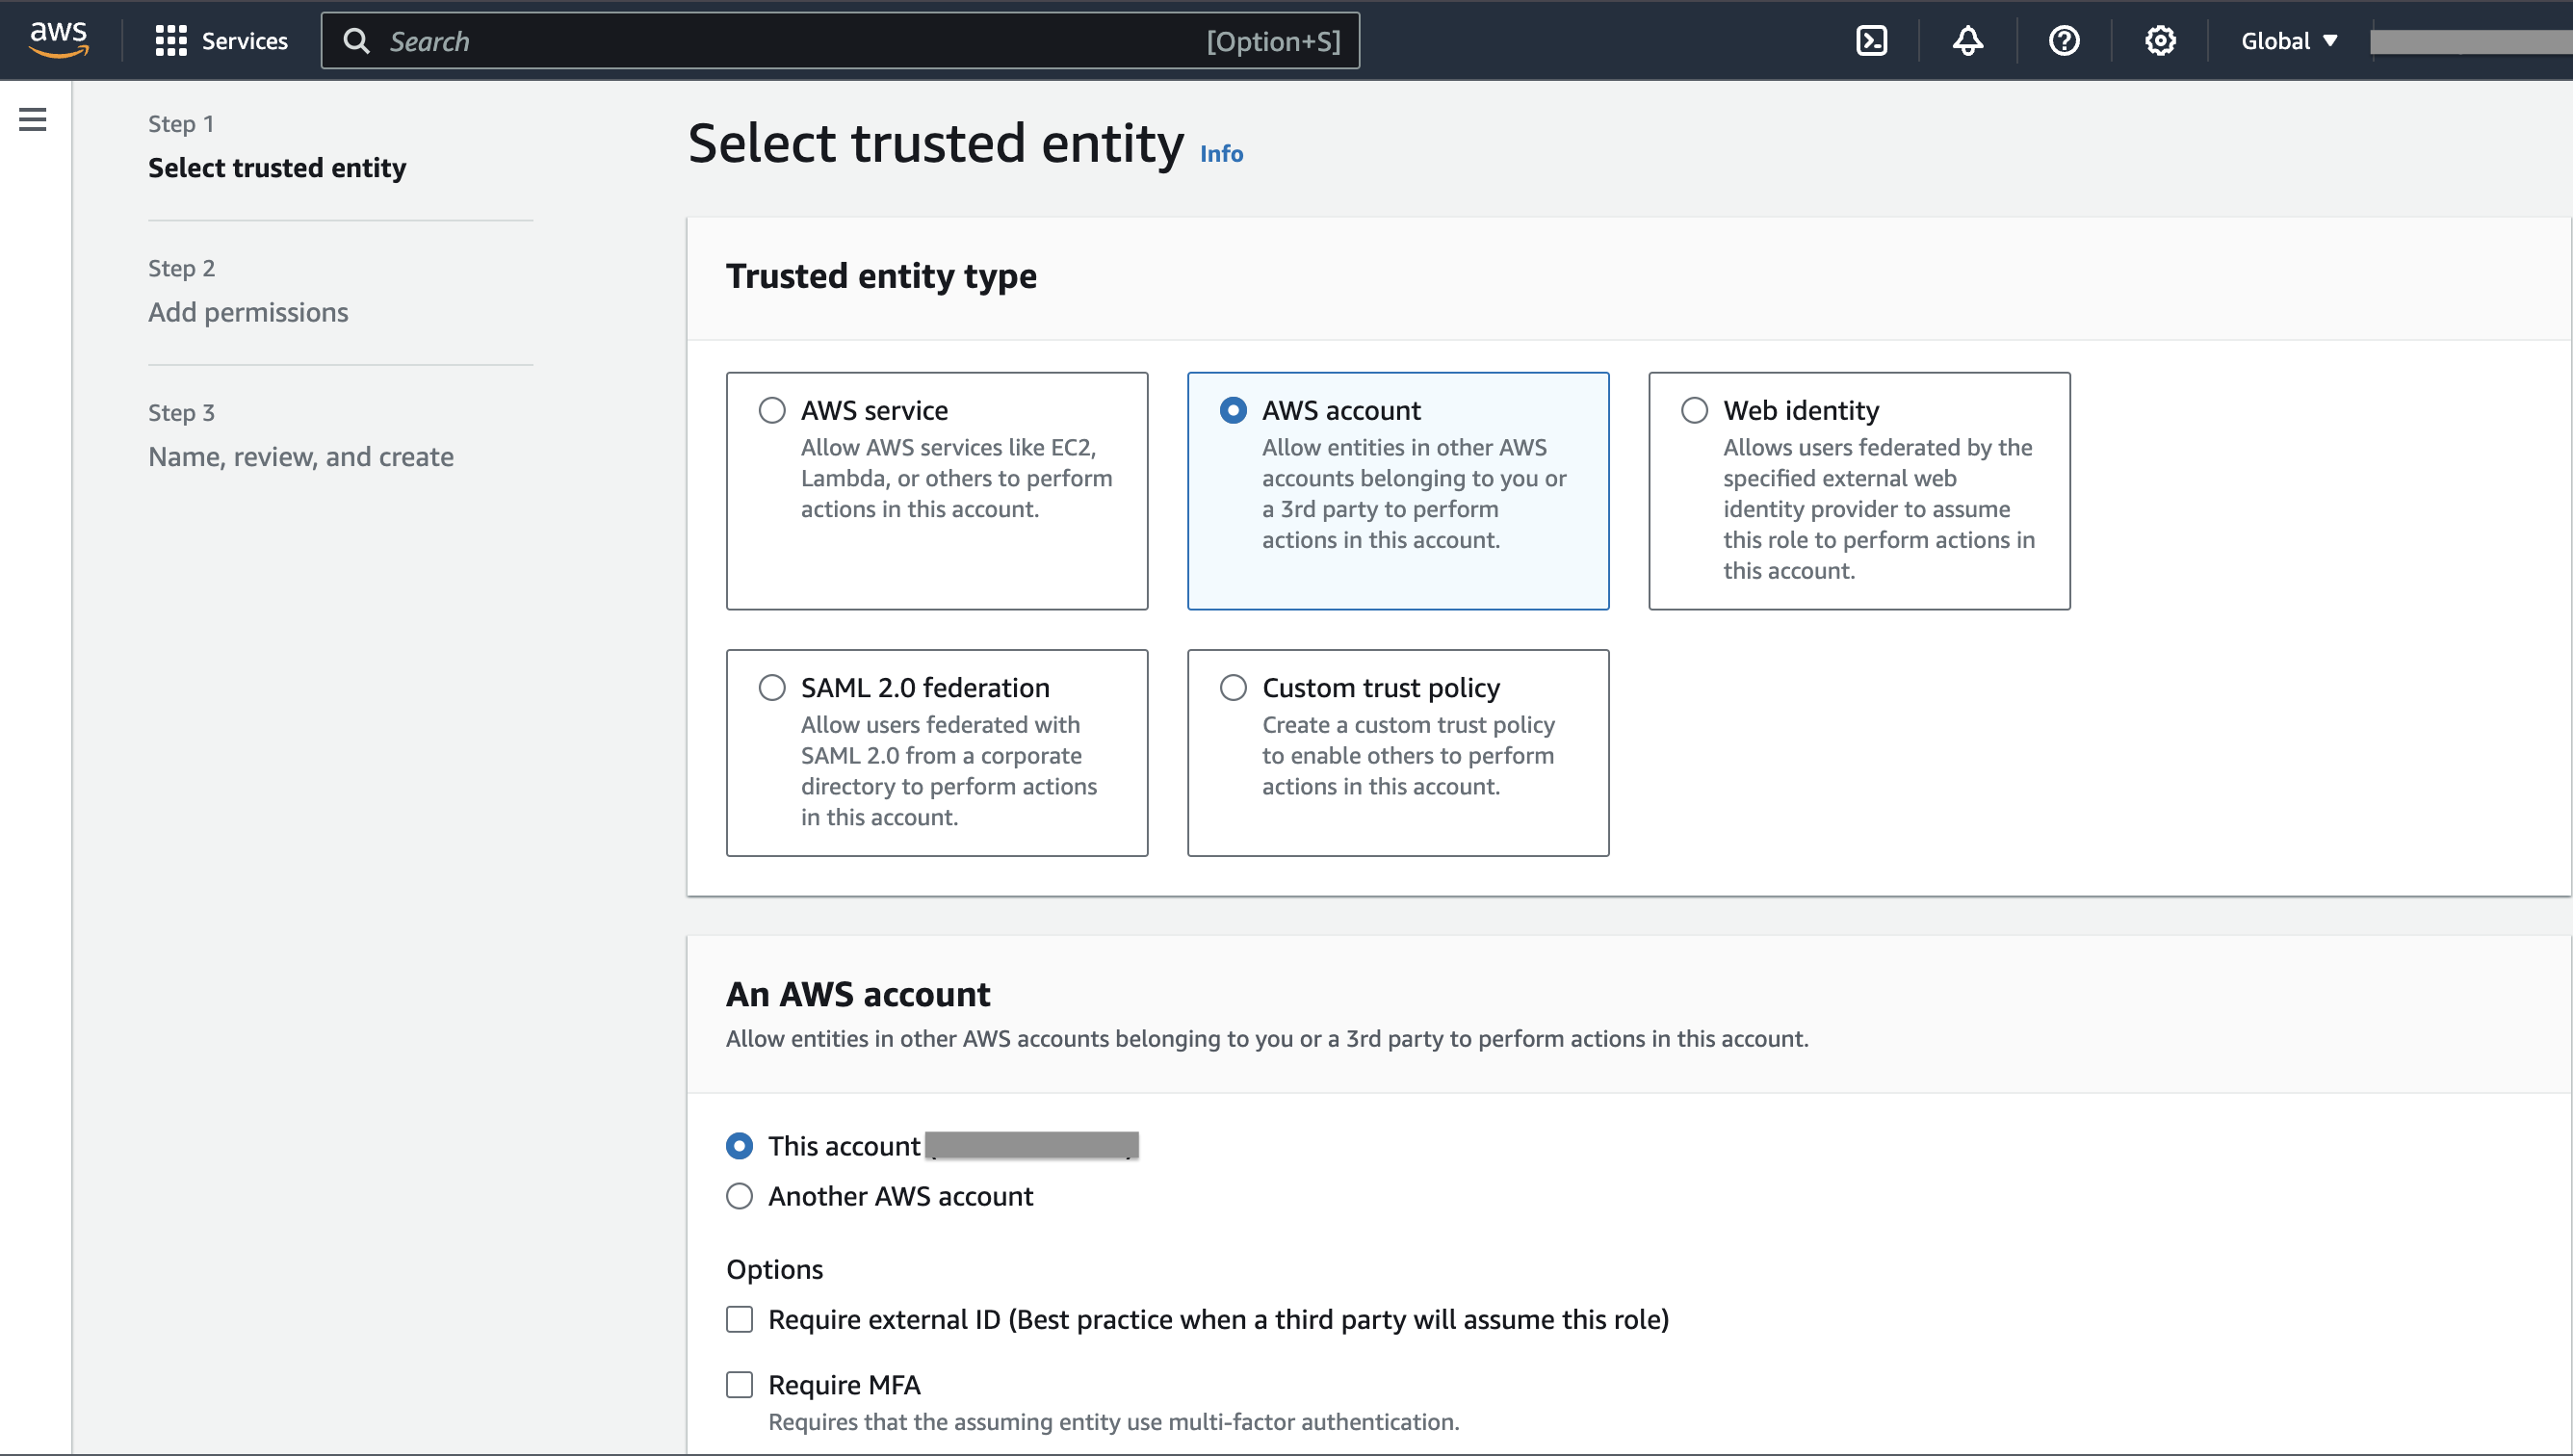
lake-doc-role的 role,并附加我们刚刚创建的 policy。- 在创建 role 的第一步中,选择 AWS account 作为 Trusted entity type,并选择 This account (xxxxx) 作为 An AWS account。
- 创建 role 后,复制并将该 role 的 ARN 保存在安全位置,例如
arn:aws:iam::123456789012:role/lake-doc-role。 - 稍后在获取 Snowflake 账户的 IAM user ARN 后,我们会更新该 role 的 Trust Relationships。
在 Snowflake 中打开一个 SQL worksheet,并使用该 role ARN 创建一个名为
my_s3_integration的 storage integration。CREATE OR REPLACE STORAGE INTEGRATION my_s3_integration TYPE = EXTERNAL_STAGE STORAGE_PROVIDER = 'S3' STORAGE_AWS_ROLE_ARN = 'arn:aws:iam::123456789012:role/lake-doc-role' STORAGE_ALLOWED_LOCATIONS = ('s3://lake-doc/snowflake/') ENABLED = TRUE;显示 storage integration 的详细信息,并从结果中获取
STORAGE_AWS_IAM_USER_ARN属性的值,例如arn:aws:iam::123456789012:user/example。下一步中,我们将使用该值更新 rolelake-doc-role的 Trust Relationships。DESCRIBE INTEGRATION my_s3_integration;返回 AWS Management Console,打开 role
lake-doc-role,然后进入 Trust relationships > Edit trust policy。将以下代码复制到编辑器中:{ "Version": "2012-10-17", "Statement": [ { "Effect": "Allow", "Principal": { "AWS": "arn:aws:iam::123456789012:user/example" }, "Action": "sts:AssumeRole" } ] }ARN
arn:aws:iam::123456789012:user/example是我们在上一步中获取到的 Snowflake 账户对应的 IAM user ARN。
第 2 步:准备数据并导出到 Amazon S3
在 Snowflake 中使用 Snowflake storage integration
my_s3_integration创建一个 external stage:CREATE OR REPLACE STAGE my_external_stage URL = 's3://lake-doc/snowflake/' STORAGE_INTEGRATION = my_s3_integration FILE_FORMAT = (TYPE = 'PARQUET');URL = 's3://lake-doc/snowflake/'指定了用于暂存数据的 S3 存储桶和文件夹。路径s3://lake-doc/snowflake/对应于 S3 存储桶lake-doc及其下的snowflake文件夹。准备一些要导出的数据。
CREATE DATABASE doc;
USE DATABASE doc;

CREATE TABLE my_table (
    id INT,
    name STRING,
    age INT
);

INSERT INTO my_table (id, name, age) VALUES
(1, 'Alice', 30),
(2, 'Bob', 25),
(3, 'Charlie', 35);
使用
COPY INTO将表数据导出到 external stage:COPY INTO @my_external_stage/my_table_data_ FROM my_table FILE_FORMAT = (TYPE = 'PARQUET') HEADER=true;如果你打开
lake-doc存储桶,就会在snowflake文件夹中看到一个 Parquet 文件。
第 3 步:将数据加载到 TiDB Cloud Lake 中
在 TiDB Cloud Lake 中创建目标表:
CREATE DATABASE doc;
USE DATABASE doc;

CREATE TABLE my_target_table (
    id INT,
    name STRING,
    age INT
);
使用 COPY INTO 加载存储桶中已导出的数据:
COPY INTO my_target_table
FROM 's3://lake-doc/snowflake'
CONNECTION = (
    ACCESS_KEY_ID = '<your-access-key-id>',
    SECRET_ACCESS_KEY = '<your-secret-access-key>'
)
PATTERN = '.*[.]parquet'
FILE_FORMAT = (
    TYPE = 'PARQUET'
);
验证已加载的数据:
SELECT * FROM my_target_table;

┌──────────────────────────────────────────────────────┐
│        id       │       name       │       age       │
├─────────────────┼──────────────────┼─────────────────┤
│               1 │ Alice            │              30 │
│               2 │ Bob              │              25 │
│               3 │ Charlie          │              35 │
└──────────────────────────────────────────────────────┘