COPY INTO <table>
COPY INTO 允许你从位于以下位置之一的文件中加载数据:
- 用户 / Internal / External stage:参见 Stage 是什么?,了解 TiDB Cloud Lake 中的 stage。
- 在存储服务中创建的存储桶或容器。
- 可通过其 URL(以
https://开头)访问文件的远程服务器。 - IPFS 和 Hugging Face 仓库。
另请参阅:COPY INTO <location>
语法
/* Standard data load */
COPY INTO [<database_name>.]<table_name> [ ( <col_name> [ , <col_name> ... ] ) ]
     FROM { userStage | internalStage | externalStage | externalLocation }
[ FILES = ( '<file_name>' [ , '<file_name>' ] [ , ... ] ) ]
[ PATTERN = '<regex_pattern>' ]
[ FILE_FORMAT = (
         FORMAT_NAME = '<your-custom-format>'
         | TYPE = { CSV | TSV | NDJSON | PARQUET | ORC | AVRO } [ formatTypeOptions ]
       ) ]
[ copyOptions ]

/* Data load with transformation */
COPY INTO [<database_name>.]<table_name> [ ( <col_name> [ , <col_name> ... ] ) ]
     FROM (
        SELECT {
            [<alias>.]<column> [, [<alias>.]<column> ...] -- Query columns by name
            | [<alias>.]$<col_position> [, [<alias>.]$<col_position> ...] -- Query columns by position
            | [<alias>.]$1[:<column>] [, [<alias>.]$1[:<column>]  ...] -- Query rows as Variants
            } ]
        FROM {@<stage_name>[/<path>] | '<uri>'}
    )
[ FILES = ( '<file_name>' [ , '<file_name>' ] [ , ... ] ) ]
[ PATTERN = '<regex_pattern>' ]
[ FILE_FORMAT = (
         FORMAT_NAME = '<your-custom-format>'
         | TYPE = { CSV | TSV | NDJSON | PARQUET | ORC | AVRO } [ formatTypeOptions ]
       ) ]
[ copyOptions ]
其中:
userStage ::= @~[/<path>]

internalStage ::= @<internal_stage_name>[/<path>]

externalStage ::= @<external_stage_name>[/<path>]

externalLocation ::=
  /* Amazon S3-like Storage */
  's3://<bucket>[/<path>]'
  CONNECTION = (
    [ CONNECTION_NAME = '<connection-name>' ]
    | [ ENDPOINT_URL = '<endpoint-url>' ]
    [ ACCESS_KEY_ID = '<your-access-key-ID>' ]
    [ SECRET_ACCESS_KEY = '<your-secret-access-key>' ]
    [ ENABLE_VIRTUAL_HOST_STYLE = TRUE | FALSE ]
    [ MASTER_KEY = '<your-master-key>' ]
    [ REGION = '<region>' ]
    [ SECURITY_TOKEN = '<security-token>' ]
    [ ROLE_ARN = '<role-arn>' ]
    [ EXTERNAL_ID = '<external-id>' ]
  )

  /* Azure Blob Storage */
  | 'azblob://<container>[/<path>]'
    CONNECTION = (
      [ CONNECTION_NAME = '<connection-name>' ]
      | ENDPOINT_URL = '<endpoint-url>'
      ACCOUNT_NAME = '<account-name>'
      ACCOUNT_KEY = '<account-key>'
    )

  /* Google Cloud Storage */
  | 'gcs://<bucket>[/<path>]'
    CONNECTION = (
      [ CONNECTION_NAME = '<connection-name>' ]
      | CREDENTIAL = '<your-base64-encoded-credential>'
    )

  /* Alibaba Cloud OSS */
  | 'oss://<bucket>[/<path>]'
    CONNECTION = (
      [ CONNECTION_NAME = '<connection-name>' ]
      | ACCESS_KEY_ID = '<your-ak>'
      ACCESS_KEY_SECRET = '<your-sk>'
      ENDPOINT_URL = '<endpoint-url>'
      [ PRESIGN_ENDPOINT_URL = '<presign-endpoint-url>' ]
    )

  /* Tencent Cloud Object Storage */
  | 'cos://<bucket>[/<path>]'
    CONNECTION = (
      [ CONNECTION_NAME = '<connection-name>' ]
      | SECRET_ID = '<your-secret-id>'
      SECRET_KEY = '<your-secret-key>'
      ENDPOINT_URL = '<endpoint-url>'
    )

  /* Remote Files */
  | 'https://<url>'

  /* IPFS */
  | 'ipfs://<your-ipfs-hash>'
    CONNECTION = (ENDPOINT_URL = 'https://<your-ipfs-gateway>')

  /* Hugging Face */
  | 'hf://<repo-id>[/<path>]'
    CONNECTION = (
      [ REPO_TYPE = 'dataset' | 'model' ]
      [ REVISION = '<revision>' ]
      [ TOKEN = '<your-api-token>' ]
    )

formatTypeOptions ::=
  /* Common options for all formats */
  [ COMPRESSION = AUTO | GZIP | BZ2 | BROTLI | ZSTD | DEFLATE | RAW_DEFLATE | XZ | NONE ]

  /* CSV specific options */
  [ RECORD_DELIMITER = '<character>' ]
  [ FIELD_DELIMITER = '<character>' ]
  [ SKIP_HEADER = <integer> ]
  [ QUOTE = '<character>' ]
  [ ESCAPE = '<character>' ]
  [ NAN_DISPLAY = '<string>' ]
  [ NULL_DISPLAY = '<string>' ]
  [ ERROR_ON_COLUMN_COUNT_MISMATCH = TRUE | FALSE ]
  [ EMPTY_FIELD_AS = null | string | field_default ]
  [ BINARY_FORMAT = HEX | BASE64 ]
  [ TRIM_SPACE = TRUE | FALSE ]
  [ ENCODING = '<encoding_label>' ]
  [ ENCODING_ERROR_MODE = STRICT | REPLACE ]

  /* TSV specific options */
  [ RECORD_DELIMITER = '<character>' ]
  [ FIELD_DELIMITER = '<character>' ]
  [ TRIM_SPACE = TRUE | FALSE ]
  [ ENCODING = '<encoding_label>' ]
  [ ENCODING_ERROR_MODE = STRICT | REPLACE ]

  /* NDJSON specific options */
  [ NULL_FIELD_AS = NULL | FIELD_DEFAULT ]
  [ MISSING_FIELD_AS = ERROR | NULL | FIELD_DEFAULT ]
  [ NULL_IF = ('value1', 'value2', ...) ]

  /* PARQUET specific options */
  [ MISSING_FIELD_AS = ERROR | FIELD_DEFAULT ]
  [ NULL_IF = ('value1', 'value2', ...) ]
  [ USE_LOGIC_TYPE = TRUE | FALSE ]

  /* ORC specific options */
  [ MISSING_FIELD_AS = ERROR | FIELD_DEFAULT ]

  /* AVRO specific options */
  [ MISSING_FIELD_AS = ERROR | FIELD_DEFAULT ]
  [ NULL_IF = ('value1', 'value2', ...) ]
  [ USE_LOGIC_TYPE = TRUE | FALSE ]

copyOptions ::=
  [ PURGE = <bool> ]
  [ FORCE = <bool> ]
  [ DISABLE_VARIANT_CHECK = <bool> ]
  [ ON_ERROR = { continue | abort | abort_N } ]
  [ MAX_FILES = <num> ]
  [ RETURN_FAILED_ONLY = <bool> ]
  [ COLUMN_MATCH_MODE = { case-sensitive | case-insensitive } ]
  [ SCHEMA_EVOLUTION = (
      [ SAMPLE_FILES = AUTO | <positive_integer> ]
      [ , SAMPLE_RECORDS_PER_FILE = AUTO | <positive_integer> ]
      [ , SAMPLE_TOTAL_RECORDS = AUTO | <positive_integer> ]
    ) ]
关键参数
FILES:指定要加载的一个或多个文件名(用逗号分隔)。
PATTERN:基于 PCRE2 的正则表达式模式字符串,用于指定要匹配的文件名。从 stage 加载时,该模式匹配文件路径中
@<stage_name>[/<path>]之后的部分。参见 使用 PATTERN 过滤 stage 中的文件 和 示例 4:使用 Pattern 过滤文件。
格式类型选项
FILE_FORMAT 参数支持不同的文件类型,每种类型都有特定的格式选项。以下列出了每种受支持文件格式可用的选项。有关所有选项的完整详情,请参见输入与输出文件格式。
这些选项适用于所有文件格式:
复制选项
SCHEMA_EVOLUTION 选项
SCHEMA_EVOLUTION 用于控制 TiDB Cloud Lake 在加载前如何对 stage 中的 NDJSON 文件进行采样。当目标表启用了 ENABLE_SCHEMA_EVOLUTION = true 时,请将其与 FILE_FORMAT = (TYPE = NDJSON ...) 一起使用。
当针对 stage 或 location 加载执行 schema evolution 推导时,执行 COPY INTO <table> 的角色必须同时拥有目标表的 INSERT 和 ALTER 权限。基于查询的 COPY(例如 COPY INTO <table> FROM (SELECT ... FROM @stage))仍沿用现有的权限要求。
如果省略 SCHEMA_EVOLUTION,TiDB Cloud Lake 会对这三个采样选项都使用 AUTO。当前 AUTO 的行为是最多采样 64 个文件、每个文件 1,000 条记录、总计 10,000 条记录。这些内部默认值可能会在未来版本中发生变化。如果你的加载过程对采样策略较为敏感,请显式设置 SAMPLE_FILES、SAMPLE_RECORDS_PER_FILE 和 SAMPLE_TOTAL_RECORDS。如果采样未覆盖某个在后续加载过程中出现的列,COPY 将失败,并报告这些额外的列名,以便你增大采样值。
提示:
导入大量数据(例如日志)时,建议同时将
PURGE和FORCE设置为true。这样可以在无需与 Meta server 交互(更新 copied-files 集合)的情况下高效导入数据。不过,需要注意的是,这可能会导致重复导入数据。
输出
COPY INTO 会通过以下列汇总数据加载结果:
如果将 RETURN_FAILED_ONLY 设置为 true,输出将只包含加载失败的文件。
示例
对于外部存储源,建议使用通过 CONNECTION_NAME 参数引用的预先创建连接,而不是在 COPY 语句中直接指定凭证。这种方式在安全性、可维护性和可复用性方面更好。有关如何创建连接的详细信息,请参见 CREATE CONNECTION。
示例 1:从 Stages 加载
以下示例展示了如何从不同类型的 stage 将数据加载到 TiDB Cloud Lake:
COPY INTO mytable
    FROM @~
    PATTERN = '.*[.]parquet'
    FILE_FORMAT = (TYPE = PARQUET);
COPY INTO mytable
    FROM @my_internal_stage
    PATTERN = '.*[.]parquet'
    FILE_FORMAT = (TYPE = PARQUET);
COPY INTO mytable
    FROM @my_external_stage
    PATTERN = '.*[.]parquet'
    FILE_FORMAT = (TYPE = PARQUET);
示例 2:从外部位置加载
以下示例展示了如何从不同类型的外部数据源将数据加载到 TiDB Cloud Lake 中:
此示例使用预先创建的连接从 Amazon S3 加载数据:
-- First create a connection (you only need to do this once)
CREATE CONNECTION my_s3_conn
    STORAGE_TYPE = 's3'
    ACCESS_KEY_ID = '<your-access-key-ID>'
    SECRET_ACCESS_KEY = '<your-secret-access-key>';

-- Use the connection to load data
COPY INTO mytable
    FROM 's3://mybucket/data.csv'
    CONNECTION = (CONNECTION_NAME = 'my_s3_conn')
    FILE_FORMAT = (
        TYPE = CSV,
        FIELD_DELIMITER = ',',
        RECORD_DELIMITER = '\n',
        SKIP_HEADER = 1
    );
使用 IAM Role(推荐用于生产环境)
-- Create connection using IAM role (more secure, recommended for production)
CREATE CONNECTION my_iam_conn
    STORAGE_TYPE = 's3'
    ROLE_ARN = 'arn:aws:iam::123456789012:role/my_iam_role';

-- Load CSV files using the IAM role connection
COPY INTO mytable
    FROM 's3://mybucket/'
    CONNECTION = (CONNECTION_NAME = 'my_iam_conn')
    PATTERN = '.*[.]csv'
    FILE_FORMAT = (
        TYPE = CSV,
        FIELD_DELIMITER = ',',
        RECORD_DELIMITER = '\n',
        SKIP_HEADER = 1
    );
此示例连接到 Azure Blob Storage,并将 data.csv 中的数据加载到 TiDB Cloud Lake 中:
-- Create connection for Azure Blob Storage
CREATE CONNECTION my_azure_conn
    STORAGE_TYPE = 'azblob'
    ENDPOINT_URL = 'https://<account_name>.blob.core.windows.net'
    ACCOUNT_NAME = '<account_name>'
    ACCOUNT_KEY = '<account_key>';

-- Use the connection to load data
COPY INTO mytable
    FROM 'azblob://mybucket/data.csv'
    CONNECTION = (CONNECTION_NAME = 'my_azure_conn')
    FILE_FORMAT = (type = CSV);
此示例连接到 Google Cloud Storage 并加载数据:
-- Create connection for Google Cloud Storage
CREATE CONNECTION my_gcs_conn
    STORAGE_TYPE = 'gcs'
    CREDENTIAL = '<your-base64-encoded-credential>';

-- Use the connection to load data
COPY INTO mytable
    FROM 'gcs://mybucket/data.csv'
    CONNECTION = (CONNECTION_NAME = 'my_gcs_conn')
    FILE_FORMAT = (
        TYPE = CSV,
        FIELD_DELIMITER = ',',
        RECORD_DELIMITER = '\n',
        SKIP_HEADER = 1
    );
此示例从三个远程 CSV 文件加载数据,并在发生错误时跳过某个文件。
COPY INTO mytable
    FROM 'https://lakesql-bin.tidbcloud.com/datasets/ontime_200{6,7,8}_200.csv'
    FILE_FORMAT = (type = CSV)
    ON_ERROR = continue;
此示例从 IPFS 上的一个 CSV 文件加载数据:
COPY INTO mytable
    FROM 'ipfs://<your-ipfs-hash>'
    CONNECTION = (
        ENDPOINT_URL = 'https://<your-ipfs-gateway>'
    )
    FILE_FORMAT = (
        TYPE = CSV,
        FIELD_DELIMITER = ',',
        RECORD_DELIMITER = '\n',
        SKIP_HEADER = 1
    );
示例 3:加载压缩数据
此示例将 Amazon S3 上一个经过 GZIP 压缩的 CSV 文件加载到 TiDB Cloud Lake 中:
-- Create connection for compressed data loading
CREATE CONNECTION compressed_s3_conn
    STORAGE_TYPE = 's3'
    ACCESS_KEY_ID = '<your-access-key-ID>'
    SECRET_ACCESS_KEY = '<your-secret-access-key>';

-- Load GZIP-compressed CSV file using the connection
COPY INTO mytable
    FROM 's3://mybucket/data.csv.gz'
    CONNECTION = (CONNECTION_NAME = 'compressed_s3_conn')
    FILE_FORMAT = (
        TYPE = CSV,
        FIELD_DELIMITER = ',',
        RECORD_DELIMITER = '\n',
        SKIP_HEADER = 1,
        COMPRESSION = AUTO
    );
示例 4:使用 Pattern 过滤文件
本示例演示如何使用 PATTERN 参数通过模式匹配从 Amazon S3 加载 CSV 文件。它会筛选文件名中包含 sales 且扩展名为 .csv 的文件:
-- Create connection for pattern-based file loading
CREATE CONNECTION pattern_s3_conn
    STORAGE_TYPE = 's3'
    ACCESS_KEY_ID = '<your-access-key-ID>'
    SECRET_ACCESS_KEY = '<your-secret-access-key>';

-- Load CSV files with 'sales' in their names using pattern matching
COPY INTO mytable
    FROM 's3://mybucket/'
    CONNECTION = (CONNECTION_NAME = 'pattern_s3_conn')
    PATTERN = '.*sales.*[.]csv'
    FILE_FORMAT = (
        TYPE = CSV,
        FIELD_DELIMITER = ',',
        RECORD_DELIMITER = '\n',
        SKIP_HEADER = 1
    );
其中,.* 表示任意字符出现零次或多次。方括号用于对文件扩展名前的句点字符 . 进行转义。
要使用连接从所有 CSV 文件中加载数据:
COPY INTO mytable
    FROM 's3://mybucket/'
    CONNECTION = (CONNECTION_NAME = 'pattern_s3_conn')
    PATTERN = '.*[.]csv'
    FILE_FORMAT = (
        TYPE = CSV,
        FIELD_DELIMITER = ',',
        RECORD_DELIMITER = '\n',
        SKIP_HEADER = 1
    );
当为包含多级文件夹路径的 staged 文件指定模式时,请注意,模式只会匹配 @<stage_name>[/<path>] 之后的路径部分。例如,对于 FROM @sales_stage/raw/,文件 @sales_stage/raw/year=2025/month=01/sales_20250101.parquet 会被匹配为 year=2025/month=01/sales_20250101.parquet。
如果你想匹配某个前缀之后的特定子路径,请在模式中包含该前缀(例如
'year=2025/month=01/'),然后再指定你希望在该子路径中匹配的模式(例如'sales_')。-- File path: raw/year=2025/month=01/sales_20250101.parquet COPY INTO ... FROM @sales_stage/raw/ PATTERN = 'year=2025/month=01/.*sales_.*[.]parquet') ...如果你想匹配文件路径中任意位置包含目标模式的部分,请在模式前后都使用
.*(例如'.*sales_20250101.*'),以匹配路径中任意位置出现的sales_20250101。-- File path: raw/year=2025/month=01/sales_20250101.parquet COPY INTO ... FROM @sales_stage/raw/ PATTERN = '.*sales_20250101.*') ...
示例 5:加载到包含额外列的表
本节演示如何将数据加载到包含额外列的表中,使用的示例文件为 books.csv:
Transaction Processing,Jim Gray,1992
Readings in Database Systems,Michael Stonebraker,2004
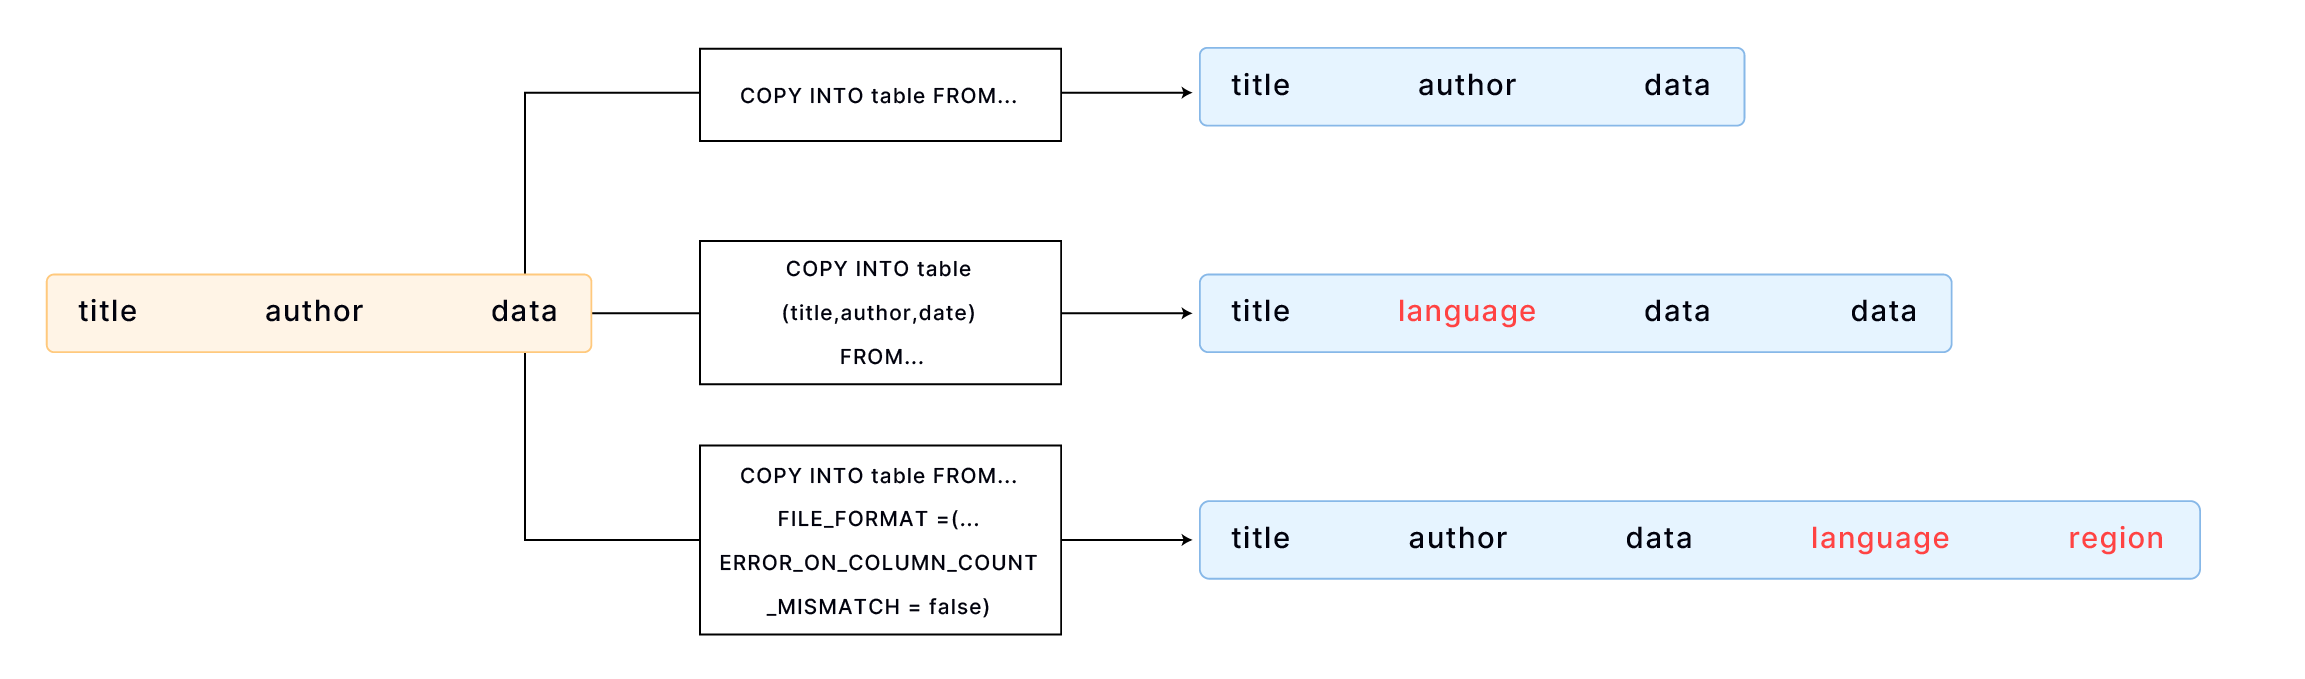
默认情况下,COPY INTO 会按照文件中字段的顺序,将数据加载到表中对应顺序的列。因此,必须确保文件与表之间的数据能够正确对齐。例如:
CREATE TABLE books
(
    title VARCHAR,
    author VARCHAR,
    date VARCHAR
);

COPY INTO books
    FROM 'https://lakesql-bin.tidbcloud.com/datasets/books.csv'
    FILE_FORMAT = (TYPE = CSV);
如果你的表比文件包含更多列,可以指定要将数据加载到哪些列中。例如:
CREATE TABLE books_with_language
(
    title VARCHAR,
    language VARCHAR,
    author VARCHAR,
    date VARCHAR
);

COPY INTO books_with_language (title, author, date)
    FROM 'https://lakesql-bin.tidbcloud.com/datasets/books.csv'
    FILE_FORMAT = (TYPE = CSV);
如果你的表比文件包含更多列,并且这些额外列位于表的末尾,则可以使用 FILE_FORMAT 选项 ERROR_ON_COLUMN_COUNT_MISMATCH 来加载数据。这样你无需逐一指定每一列。请注意,ERROR_ON_COLUMN_COUNT_MISMATCH 当前仅适用于 CSV 文件格式。
CREATE TABLE books_with_extra_columns
(
    title VARCHAR,
    author VARCHAR,
    date VARCHAR,
    language VARCHAR,
    region VARCHAR
);

COPY INTO books_with_extra_columns
    FROM 'https://lakesql-bin.tidbcloud.com/datasets/books.csv'
    FILE_FORMAT = (TYPE = CSV, ERROR_ON_COLUMN_COUNT_MISMATCH = false);
示例 6:使用自定义格式加载 JSON
本示例从一个名为 "data.csv" 的 CSV 文件中加载数据,其内容如下:
1,"U00010","{\"carPriceList\":[{\"carTypeId":10,\"distance":5860},{\"carTypeId":11,\"distance\":5861}]}"
2,"U00011","{\"carPriceList\":[{\"carTypeId":12,\"distance\":5862},{\"carTypeId":13,\"distance\":5863}]}"
每一行包含三列数据,其中第三列是一个包含 JSON 数据的字符串。为了正确加载带有 JSON 字段的 CSV 数据,我们需要设置正确的转义字符。本示例使用反斜杠 \ 作为转义字符,因为 JSON 数据中包含双引号 "。
步骤 1:创建自定义文件格式
-- Define a custom CSV file format with the escape character set to backslash \
CREATE FILE FORMAT my_csv_format
    TYPE = CSV
    ESCAPE = '\\';
步骤 2:创建目标表
CREATE TABLE t
  (
     id       INT,
     seq      VARCHAR,
     p_detail VARCHAR
  );
步骤 3:使用自定义文件格式加载
COPY INTO t FROM @t_stage FILES=('data.csv')
FILE_FORMAT=(FORMAT_NAME='my_csv_format');
示例 7:加载无效 JSON
将数据加载到 Variant 列时,TiDB Cloud Lake 会自动检查数据的有效性;如果存在任何无效数据,则会报错。例如,如果用户 stage 中有一个名为 invalid_json_string.parquet 的 Parquet 文件,其中包含无效的 JSON 数据,如下所示:
SELECT *
FROM @~/invalid_json_string.parquet;

┌────────────────────────────────────┐
│        a        │         b        │
├─────────────────┼──────────────────┤
│               5 │ {"k":"v"}        │
│               6 │ [1,              │
└────────────────────────────────────┘

DESC t2;

┌──────────────────────────────────────────────┐
│  Field │   Type  │  Null  │ Default │  Extra │
├────────┼─────────┼────────┼─────────┼────────┤
│ a      │ VARCHAR │ YES    │ NULL    │        │
│ b      │ VARIANT │ YES    │ NULL    │        │
└──────────────────────────────────────────────┘
尝试将数据加载到表中时会发生错误:
COPY INTO t2 FROM @~/invalid_json_string.parquet FILE_FORMAT = (TYPE = PARQUET) ON_ERROR = CONTINUE;
error: APIError: ResponseError with 1006: EOF while parsing a value, pos 3 while evaluating function `parse_json('[1,')`
如果希望在不检查 JSON 有效性的情况下进行加载,请在 COPY INTO 语句中将 DISABLE_VARIANT_CHECK 选项设置为 true:
COPY INTO t2 FROM @~/invalid_json_string.parquet
FILE_FORMAT = (TYPE = PARQUET)
DISABLE_VARIANT_CHECK = true
ON_ERROR = CONTINUE;

┌───────────────────────────────────────────────────────────────────────────────────────────────┐
│             File            │ Rows_loaded │ Errors_seen │    First_error   │ First_error_line │
├─────────────────────────────┼─────────────┼─────────────┼──────────────────┼──────────────────┤
│ invalid_json_string.parquet │           2 │           0 │ NULL             │             NULL │
└───────────────────────────────────────────────────────────────────────────────────────────────┘

SELECT * FROM t2;
-- Invalid JSON is stored as null in the Variant column.
┌──────────────────────────────────────┐
│         a        │         b         │
├──────────────────┼───────────────────┤
│ 5                │ {"k":"v"}         │
│ 6                │ null              │
└──────────────────────────────────────┘
示例 8:使用 Schema Evolution 加载
当加载 Parquet 或 NDJSON 文件时,如果其 schema 中包含目标表中不存在的列,你可以使用 Schema Evolution 自动添加缺失的列。对于会运行 schema evolution 推导的 stage 或 location 加载,请确保执行加载的角色对目标表具有 INSERT 和 ALTER 权限。首先,在表上启用 schema evolution:
CREATE OR REPLACE TABLE invoices(order_id INT);

-- Enable schema evolution
ALTER TABLE invoices SET OPTIONS(ENABLE_SCHEMA_EVOLUTION = true);
Parquet
然后加载具有不同 schema 的 Parquet 文件。TiDB Cloud Lake 会自动添加新列,并使用 NULL 填充缺失值:
-- Assume @my_stage contains Parquet files with extra columns (e.g., amount, currency)
COPY INTO invoices
    FROM @my_stage/
    FILE_FORMAT = (TYPE = PARQUET MISSING_FIELD_AS = FIELD_DEFAULT);
NDJSON
对于 NDJSON,COPY INTO 会使用默认采样值来推导缺失列。只有在你想覆盖 TiDB Cloud Lake 对 stage 中文件的采样方式时,才需要添加 SCHEMA_EVOLUTION:
CREATE OR REPLACE TABLE events(id INT);
ALTER TABLE events SET OPTIONS(ENABLE_SCHEMA_EVOLUTION = true);

-- Assume @events_stage contains NDJSON records such as:
-- {"id":1,"city":"SF","score":9}
COPY INTO events
    FROM @events_stage/
    FILE_FORMAT = (TYPE = NDJSON MISSING_FIELD_AS = FIELD_DEFAULT)
    SCHEMA_EVOLUTION = (
        SAMPLE_FILES = AUTO,
        SAMPLE_RECORDS_PER_FILE = AUTO,
        SAMPLE_TOTAL_RECORDS = AUTO
    );
TiDB Cloud Lake 会对 stage 中的 NDJSON 文件进行采样,将推导出的 city 和 score 等字段追加为可为空的列,然后再加载数据。
更多详情,请参见 Schema Evolution。