Cluster Key
Cluster key 提供自动数据组织能力,可显著提升大表上的查询性能。TiDB Cloud Lake 在后台无缝且持续地管理所有聚簇操作——你只需定义 cluster key,其余工作由 TiDB Cloud Lake 处理。
它解决了什么问题?
如果大表没有经过合理组织,会带来显著的性能和维护挑战:
示例:一个包含数百万商品的电商表。如果没有聚簇,执行 WHERE category IN ('Electronics', 'Computers') 查询时,必须扫描所有商品类别。通过按 category 自动聚簇后,TiDB Cloud Lake 会持续将 Electronics 和 Computers 商品归组在一起,只需扫描 2 个数据块,而不是 1000+ 个数据块。
自动聚簇的优势
易于维护:TiDB Cloud Lake 无需你再执行以下操作:
- 监控已聚簇表的状态
- 手动触发重新聚簇操作
- 为聚簇指定计算资源
- 安排维护时间窗口
工作方式:定义 cluster key 后,TiDB Cloud Lake 会自动:
- 监控 DML 操作带来的表变更
- 评估表何时会从重新聚簇中受益
- 在后台执行聚簇优化
- 持续维护最佳的数据组织状态
你需要做的只是为每张表定义一个聚簇键(如果适用),之后所有维护工作都由 TiDB Cloud Lake 自动管理。
工作原理
Cluster key 会根据指定列将数据组织到存储块(Parquet 文件)中:
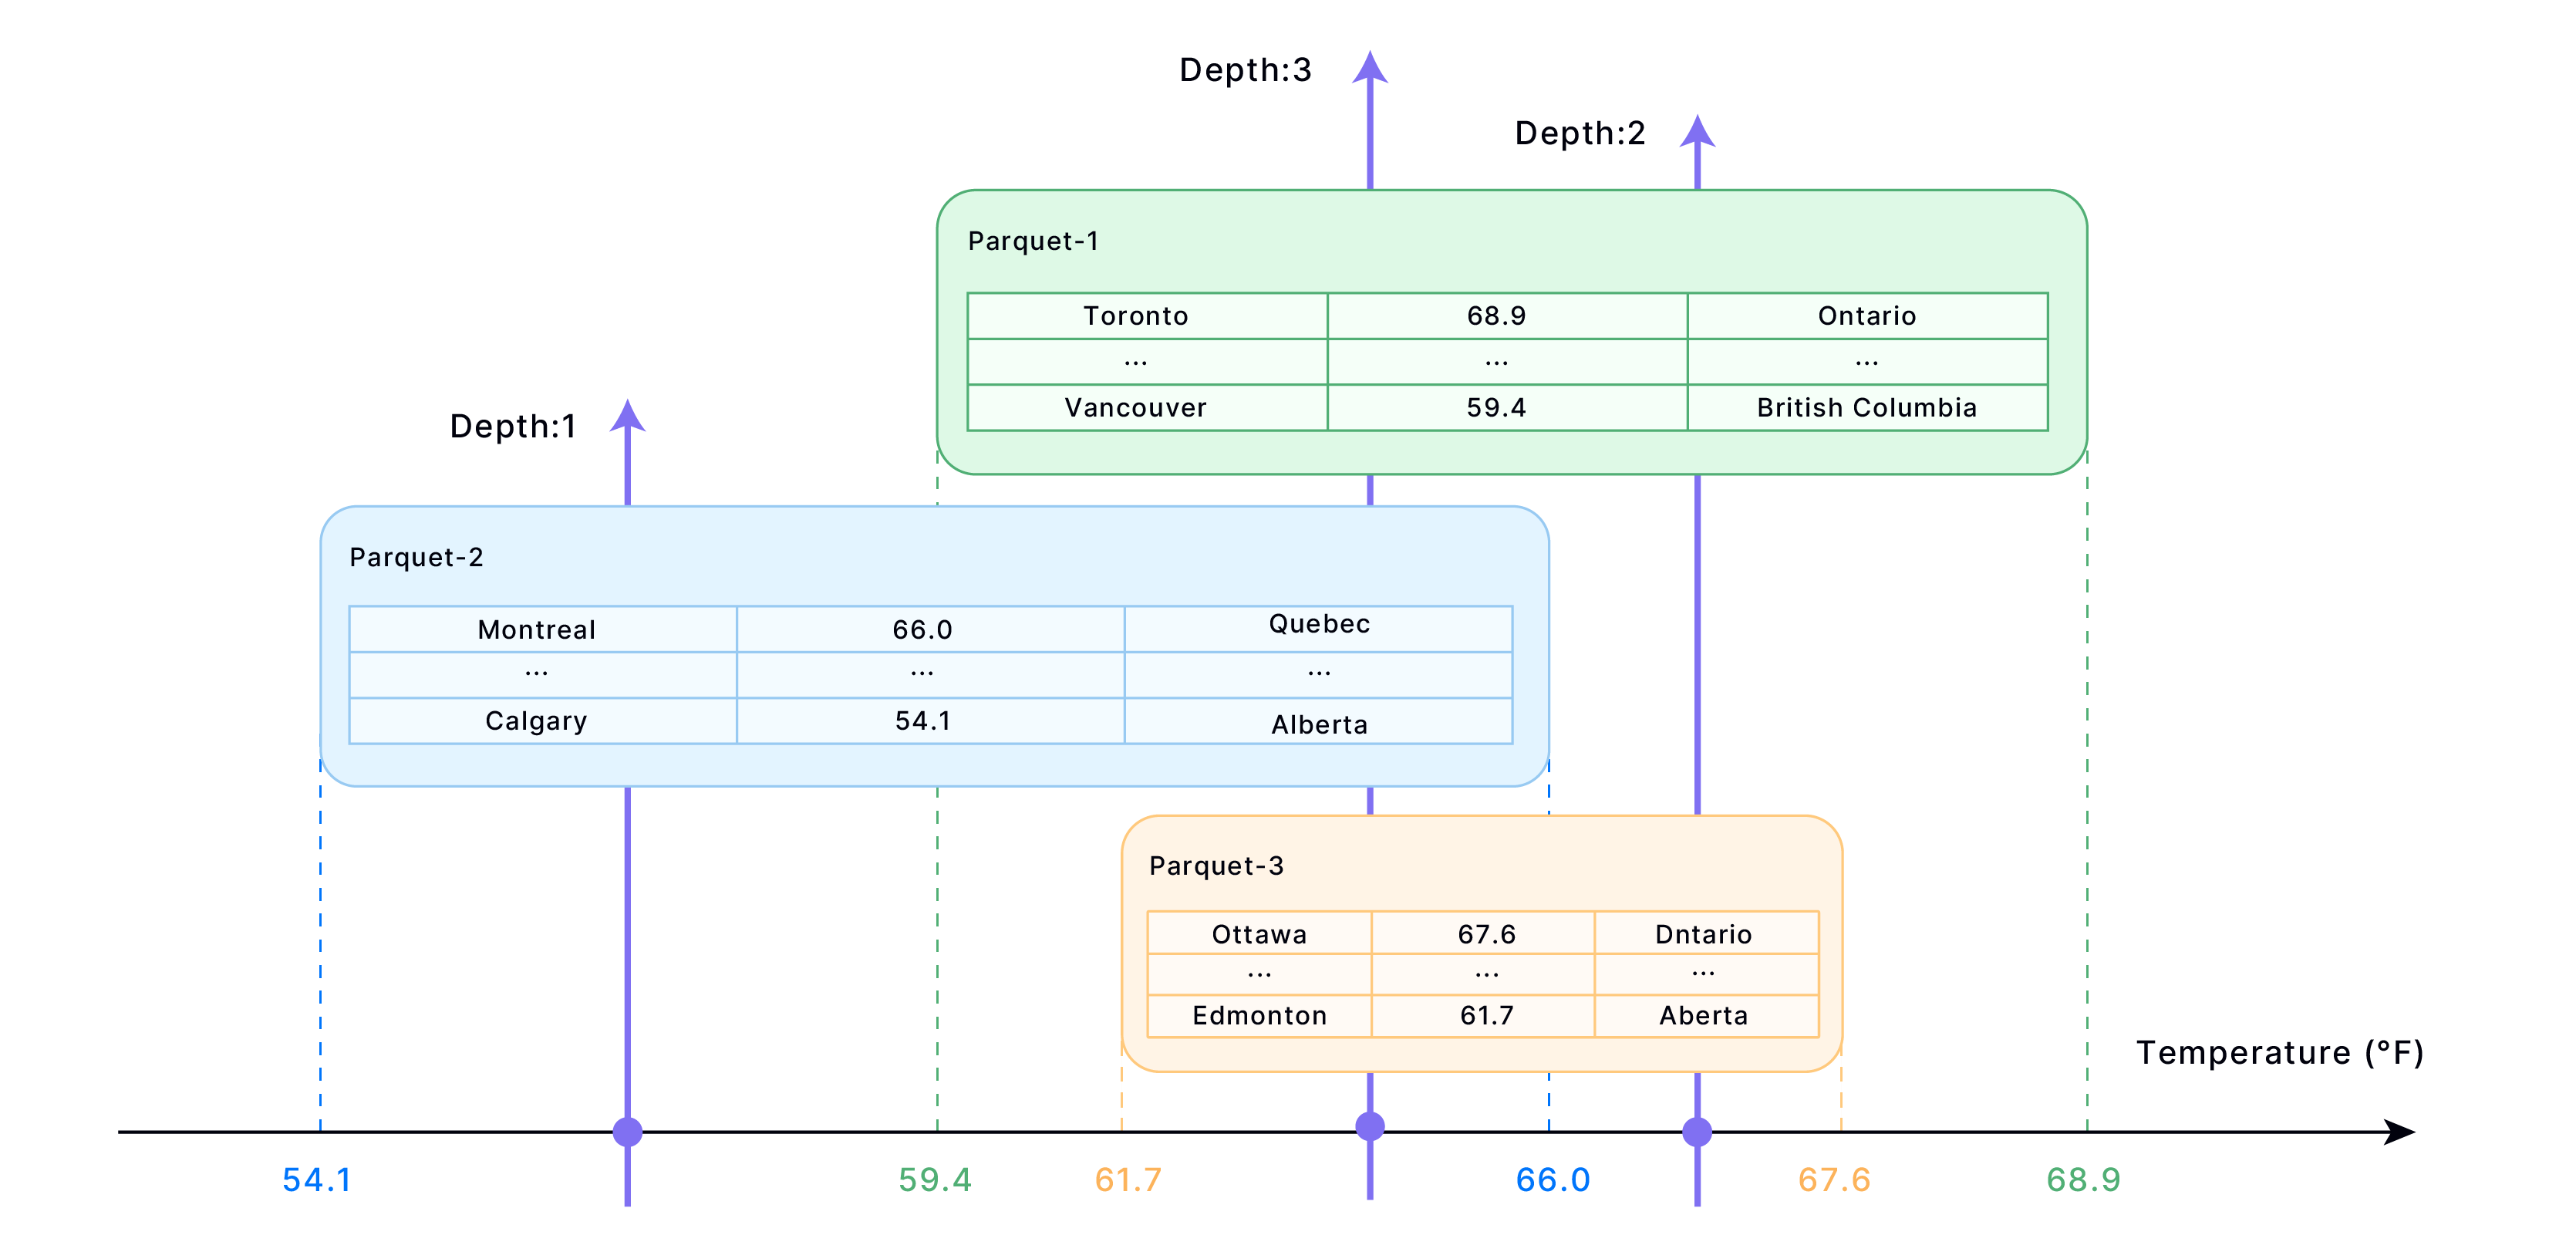
- 数据组织 → 将相似值归组到相邻的数据块中
- 创建元信息 → 存储数据块到值的映射,以便快速查找
- 查询优化 → 查询时只读取相关的数据块
- 性能提升 → 扫描更少的行,更快返回结果
快速设置
-- Create table with cluster key
CREATE TABLE sales (
    order_id INT,
    order_date TIMESTAMP,
    region VARCHAR,
    amount DECIMAL
) CLUSTER BY (region);

-- Or add cluster key to existing table
ALTER TABLE sales CLUSTER BY (region, order_date);
选择合适的 Cluster Key
根据最常见的查询过滤条件选择列:
好的与不好的 Cluster Key
监控性能
-- Check clustering effectiveness
SELECT * FROM clustering_information('database_name', 'table_name');

-- Key metrics to watch:
-- average_depth: Lower is better (< 2 ideal)
-- average_overlaps: Lower is better
-- block_depth_histogram: More blocks at depth 1-2
何时重新聚簇
随着数据变化,表会逐渐变得无序:
-- Check if re-clustering is needed
SELECT IF(average_depth > 2 * LEAST(GREATEST(total_block_count * 0.001, 1), 16),
          'Re-cluster needed',
          'Clustering is good')
FROM clustering_information('your_database', 'your_table');

-- Re-cluster the table
ALTER TABLE your_table RECLUSTER;
性能调优
自定义块大小
调整块大小以获得更好的性能:
-- Smaller blocks = fewer rows per query
ALTER TABLE sales SET OPTIONS(
    ROW_PER_BLOCK = 100000,
    BLOCK_SIZE_THRESHOLD = 52428800
);
自动重新聚簇
COPY INTO和REPLACE INTO会自动触发重新聚簇- 定期监控聚簇指标
- 当
average_depth变得过高时重新聚簇
最佳实践
重要说明
适合使用 Cluster Key 的场景:
- 大表(数百万行以上)
- 存在慢查询性能问题
- 频繁执行基于过滤条件的查询
- 分析型工作负载
不适合使用的场景:
- 小表
- 随机访问模式
- 数据频繁变化
对于具有可预测过滤模式、且经常被查询的大表,cluster key 的效果最明显。建议从最常见的 WHERE 子句列开始。