Tasks によるデータロードの自動化
Tasks は SQL をラップし、TiDB Cloud Lake がスケジュールに従って、または条件が満たされたときに実行できるようにします。CREATE TASK で定義する際は、以下の設定項目を考慮してください。
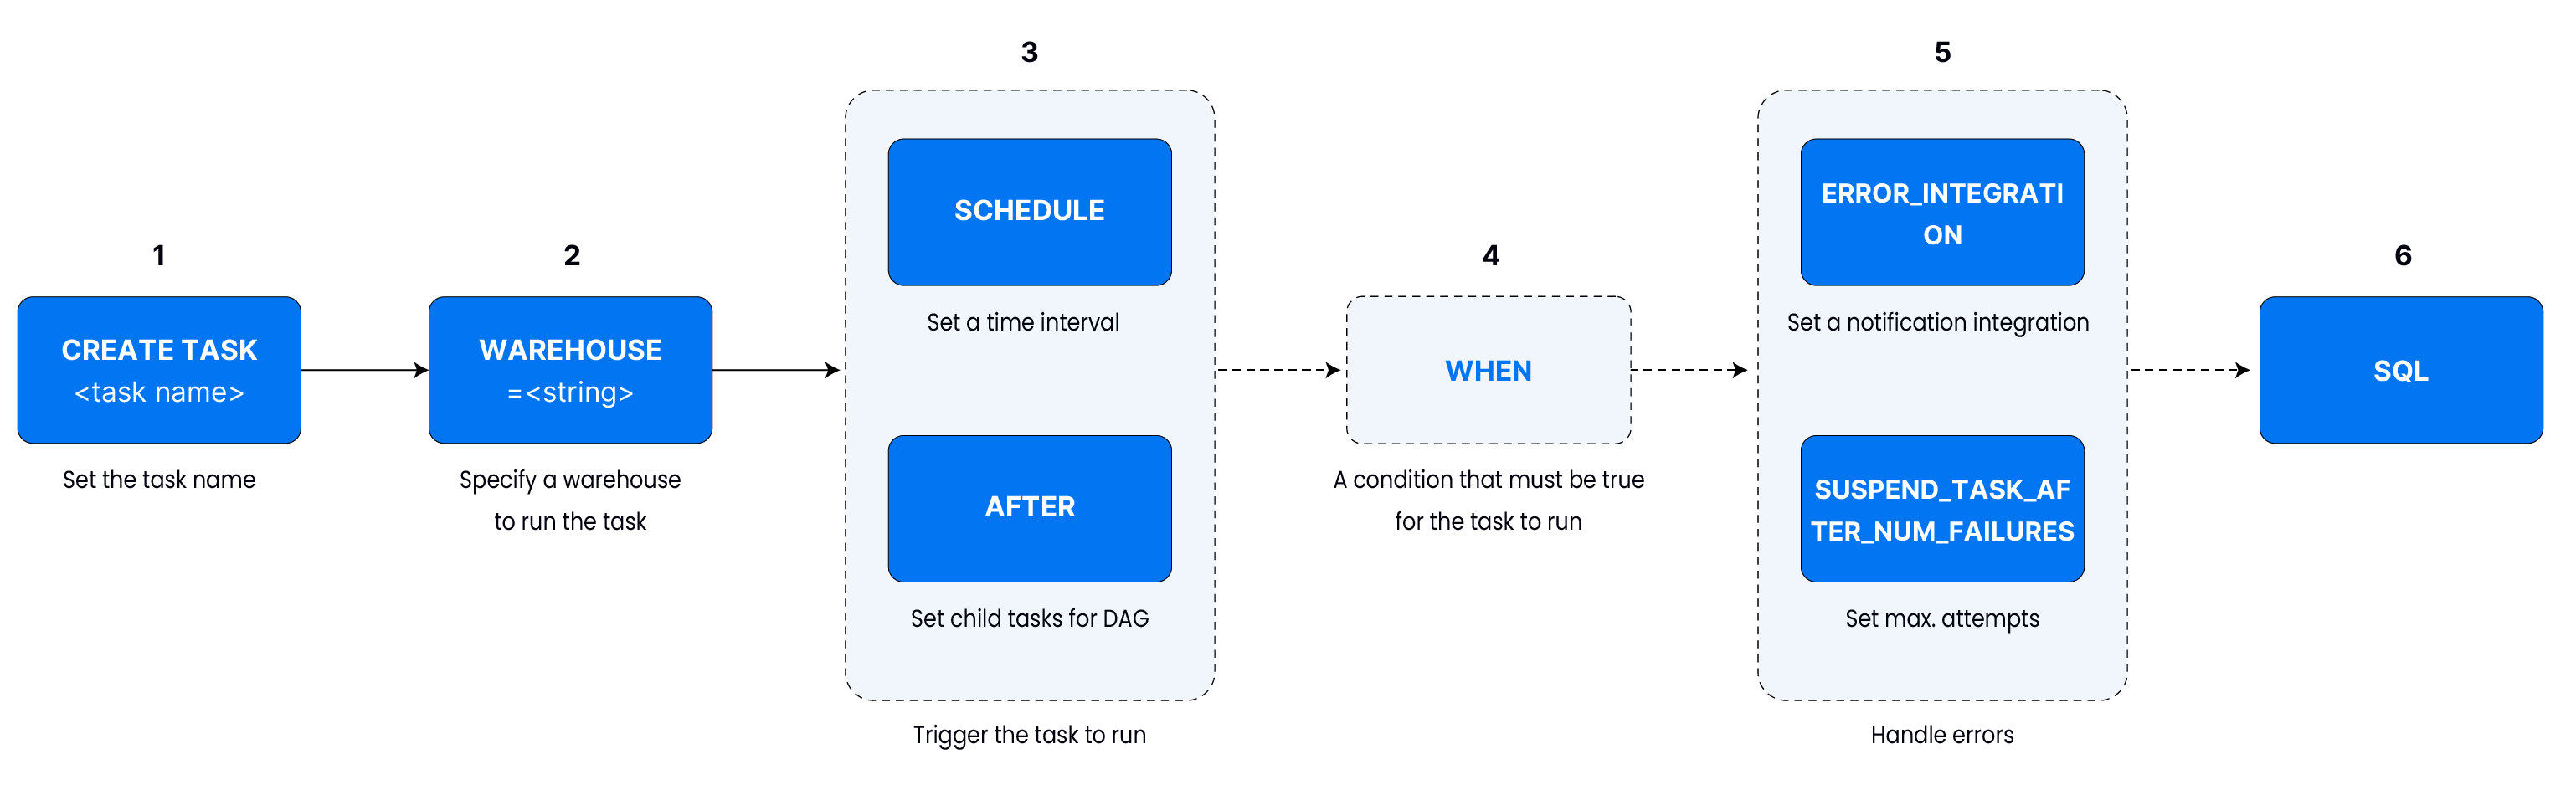
名前と Warehouse – すべてのタスクには Warehouse が必要です。
CREATE TASK ingest_orders
WAREHOUSE = 'etl_wh'
AS SELECT 1;
トリガー – 固定間隔、CRON、または
AFTER another_taskを指定できます。CREATE TASK mytask WAREHOUSE = 'default' SCHEDULE = 2 MINUTE AS ...;ガード – 条件式が true の場合にのみ実行します。
CREATE TASK mytask
WAREHOUSE = 'default'
WHEN STREAM_STATUS('mystream') = TRUE
AS ...;
エラー処理 – N 回失敗した後に一時停止する、または通知を送信します。
CREATE TASK mytask
WAREHOUSE = 'default'
SUSPEND_TASK_AFTER_NUM_FAILURES = 3
AS ...;
SQL ペイロード –
ASの後に記述した内容が、そのタスクによって実行されます。CREATE TASK bump_age WAREHOUSE = 'default' SCHEDULE = USING CRON '0 0 1 1 * *' 'UTC' AS UPDATE employees SET age = age + 1;
例 1: スケジュールされたコピー
センサーデータを継続的に生成し、Parquet として保存して、テーブルにロード (load) します。すべての CREATE/ALTER TASK 文で、'etl_wh_small' をご自身の Warehouse 名に置き換えてください。
ステップ 1. デモ用オブジェクトを準備する
-- Create a playground schema and target table
CREATE DATABASE IF NOT EXISTS task_demo;
USE task_demo;

CREATE OR REPLACE TABLE sensor_events (
    event_time  TIMESTAMP,
    sensor_id   INT,
    temperature DOUBLE,
    humidity    DOUBLE
);

-- Stage that will store the generated Parquet files
CREATE OR REPLACE STAGE sensor_events_stage;
ステップ 2. Task 1 — ファイルを生成する
task_generate_data は、1 分ごとに 100 件のランダムな測定値を stage に書き込みます。各実行で新しい Parquet ファイルが生成され、下流のコンシューマーがそれを取り込みできます。
CREATE OR REPLACE TASK task_generate_data
    WAREHOUSE = 'etl_wh_small' -- replace with your warehouse
    SCHEDULE = 1 MINUTE
AS
COPY INTO @sensor_events_stage
FROM (
    SELECT
        NOW()            AS event_time,
        number           AS sensor_id,
        20 + RAND() * 5  AS temperature,
        60 + RAND() * 10 AS humidity
    FROM numbers(100)
)
FILE_FORMAT = (TYPE = PARQUET);
ステップ 3. Task 2 — ファイルをロードする
task_consume_data は同じ間隔で stage をスキャンし、新しく生成されたすべての Parquet ファイルを sensor_events テーブルにコピーします。PURGE = TRUE 句により、すでに取り込み済みのファイルはクリーンアップされます。
CREATE OR REPLACE TASK task_consume_data
    WAREHOUSE = 'etl_wh_small' -- replace with your warehouse
    SCHEDULE = 1 MINUTE
AS
COPY INTO sensor_events
FROM @sensor_events_stage
PATTERN = '.*[.]parquet'
FILE_FORMAT = (TYPE = PARQUET)
PURGE = TRUE;
ステップ 4. タスクを再開する
ALTER TASK task_generate_data RESUME;
ALTER TASK task_consume_data RESUME;
どちらのタスクも、再開するまでは一時停止状態で開始されます。最初のファイル生成とコピーは、次の 1 分以内に行われるはずです。
ステップ 5. パイプラインを監視する
-- Confirm that the tasks are running
SHOW TASKS LIKE 'task_%';

-- Inspect files on the stage (should shrink as PURGE removes processed files)
LIST @sensor_events_stage;

-- Check the ingested rows
SELECT *
FROM sensor_events
ORDER BY event_time DESC
LIMIT 5;

-- Review recent executions for troubleshooting
SELECT *
FROM task_history('task_consume_data', 5);

-- Change configuration later if needed
ALTER TASK task_consume_data
    SCHEDULE = 30 SECOND,
    WAREHOUSE = 'etl_wh_medium'; -- replace with your warehouse
テストが完了したら、ALTER TASK ... SUSPEND を使ってどちらのタスクも一時停止できます。
ステップ 6. タスクを更新する
タスクを削除しなくても、スケジュール、Warehouse、さらには SQL ペイロードまで変更できます。
-- Tweak the schedule and warehouse
ALTER TASK task_consume_data
    SCHEDULE = 30 SECOND,
    WAREHOUSE = 'etl_wh_medium'; -- replace with your warehouse

-- Update the SQL payload (replace the existing body)
ALTER TASK task_consume_data
    AS
COPY INTO sensor_events
FROM @sensor_events_stage
FILE_FORMAT = (TYPE = PARQUET);

-- Resume after edits (tasks suspend when their SQL changes)
ALTER TASK task_consume_data RESUME;

-- Review execution history for verification
SELECT *
FROM task_history('task_consume_data', 5)
ORDER BY completed_time DESC;
TASK_HISTORY はステータス、実行時間、クエリ ID を返すため、変更内容を簡単に再確認できます。
例 2: Stream トリガーによるマージ
WHEN STREAM_STATUS(...) を使用すると、ストリームに新しい行がある場合にのみ実行できます。例 1 の sensor_events テーブルを再利用します。
ステップ 1. ストリームと最新テーブルを作成する
-- Create a stream on the sensor table (Standard mode to capture every mutation)
CREATE OR REPLACE STREAM sensor_events_stream
    ON TABLE sensor_events
    APPEND_ONLY = false;

-- Target table that keeps only the latest copy of each row
CREATE OR REPLACE TABLE sensor_events_latest AS
SELECT *
FROM sensor_events
WHERE 1 = 0;
ステップ 2. 条件付きタスクを作成する
CREATE OR REPLACE TASK task_stream_merge
    WAREHOUSE = 'etl_wh_small' -- replace with your warehouse
    SCHEDULE = 1 MINUTE
    WHEN STREAM_STATUS('task_demo.sensor_events_stream') = TRUE
AS
INSERT INTO sensor_events_latest
SELECT *
FROM sensor_events_stream;

ALTER TASK task_stream_merge RESUME;
ステップ 3. 動作を確認する
SELECT *
FROM sensor_events_latest
ORDER BY event_time DESC
LIMIT 5;

SELECT *
FROM task_history('task_stream_merge', 5);
このタスクは、STREAM_STATUS('<database>.<stream_name>') が TRUE を返した場合にのみ実行されます。現在のスキーマに関係なくタスクがストリームを解決できるよう、ストリームには必ずそのデータベース名をプレフィックスとして付けてください(例: task_demo.sensor_events_stream)。また、すべての CREATE/ALTER TASK では、自身の Warehouse 名を使用してください。