从存储桶加载
当数据文件存储在对象存储存储桶(例如 Amazon S3)中时,可以使用 COPY INTO 命令将其直接加载到 TiDB Cloud Lake 中。请注意,文件必须采用 TiDB Cloud Lake 支持的格式,否则无法导入数据。有关 TiDB Cloud Lake 支持的文件格式的更多信息,请参见 输入与输出文件格式。
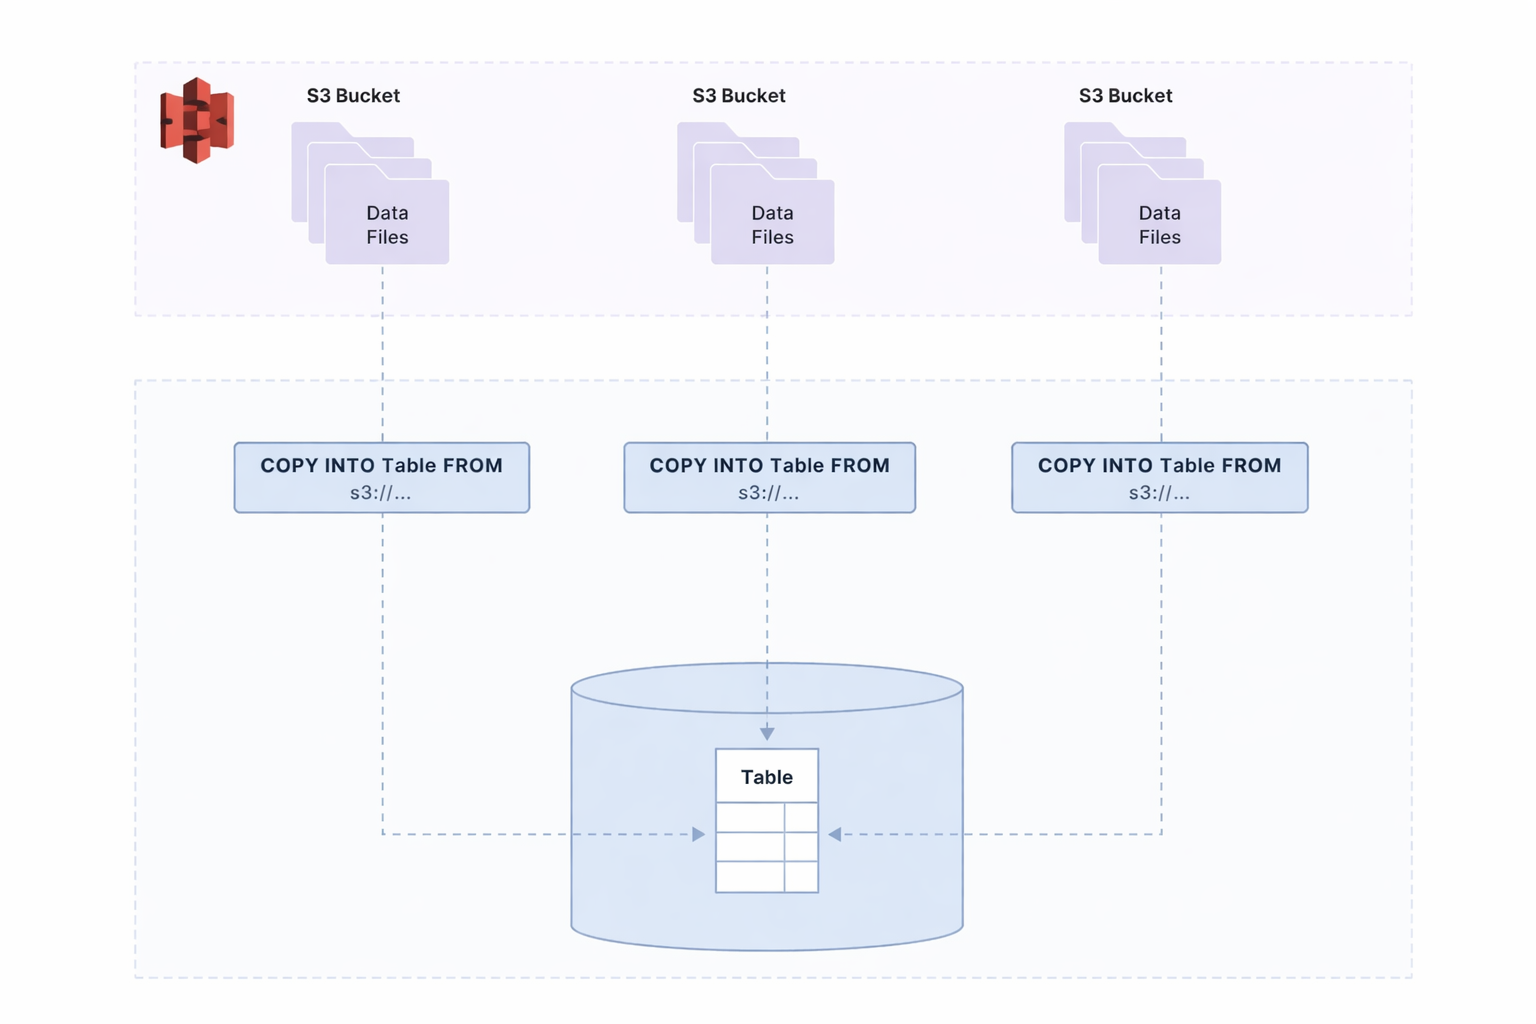
本教程以 Amazon S3 存储桶为例,提供详细的分步指南,帮助你顺利完成从存储桶中的文件加载数据的过程。
教程:从 Amazon S3 存储桶加载
开始之前
开始之前,请确保你已完成以下任务:
将示例文件 books.parquet 下载并保存到本地文件夹中。该文件包含两条记录:
Transaction Processing,Jim Gray,1992
Readings in Database Systems,Michael Stonebraker,2004
在 Amazon S3 中创建一个存储桶,并将示例文件上传到该存储桶。具体操作请参考以下链接:
- 创建存储桶:https://docs.aws.amazon.com/AmazonS3/latest/userguide/create-bucket-overview.html
- 上传对象:https://docs.aws.amazon.com/AmazonS3/latest/userguide/upload-objects.html
在本教程中,将在区域 US East (Ohio)(ID:us-east-2)中创建一个名为 lake-toronto 的存储桶。
步骤 1:创建目标表
在 TiDB Cloud Lake 中使用以下 SQL 语句创建表:
USE default;
CREATE TABLE books
(
    title VARCHAR,
    author VARCHAR,
    date VARCHAR
);
步骤 2:将数据复制到表中
使用 COPY INTO 命令将数据加载到目标表中:
COPY INTO books
FROM 's3://lake-toronto/'
CONNECTION = (
    ACCESS_KEY_ID = '<your-access-key-id>',
    SECRET_ACCESS_KEY = '<your-secret-access-key>'
)
PATTERN = '.*[.]parquet'
FILE_FORMAT = (
    TYPE = 'PARQUET'
);
检查已加载的数据:
SELECT * FROM books;

---
title                       |author             |date|
----------------------------+-------------------+----+
Transaction Processing      |Jim Gray           |1992|
Readings in Database Systems|Michael Stonebraker|2004|