TiDB Cloud Lake vs. Snowflake: 数据摄取基准测试
概览
我们进行了四项具体的基准测试,以评估 TiDB Cloud Lake 与 Snowflake:
- TPC-H SF100 数据集加载:重点比较大规模数据集(100GB,约 6 亿行)的加载性能和成本。
- ClickBench Hits 数据集加载:测试宽表数据集(76GB,约 1 亿行,105 列)的加载效率,重点关注高列数带来的挑战。
- 1 秒新鲜度:衡量平台在严格的 1 秒新鲜度要求下摄取数据的能力。
- 5 秒新鲜度:比较平台在 5 秒新鲜度约束下的数据摄取能力。
平台
- Snowflake:知名的云数据平台,强调可扩展计算和数据共享。
- TiDB Cloud Lake:云原生数据仓库,专注于扩展性和成本效益。
基准测试条件
在 Small-Size 计算集群上进行测试,并使用同一个 S3 存储桶中的数据。
性能与成本对比
- TPC-H SF100 数据:与 Snowflake 相比,TiDB Cloud Lake 可将成本降低 48%。
- ClickBench Hits 数据:TiDB Cloud Lake 实现了 84% 的成本降低。
- 1 秒新鲜度:TiDB Cloud Lake 的数据加载量是 Snowflake 的 400 倍。
- 5 秒新鲜度:TiDB Cloud Lake 的数据加载量超过 27 倍。
数据摄取基准测试
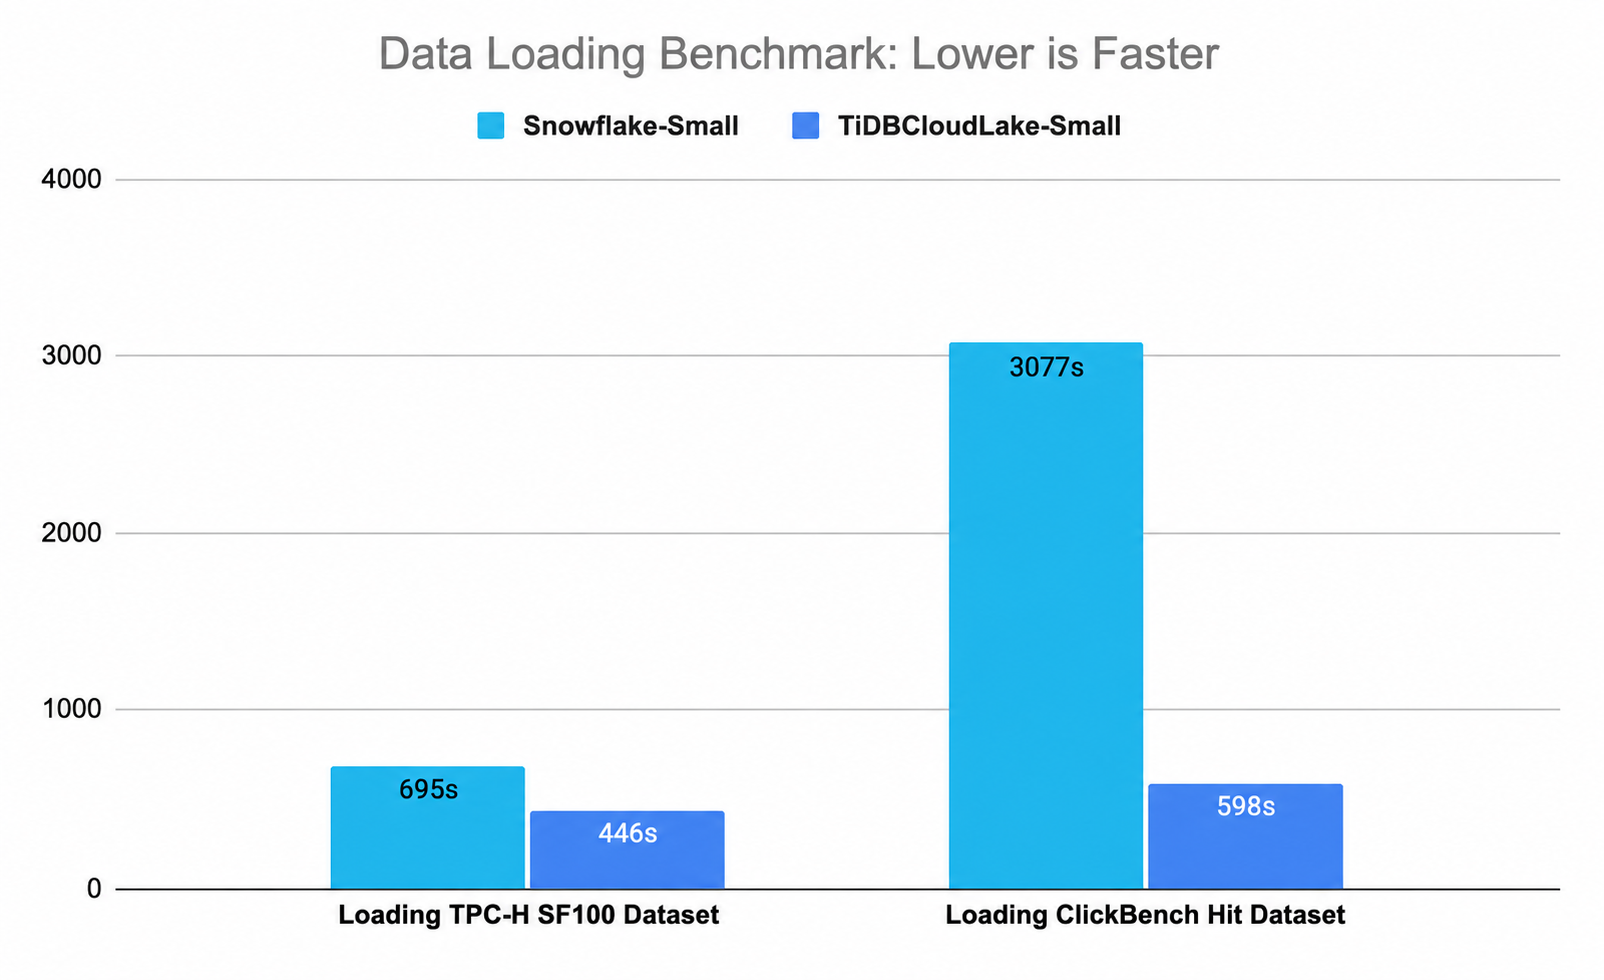
TPC-H SF100 数据集
- Data Volume: 100GB
- Rows: Approx. 600 million
ClickBench Hits 数据集
- Data Volume: 76GB
- Rows: Approx. 100 million
- Table Width: 105 columns
新鲜度基准测试
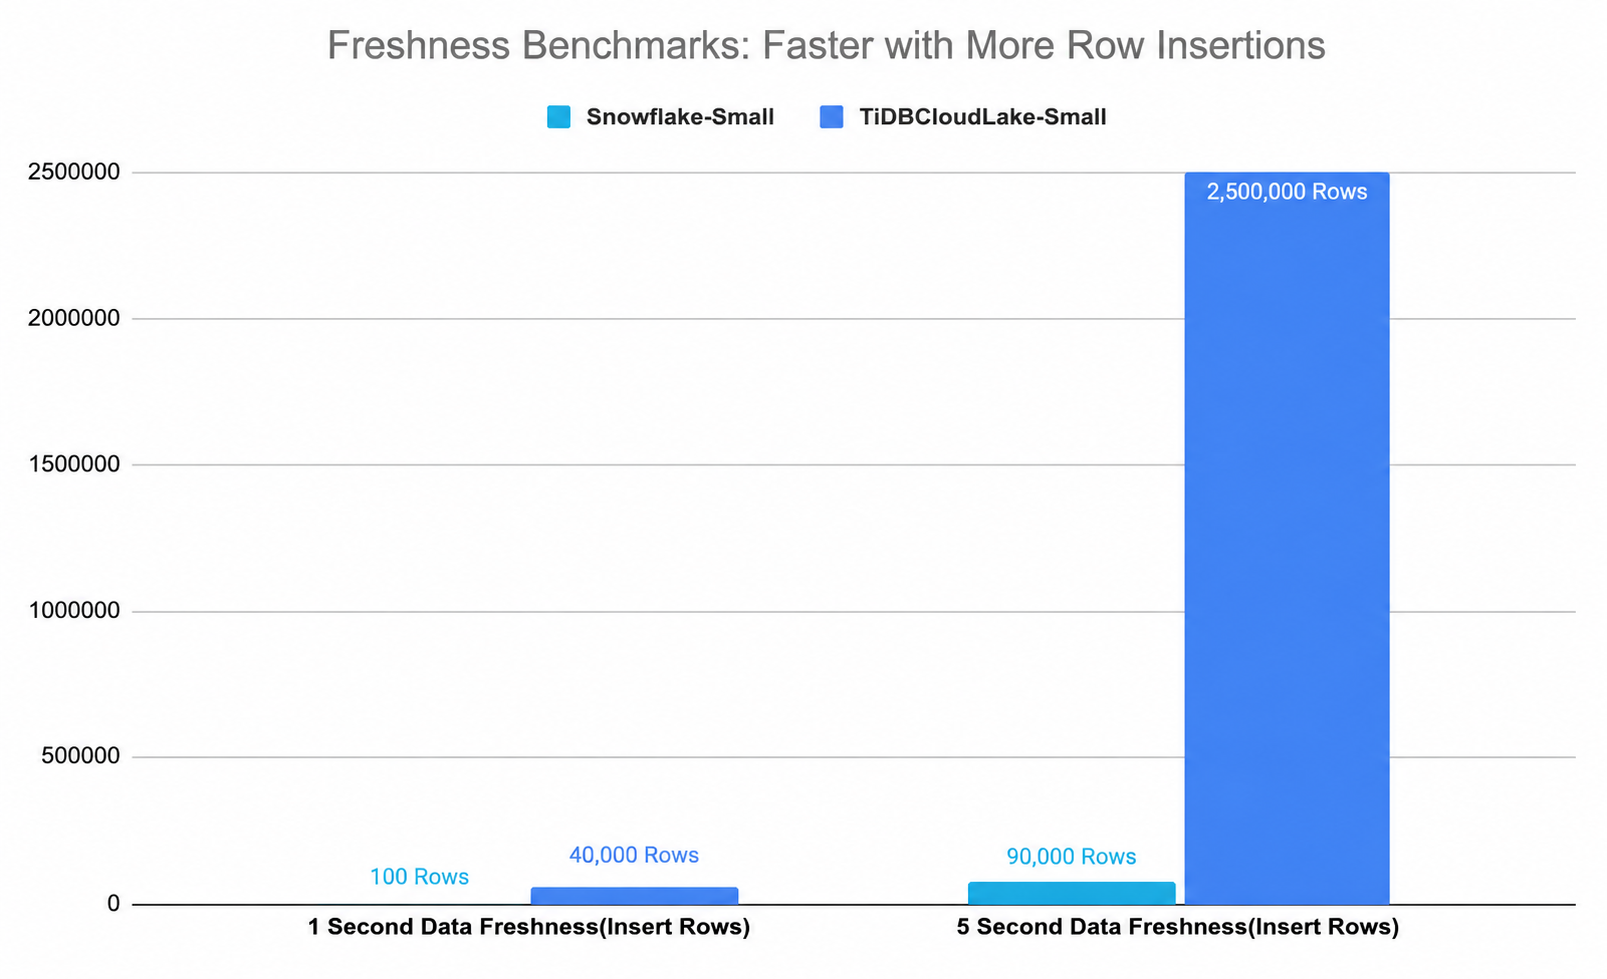
1 秒新鲜度基准测试
评估在 1 秒新鲜度要求内成功摄取的数据量。
5 秒新鲜度基准测试
评估在 5 秒新鲜度要求内可摄取的数据量。
复现基准测试
你可以按照以下步骤复现该基准测试。
基准测试环境
该基准测试在相似条件下对 Snowflake 和 TiDB Cloud Lake 进行了测试:
- TPC-H SF100 数据集来源于 Amazon Redshift。
- ClickBench 数据集来源于 ClickBench。
前提条件
- 拥有一个 Snowflake account
- 创建一个 TiDB Cloud Lake account
数据摄取基准测试
可以按照以下步骤复现数据摄取基准测试:
TPC-H Data Loading
Snowflake Data Load:
- 登录你的 Snowflake account。
- 创建与 TPC-H schema 对应的表。SQL Script。
- 使用
COPY INTO命令从 AWS S3 加载数据。SQL Script。
TiDB Cloud Lake Data Load:
- 登录你的 TiDB Cloud Lake account。
- 按照 TPC-H schema 创建所需的表。SQL Script。
- 使用与 Snowflake 类似的方法从 AWS S3 加载数据。SQL Script。
ClickBench Hits Data Loading
Snowflake Data Load:
- 登录你的 Snowflake account。
- 创建与
hitsschema 对应的表。SQL Script。 - 使用
COPY INTO命令从 AWS S3 加载数据。SQL Script。
TiDB Cloud Lake Data Load:
- 登录你的 TiDB Cloud Lake account。
- 按照
hitsschema 创建所需的表。SQL Script。 - 使用与 Snowflake 类似的方法从 AWS S3 加载数据。SQL Script。
新鲜度基准测试
可以按照以下步骤复现新鲜度基准测试的数据生成和摄取过程:
在 TiDB Cloud Lake 中创建一个 外部 Stage。
CREATE STAGE hits_unload_stage
URL = 's3://unload/files/'
CONNECTION = (
    ACCESS_KEY_ID = '<your-access-key-id>',
    SECRET_ACCESS_KEY = '<your-secret-access-key>'
);
将数据卸载到 external stage。
CREATE or REPLACE FILE FORMAT tsv_unload_format_gzip
    TYPE = TSV,
    COMPRESSION = gzip;

COPY INTO @hits_unload_stage
FROM (
    SELECT *
    FROM hits limit <the-rows-you-want>
)
FILE_FORMAT = (FORMAT_NAME = 'tsv_unload_format_gzip')
DETAILED_OUTPUT = true;
将数据从 external stage 加载到
hits表。COPY INTO hits FROM @hits_unload_stage PATTERN = '.*[.]tsv.gz' FILE_FORMAT = (TYPE = TSV, COMPRESSION=auto);从仪表板中查看结果。