TiDB 全局排序
概述
TiDB 全局排序功能提升了数据导入和 DDL(数据定义语言)操作的稳定性和效率。它作为 TiDB 分布式执行框架(DXF) 的通用算子,在云端提供全局排序服务。
目前,全局排序功能支持使用 Amazon S3 作为云存储。
使用场景
全局排序功能提升了 IMPORT INTO 和 CREATE INDEX 的稳定性和效率。通过对任务处理的数据进行全局排序,提升了向 TiKV 写入数据的稳定性、可控性和可扩展性,为数据导入和 DDL 任务带来更优的用户体验和更高质量的服务。
全局排序功能在统一的 DXF 内执行任务,确保数据在全局范围内高效并行排序。
限制
目前,全局排序功能不会作为查询执行流程中负责排序查询结果的组件使用。
使用方法
要启用全局排序,请按照以下步骤操作:
通过设置
tidb_enable_dist_task为ON启用 DXF。从 v8.1.0 开始,该变量默认开启。对于 v8.1.0 及以上版本新建的集群,可以跳过此步骤。SET GLOBAL tidb_enable_dist_task = ON;
将
tidb_cloud_storage_uri设置为正确的云存储路径。参见示例。SET GLOBAL tidb_cloud_storage_uri = 's3://my-bucket/test-data?role-arn=arn:aws:iam::888888888888:role/my-role'
实现原理
全局排序功能的算法如下:
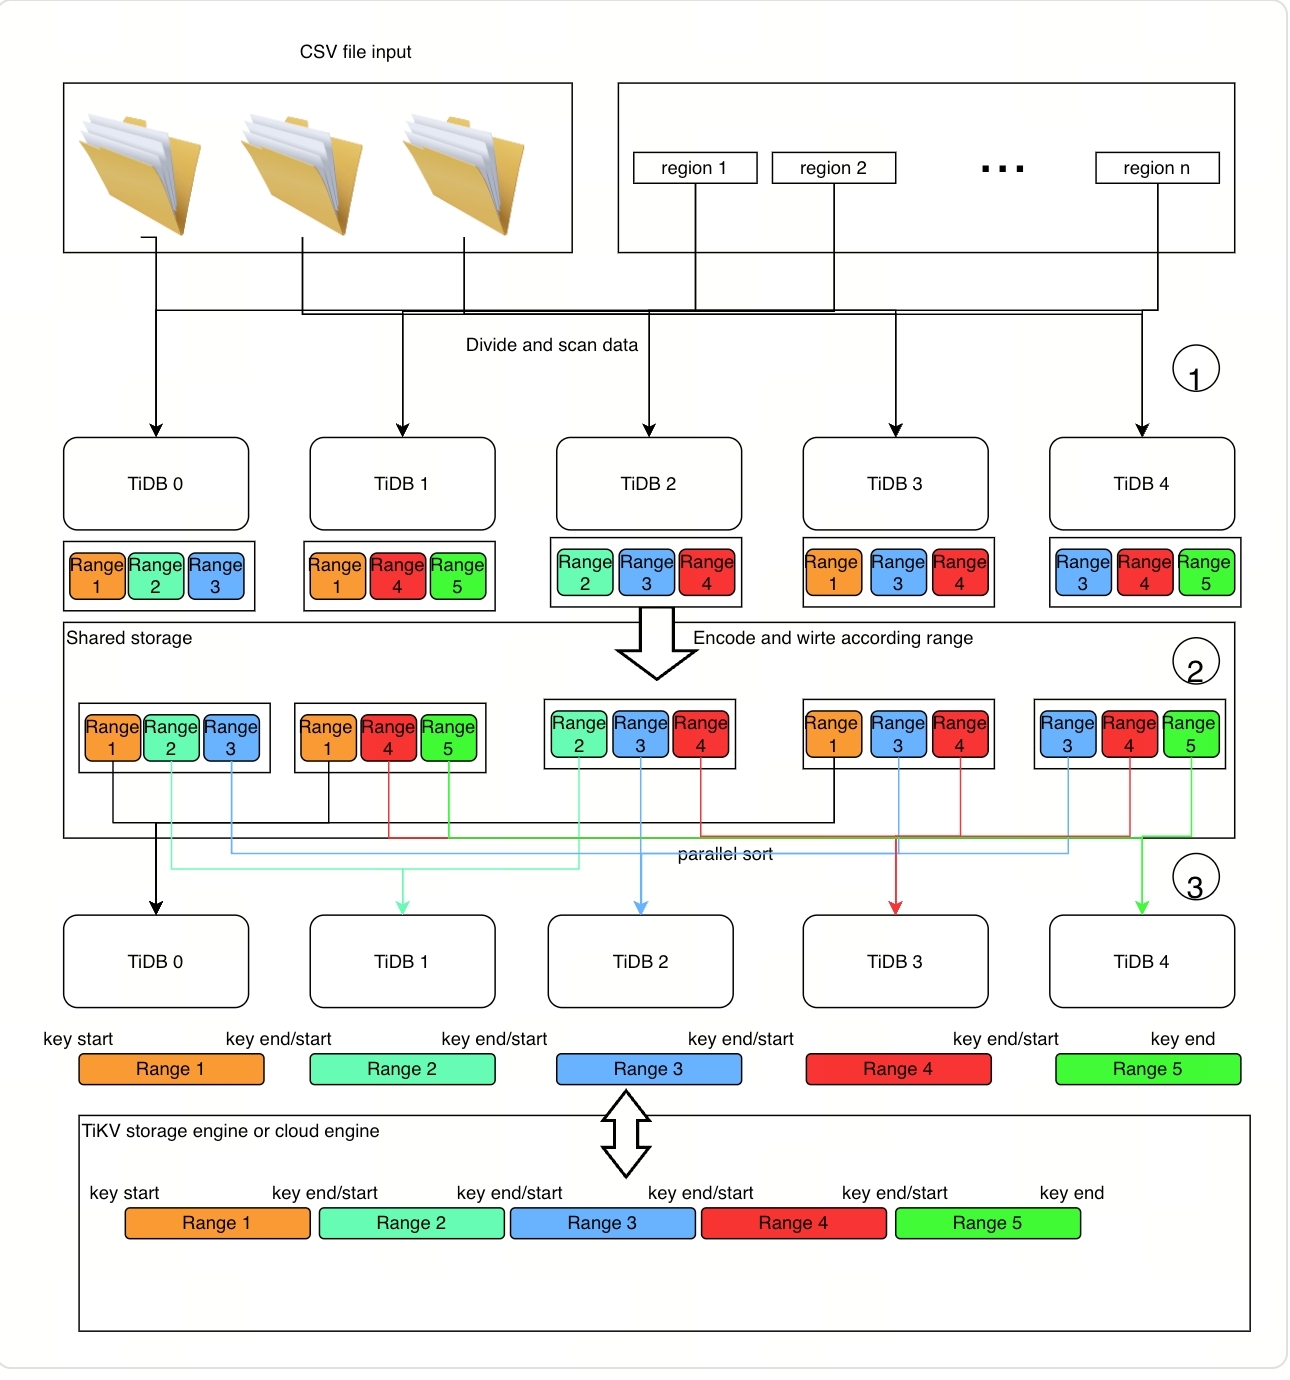
具体实现原理如下:
第 1 步:扫描并准备数据
TiDB 节点扫描特定范围的数据后(数据源可以是 CSV 数据,也可以是 TiKV 中的表数据):
- TiDB 节点将其编码为 Key-Value 对。
- TiDB 节点将 Key-Value 对排序为若干块数据段(每个数据段在本地已排序),每个数据段为一个文件,并上传到云存储。
TiDB 节点还会为每个数据段记录一组实际的 Key-Value 范围(称为统计文件),这是实现可扩展排序的关键准备。这些文件会与真实数据一起上传到云存储。
第 2 步:排序并分发数据
在第 1 步中,全局排序程序获得了已排序的数据块列表及其对应的统计文件,这些文件提供了本地已排序块的数量。程序还拥有可供 PD 拆分和分散的真实数据范围。具体步骤如下:
- 对统计文件中的记录进行排序,将其划分为近似等大小的范围,这些范围即为将要并行执行的子任务。
- 将子任务分发到 TiDB 节点执行。
- 每个 TiDB 节点独立地将子任务的数据排序为范围,并无重叠地导入到 TiKV。