使用任务自动化数据加载
任务会封装 SQL,使 TiDB Cloud Lake 能够按调度或在满足条件时为你运行它。在使用 CREATE TASK 定义任务时,请注意以下可调参数。
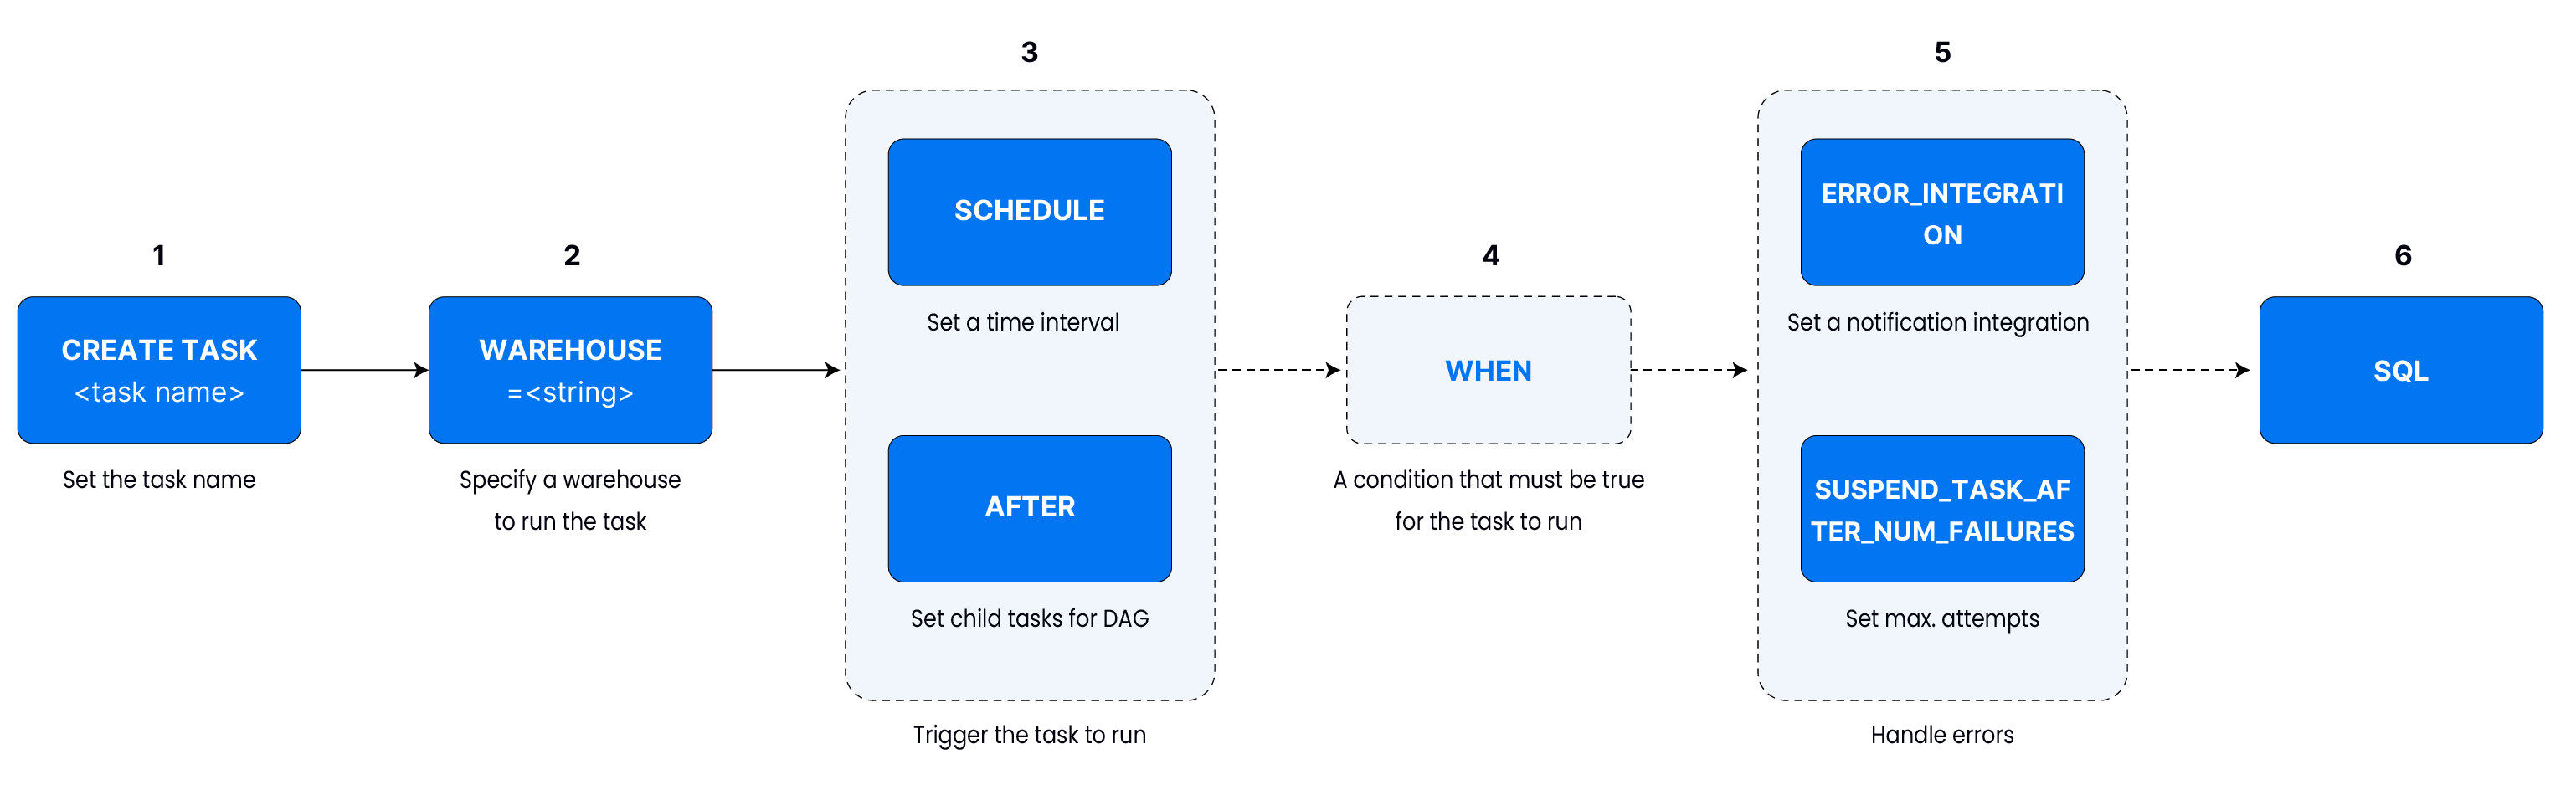
名称和计算集群 – 每个任务都需要一个计算集群。
CREATE TASK ingest_orders
WAREHOUSE = 'etl_wh'
AS SELECT 1;
触发器 – 固定时间间隔、CRON,或
AFTER another_task。CREATE TASK mytask WAREHOUSE = 'default' SCHEDULE = 2 MINUTE AS ...;保护条件 – 仅当谓词为 true 时才运行。
CREATE TASK mytask
WAREHOUSE = 'default'
WHEN STREAM_STATUS('mystream') = TRUE
AS ...;
错误处理 – 在失败 N 次后暂停,或发送通知。
CREATE TASK mytask
WAREHOUSE = 'default'
SUSPEND_TASK_AFTER_NUM_FAILURES = 3
AS ...;
SQL 负载 – 放在
AS之后的内容就是任务会执行的内容。CREATE TASK bump_age WAREHOUSE = 'default' SCHEDULE = USING CRON '0 0 1 1 * *' 'UTC' AS UPDATE employees SET age = age + 1;
示例 1:按调度复制
持续生成传感器数据,将其落地为 Parquet 文件,并加载到表中。请将每条 CREATE/ALTER TASK 语句中的 'etl_wh_small' 替换为你的计算集群名称。
步骤 1:准备演示对象
-- Create a playground schema and target table
CREATE DATABASE IF NOT EXISTS task_demo;
USE task_demo;

CREATE OR REPLACE TABLE sensor_events (
    event_time  TIMESTAMP,
    sensor_id   INT,
    temperature DOUBLE,
    humidity    DOUBLE
);

-- Stage that will store the generated Parquet files
CREATE OR REPLACE STAGE sensor_events_stage;
步骤 2:任务 1 — 生成文件
task_generate_data 每分钟向 stage 写入 100 条随机读数。每次执行都会生成一个新的 Parquet 文件,供下游消费者摄取。
CREATE OR REPLACE TASK task_generate_data
    WAREHOUSE = 'etl_wh_small' -- replace with your warehouse
    SCHEDULE = 1 MINUTE
AS
COPY INTO @sensor_events_stage
FROM (
    SELECT
        NOW()            AS event_time,
        number           AS sensor_id,
        20 + RAND() * 5  AS temperature,
        60 + RAND() * 10 AS humidity
    FROM numbers(100)
)
FILE_FORMAT = (TYPE = PARQUET);
步骤 3:任务 2 — 加载文件
task_consume_data 以相同频率扫描 stage,并将每个新生成的 Parquet 文件复制到 sensor_events 表中。PURGE = TRUE 子句会清理已被摄取的文件。
CREATE OR REPLACE TASK task_consume_data
    WAREHOUSE = 'etl_wh_small' -- replace with your warehouse
    SCHEDULE = 1 MINUTE
AS
COPY INTO sensor_events
FROM @sensor_events_stage
PATTERN = '.*[.]parquet'
FILE_FORMAT = (TYPE = PARQUET)
PURGE = TRUE;
步骤 4:恢复任务
ALTER TASK task_generate_data RESUME;
ALTER TASK task_consume_data RESUME;
这两个任务在你恢复之前都会处于暂停状态。预计首批文件生成和复制会在接下来的一分钟内发生。
步骤 5:监控流水线
-- Confirm that the tasks are running
SHOW TASKS LIKE 'task_%';

-- Inspect files on the stage (should shrink as PURGE removes processed files)
LIST @sensor_events_stage;

-- Check the ingested rows
SELECT *
FROM sensor_events
ORDER BY event_time DESC
LIMIT 5;

-- Review recent executions for troubleshooting
SELECT *
FROM task_history('task_consume_data', 5);

-- Change configuration later if needed
ALTER TASK task_consume_data
    SCHEDULE = 30 SECOND,
    WAREHOUSE = 'etl_wh_medium'; -- replace with your warehouse
测试完成后,你可以使用 ALTER TASK ... SUSPEND 暂停任一任务。
步骤 6:修改任务
你可以修改调度、计算集群,甚至 SQL 负载,而无需删除任务:
-- Tweak the schedule and warehouse
ALTER TASK task_consume_data
    SCHEDULE = 30 SECOND,
    WAREHOUSE = 'etl_wh_medium'; -- replace with your warehouse

-- Update the SQL payload (replace the existing body)
ALTER TASK task_consume_data
    AS
COPY INTO sensor_events
FROM @sensor_events_stage
FILE_FORMAT = (TYPE = PARQUET);

-- Resume after edits (tasks suspend when their SQL changes)
ALTER TASK task_consume_data RESUME;

-- Review execution history for verification
SELECT *
FROM task_history('task_consume_data', 5)
ORDER BY completed_time DESC;
TASK_HISTORY 会返回状态、时间信息和查询 ID,便于你再次验证修改结果。
示例 2:由 Stream 触发的 Merge
使用 WHEN STREAM_STATUS(...) 仅在 stream 有新行时触发。复用示例 1 中的 sensor_events 表。
步骤 1:创建 stream 和 latest 表
-- Create a stream on the sensor table (Standard mode to capture every mutation)
CREATE OR REPLACE STREAM sensor_events_stream
    ON TABLE sensor_events
    APPEND_ONLY = false;

-- Target table that keeps only the latest copy of each row
CREATE OR REPLACE TABLE sensor_events_latest AS
SELECT *
FROM sensor_events
WHERE 1 = 0;
第 2 步:创建条件任务
CREATE OR REPLACE TASK task_stream_merge
    WAREHOUSE = 'etl_wh_small' -- replace with your warehouse
    SCHEDULE = 1 MINUTE
    WHEN STREAM_STATUS('task_demo.sensor_events_stream') = TRUE
AS
INSERT INTO sensor_events_latest
SELECT *
FROM sensor_events_stream;

ALTER TASK task_stream_merge RESUME;
第 3 步:验证行为
SELECT *
FROM sensor_events_latest
ORDER BY event_time DESC
LIMIT 5;

SELECT *
FROM task_history('task_stream_merge', 5);
只有当 STREAM_STATUS('<database>.<stream_name>') 返回 TRUE 时,任务才会触发。请始终为 stream 添加其所属数据库前缀(例如 task_demo.sensor_events_stream),这样无论当前 schema 是什么,任务都能正确解析它;并且在每个 CREATE/ALTER TASK 中使用你自己的 Warehouse 名称。