向量搜索概述
向量搜索为跨多种数据类型(如文档、图像、音频和视频)进行语义相似性搜索提供了强大的解决方案。它使开发者能够利用其 MySQL 专业知识构建具备生成式 AI 能力的可扩展应用,从而简化高级搜索功能的集成。
概念
向量搜索是一种优先考虑数据语义含义的搜索方法,用于返回相关结果。
与依赖精确关键字匹配和词频的传统全文搜索不同,向量搜索会将各种数据类型(如文本、图像或音频)转换为高维向量,并基于这些向量之间的相似性进行查询。这种搜索方法能够捕捉数据的语义含义和上下文信息,从而更准确地理解用户意图。
即使搜索词与数据库中的内容并不完全匹配,向量搜索仍然可以通过分析数据语义,返回符合用户意图的结果。
例如,对 “a swimming animal” 进行全文搜索时,只会返回包含这些精确关键字的结果。相比之下,向量搜索即使在结果中不包含这些精确关键字,也可以返回其他会游泳的动物,例如鱼或鸭子。
向量嵌入
向量嵌入(也称为 embedding)是一串数字序列,用于在高维空间中表示现实世界中的对象。它能够捕捉文档、图像、音频和视频等非结构化数据的含义和上下文。
向量嵌入是机器学习中的关键基础,也是语义相似性搜索的基础。
TiDB 引入了 向量数据类型 和 向量搜索索引,用于优化向量嵌入的存储和检索,增强其在 AI 应用中的使用效果。你可以将向量嵌入存储在 TiDB 中,并使用这些数据类型执行向量搜索查询,以找到最相关的数据。
嵌入模型
嵌入模型是将数据转换为向量嵌入的算法。
选择合适的嵌入模型对于确保语义搜索结果的准确性和相关性至关重要。对于非结构化文本数据,你可以在 Massive Text Embedding Benchmark (MTEB) Leaderboard 上找到表现最佳的文本嵌入模型。
要了解如何为你的特定数据类型生成向量嵌入,请参阅嵌入模型的集成教程或示例。
向量搜索的工作原理
将原始数据转换为向量嵌入并存储到 TiDB 后,你的应用程序就可以执行向量搜索查询,以查找在语义或上下文上与用户查询最相关的数据。
TiDB 向量搜索通过使用距离函数计算给定向量与数据库中存储向量之间的距离,从而识别 top-k 最近邻(KNN)向量。在查询中,与给定向量距离最近的向量代表了在语义上最相似的数据。
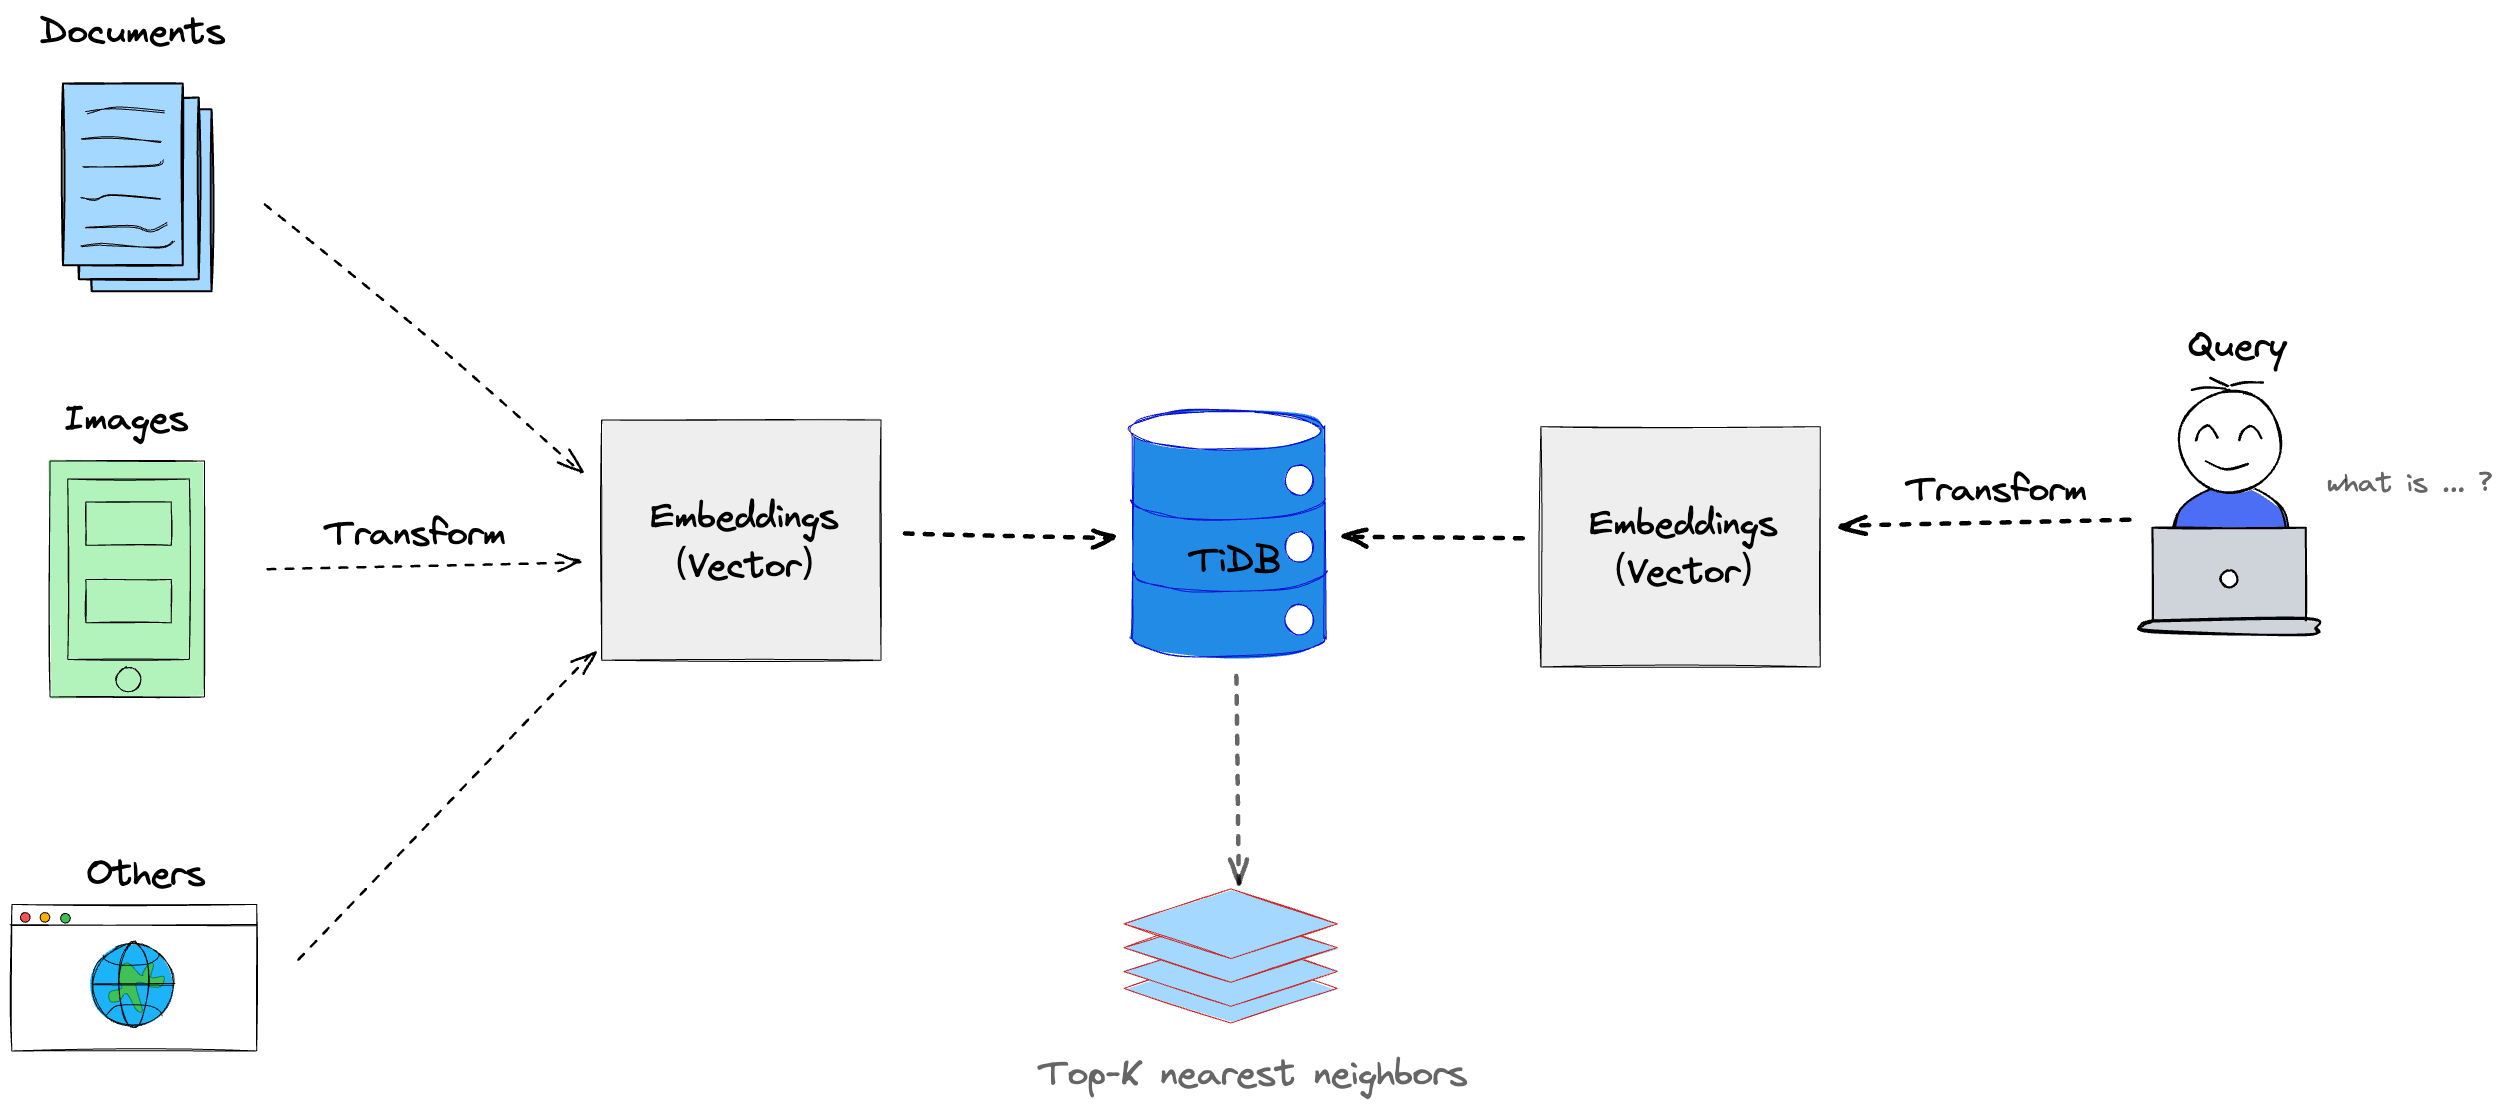
作为一个集成了向量搜索能力的关系型数据库,TiDB 允许你将数据及其对应的向量表示(向量嵌入)一起存储在同一个数据库中。你可以通过以下任一方式存储数据:
- 将数据及其对应的向量表示存储在同一张表的不同列中。
- 将数据及其对应的向量表示存储在不同的表中。在这种方式下,检索数据时需要使用
JOIN查询来组合这些表。
使用场景
检索增强生成(RAG)
检索增强生成(RAG)是一种用于优化大语言模型(LLM)输出的架构。通过使用向量搜索,RAG 应用可以将向量嵌入存储在数据库中,并在 LLM 生成响应时检索相关文档作为额外上下文,从而提升答案的质量和相关性。
语义搜索
语义搜索是一种基于查询含义返回结果的搜索技术,而不是仅仅匹配关键字。它使用向量嵌入来理解不同语言以及不同类型数据(如文本、图像和音频)中的含义。随后,向量搜索算法利用这些向量嵌入来查找最符合用户查询的数据。
推荐引擎
推荐引擎是一种主动向用户推荐相关且个性化内容、产品或服务的系统。它通过创建表示用户行为和偏好的向量嵌入来实现这一点。这些向量嵌入帮助系统识别其他用户曾交互过或表现出兴趣的相似项目,从而提高推荐内容既相关又对用户有吸引力的可能性。
另请参阅
要开始使用 TiDB 向量搜索,请参阅以下文档: