パフォーマンス分析とチューニング
このドキュメントでは、データベース時間によるチューニング方法について説明し、パフォーマンス分析とチューニングに TiDB パフォーマンス概要ダッシュボードを使用する方法を示します。
このドキュメントで説明する手法を用いることで、ユーザー応答時間とデータベース時間をグローバルかつトップダウンの視点から分析し、ユーザー応答時間のボトルネックがデータベースの問題に起因するかどうかを確認できます。ボトルネックがデータベースにある場合は、データベース時間の概要とSQLレイテンシーの内訳を使用してボトルネックを特定し、パフォーマンスを調整できます。
データベース時間に基づくパフォーマンスチューニング
TiDBは、SQL処理パスとデータベース時間を継続的に測定・収集します。そのため、TiDBではデータベースパフォーマンスのボトルネックを容易に特定できます。データベース時間メトリクスに基づいて、ユーザー応答時間のデータがない場合でも、次の2つの目標を達成できます。
- トランザクション内の平均 SQL 処理レイテンシーと TiDB 接続のアイドル時間を比較して、ボトルネックが TiDB にあるかどうかを判断します。
- ボトルネックが TiDB にある場合は、データベース時間の概要、色ベースのパフォーマンスデータ、主要なメトリック、リソース使用率、トップダウンのレイテンシーの内訳に基づいて、分散システム内の正確なモジュールをさらに特定します。
TiDB がボトルネックですか?
トランザクションにおけるTiDB接続の平均アイドル時間が平均SQL処理レイテンシーよりも長い場合、アプリケーションのトランザクションレイテンシーの原因はデータベースではありません。データベース時間はユーザー応答時間のごく一部を占めるに過ぎないため、ボトルネックはデータベース外にあると考えられます。
この場合、データベースの外部コンポーネントを確認してください。例えば、アプリケーションサーバーに十分なハードウェアリソースがあるかどうか、アプリケーションからデータベースへのネットワークレイテンシーが過度に高くないかなどを確認します。
平均 SQL 処理レイテンシーがトランザクション内の TiDB 接続の平均アイドル時間よりも長い場合、トランザクションのボトルネックは TiDB にあり、データベース時間がユーザー応答時間の大部分を占めます。
ボトルネックが TiDB にある場合、それをどのように特定しますか?
次の図は、典型的なSQLプロセスを示しています。ほとんどのSQL処理パスがTiDBパフォーマンスメトリックでカバーされていることがわかります。データベース時間は様々なディメンションに分割され、それぞれ色分けされています。これにより、ワークロード特性を迅速に把握し、データベース内のボトルネックがあればそれを特定できます。

データベース時間は、すべてのSQL処理時間の合計です。データベース時間を以下の3つの側面に分解すると、TiDBのボトルネックを迅速に特定するのに役立ちます。
SQL処理の種類別:どの種類のSQL文が最もデータベース時間を消費しているかを特定します。計算式は次のとおりです。
DB Time = Select Time + Insert Time + Update Time + Delete Time + Commit Time + ...SQL処理の4つのステップ(get_token/parse/compile/execute)ごとに、どのステップが最も時間を消費しているかを判断します。計算式は以下のとおりです。
DB Time = Get Token Time + Parse Time + Compile Time + Execute Time実行時間、TSO待機時間、KVリクエスト時間、実行再試行時間に基づいて、ボトルネックとなっている実行ステップを特定します。計算式は以下のとおりです。
Execute Time ~= TiDB Executor Time + KV Request Time + PD TSO Wait Time + Retried execution time
パフォーマンス概要ダッシュボードを使用したパフォーマンス分析とチューニング
このセクションでは、Grafana のパフォーマンス概要ダッシュボードを使用して、データベース時間に基づいてパフォーマンス分析とチューニングを実行する方法について説明します。
パフォーマンス概要ダッシュボードは、TiDB、PD、および TiKV のメトリックを調整し、それぞれを次のセクションで表示します。
- データベース時間と SQL 実行時間の概要: 色分けされた SQL タイプ、SQL 実行フェーズ別のデータベース時間、およびさまざまなリクエストのデータベース時間により、データベースのワークロード特性とパフォーマンスのボトルネックを迅速に特定できます。
- 主要なメトリックとリソース使用率: データベース QPS、接続情報、アプリケーションとデータベース間のリクエストコマンド タイプ、データベース内部 TSO および KV リクエスト OPS、および TiDB/TiKV リソースの使用率が含まれます。
- トップダウンのレイテンシーの内訳: クエリレイテンシーと接続アイドル時間の比較、クエリレイテンシーの内訳、SQL 実行における TSO リクエストと KV リクエストのレイテンシー、および TiKV 内部書き込みレイテンシーの内訳が含まれます。
データベース時間とSQL実行時間の概要
データベース時間メトリックは、TiDB が 1秒あたりに SQL を処理するレイテンシーの合計であり、これは TiDB が 1秒あたりにアプリケーションの SQL リクエストを同時に処理する合計時間でもあります (アクティブな接続の数に等しい)。
パフォーマンス概要ダッシュボードには、以下の3つの積み上げ面グラフが表示されます。これらのグラフは、データベースのワークロードプロファイルを把握し、SQL実行中のステートメント、SQLフェーズ、TiKVまたはPDリクエストタイプの観点からボトルネックの原因を迅速に特定するのに役立ちます。
- Database Time By SQL Type
- Database Time By SQL Phase
- SQL Execute Time Overview
色で調整
データベース時間の内訳と実行時間の概要を示す図は、予想通りの時間消費と予想外の時間消費の両方を直感的に示します。そのため、パフォーマンスのボトルネックを迅速に特定し、ワークロードのプロファイルを把握できます。緑色と青色の領域は、通常の時間消費とリクエスト数を表します。これらの2つの図で、緑色または青色以外の領域が大きな割合を占めている場合、データベース時間の配分は不適切です。
Database Time By SQL Type:
- 青:
Select文 - 緑:
Update、Insert、CommitなどのDML文 - 赤:
StmtPrepare、StmtReset、StmtFetch、StmtCloseなどの一般的なSQLタイプ
- 青:
Database Time By SQL Phase:SQL実行フェーズは緑色で、その他のフェーズは赤色で表示されます。緑色以外の領域が大きい場合は、実行フェーズ以外のフェーズでデータベース時間が大量に消費されていることを意味し、さらなる原因分析が必要です。よくあるシナリオとしては、プリペアドプランキャッシュが利用できないために、オレンジ色で表示されるコンパイルフェーズで大きな領域が消費されているケースが挙げられます。
SQL Execute Time Overview:緑のメトリックは一般的なKV書き込みリクエスト(
PrewriteやCommitなど)、青のメトリックは一般的なKV読み取りリクエスト(CopやGetなど)、紫のメトリックはTiFlash MPPリクエストを表します。その他の色のメトリックは、注意が必要な予期しない状況を表します。例えば、悲観的ロックKVリクエストは赤で、TSO待機は濃い茶色でマークされています。青や緑以外の領域が大きい場合、SQL実行中にボトルネックが発生していることを意味します。例:- 重大なロック競合が発生した場合、赤色の領域が大きな割合を占めることになります。
- TSO の待ち時間に過度に時間がかかってしまうと、濃い茶色の領域が大きな割合を占めることになります。
例1: TPC-Cワークロード

Database Time By SQL Type: 最も時間のかかるステートメントは、
commit、update、select、およびinsert文です。Database Time By SQL Phase: 最も時間のかかるフェーズは緑色で表示される SQL 実行です。
SQL Execute Time Overview: SQL 実行で最も時間のかかる KV リクエストは、緑色の
PrewriteとCommitです。
例2: OLTP読み取り中心のワークロード

- Database Time By SQL Type: 時間のかかる主なステートメントは
SELECT、COMMIT、UPDATE、INSERTで、その中でSELECTが最も多くのデータベース時間を消費します。 - Database Time By SQL Phase: ほとんどの時間は緑色の
executeフェーズで消費されます。 - SQL Execute Time Overview: SQL 実行フェーズでは、濃い茶色の
pd tso_wait、青色のKV Get、緑色のPrewriteとCommit時間がかかっています。
例3: 読み取り専用OLTPワークロード

- Database Time By SQL Type: 主に
SELECT文です。 - Database Time By SQL Phase:時間のかかる主なフェーズは、オレンジ色の
compileフェーズと緑色のexecuteフェーズです。compileフェーズのレイテンシーが最も高く、TiDBが実行計画の生成に時間がかかりすぎていることを示しています。その後のパフォーマンスデータに基づいて根本原因をさらに特定する必要があります。 - SQL Execute Time Overview: 青色の KV BatchGet リクエストは、SQL 実行中に最も多くの時間を消費します。
例4: ロック競合ワークロード

- Database Time By SQL Type: 主に
UPDATE文です。 - Database Time By SQL Phase: ほとんどの時間は緑色の実行フェーズで消費されます。
- SQL Execute Time Overview:赤で示されているKVリクエストPessimisticLockは、SQL実行中に最も多くの時間を消費しており、実行時間はKVリクエストの合計時間よりも明らかに長くなっています。これは、書き込みステートメントにおける深刻なロック競合と頻繁なロック再試行によって
Retried execution timeが長くなっていることが原因です。現在、TiDBはRetried execution timeを測定していません。
例5: HTAP CH-ベンチマークワークロード
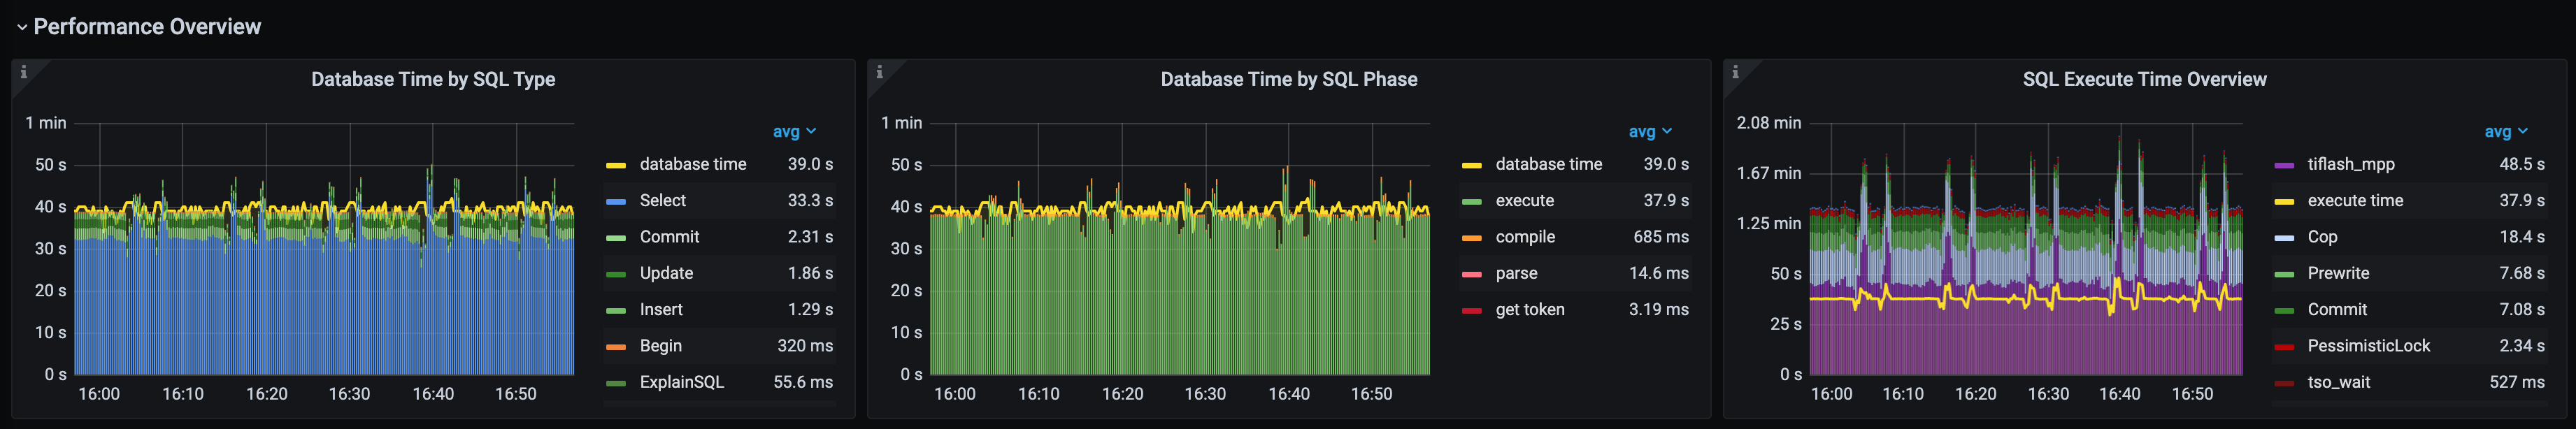
- Database Time By SQL Type: 主に
SELECT文です。 - Database Time By SQL Phase: ほとんどの時間は緑色の実行フェーズで消費されます。
- SQL Execute Time Overview: 紫色で表示される
tiflash_mppのリクエストは、SQL 実行中に最も多くの時間を消費します。次に、青色のCopのリクエストを含む KV リクエストと、緑色のPrewriteリクエストとCommitリクエストが続きます。
TiDB の主要メトリクスとクラスタリソースの使用率
Query Per Second, Command Per Second, and Prepared-Plan-Cache
パフォーマンス概要の次の3つのパネルを確認することで、アプリケーションのワークロード タイプ、アプリケーションが TiDB と対話する方法、アプリケーションが TiDB プリペアドプランキャッシュを最大限に活用しているかどうかを知ることができます。
QPS: Query Per Second(1秒あたりのクエリ数)の略。アプリケーションによって実行されたSQL文の数を示します。
CPS By Type: Command Per Secondの略。コマンドはMySQLプロトコル固有のコマンドを示します。クエリ文は、クエリコマンドまたはプリペアドステートメントのいずれかによってTiDBに送信できます。
Queries Using Plan Cache OPS:
avg-hitは、TiDB クラスターで 1秒あたりに実行計画 キャッシュを使用するクエリの数であり、avg-missは、TiDB クラスターで 1秒あたりに実行計画 キャッシュを使用しないクエリの数です。avg-hit + avg-missはStmtExecuteに等しく、これは1秒あたりに実行される全クエリ数です。TiDBでプリペアドプランキャッシュを有効にすると、以下の3つのシナリオが発生します。- プリペアドプランキャッシュにヒットしない場合:
avg-hit(1秒あたりのヒット数)は 0 で、avg-missは 1秒あたりのStmtExecuteコマンド数に相当します。考えられる理由は次のとおりです。- アプリケーションはクエリ インターフェイスを使用しています。
- アプリケーションは
StmtExecute実行ごとにStmtCloseコマンドを呼び出すため、キャッシュされたプランはクリーンアップされます。 StmtExecuteによって実行されるすべてのステートメントはキャッシュ条件を満たさないため、実行プランキャッシュにヒットできません。
- すべてのプリペアドプランキャッシュにヒットする場合:
avg-hit(1秒あたりのヒット数)は 1秒あたりのStmtExecuteコマンド数に等しく、avg-miss(1秒あたりのヒットしない数)は 0 です。 - プリペアドプランキャッシュの一部にヒットする場合:
avg-hit(1秒あたりのヒット数)は 1秒あたりのStmtExecuteコマンド数より少ないです。プリペアドプランキャッシュには既知の制限があります。例えば、サブクエリをサポートしていないため、サブクエリを含むSQL文ではプリペアドプランキャッシュを使用できません。
- プリペアドプランキャッシュにヒットしない場合:
例1: TPC-Cワークロード
TPC-C ワークロードは主にUPDATE 、 SELECT 、 INSERT文です。合計 QPS は 1秒あたりStmtExecuteコマンドの数に等しく、後者は Queries Using Plan Cache OPS パネルでほぼavg-hitに等しくなります。理想的には、クライアントはプリペアドステートメントのオブジェクトをキャッシュします。これにより、SQL文の実行時にキャッシュされたステートメントが直接呼び出されます。すべての SQL 実行はプリペアドプランキャッシュにヒットするため、実行計画を生成するために再コンパイルする必要はありません。

例2: プリペアドプランキャッシュは読み取り専用 OLTP ワークロードのクエリ コマンドには使用できません
このワークロードでは、 Commit QPS = Rollback QPS = Select QPS 。アプリケーションは自動コミット同時実行を有効にしており、接続プールから接続がフェッチされるたびにロールバックが実行されます。その結果、これら3つの文は同じ回数実行されます。

- QPSパネルの赤い太線は失敗したクエリを表し、右側のY軸は失敗したクエリの数を示しています。0以外の値は、失敗したクエリが存在することを意味します。
- 合計 QPS は、CPS By Type パネルのクエリの数と等しく、クエリ コマンドがアプリケーションによって使用されています。
- Queries Using Plan Cache OPSパネルにはデータが表示されません。これは、クエリコマンドでプリペアドプランキャッシュが利用できないためです。つまり、TiDBはクエリ実行ごとに実行計画を解析して生成する必要があります。その結果、TiDBによるCPU消費量の増加に伴い、コンパイル時間が長くなります。
例3: OLTPワークロードに対してプリペアドステートメントが有効になっている場合、プリペアドプランキャッシュは利用できません
StmtPrepare回 = StmtExecute回 = StmtClose回 ~= StmtFetch回。アプリケーションは準備 > 実行 > フェッチ > クローズのループを使用します。プリペアドステートメントオブジェクトのリークを防ぐため、多くのアプリケーションフレームワークはexecuteフェーズの後にcloseを呼び出します。これにより、2つの問題が発生します。
- SQL 実行には 4つのコマンドと 4回のネットワーク ラウンドトリップが必要です。
- Queries Using Plan Cache OPSは0で、プリペアドプランキャッシュのヒットがゼロであることを示しています。
StmtCloseのコマンドはデフォルトでキャッシュされた実行計画をクリアし、次のStmtPrepareコマンドで実行計画を再度生成する必要があります。

例4: プリペアドステートメントにリソースリークがある
1 秒あたりStmtPrepareコマンドの数は 1秒あたりStmtCloseコマンドの数よりはるかに多く、これはアプリケーションにプリペアドステートメントのオブジェクト リークがあることを示しています。
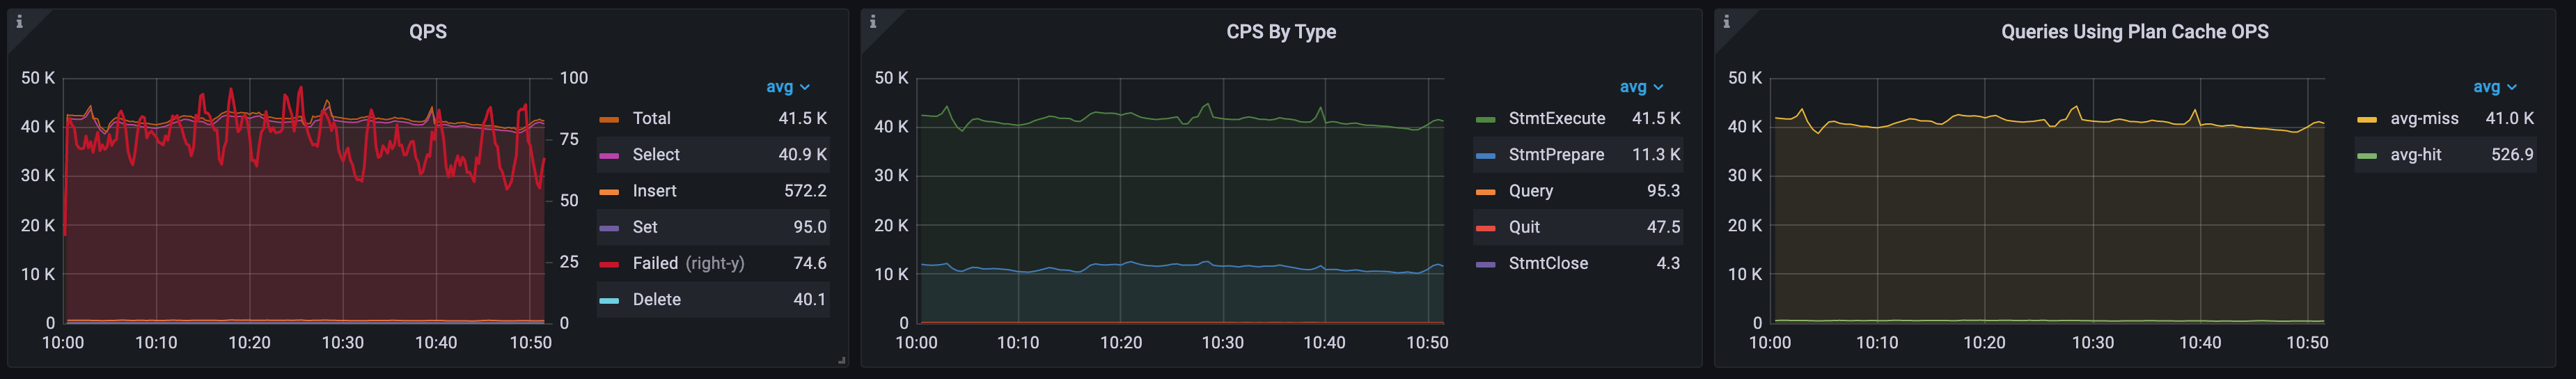
- QPSパネルでは、赤い太線が失敗したクエリの数を示し、右側のY軸がその数値の座標値を示しています。この例では、1秒あたりの失敗したクエリの数は74.6です。
- CPS By Type パネルでは、1秒あたり
StmtPrepareコマンドの数が 1秒あたりStmtCloseコマンドの数よりはるかに多く、プリペアドステートメントのアプリケーションでオブジェクト リークが発生していることを示しています。 - Queries Using Plan Cache OPS パネルでは、
avg-missが CPS By Type パネルのStmtExecuteとほぼ等しく、ほとんどすべての SQL 実行で実行計画 キャッシュが失われていることを示しています。
KV/TSO Request OPS and KV Request Time By Source
- KV/TSO Request OPSパネルでは、1秒あたりのKVおよびTSOリクエストの統計情報を確認できます。統計情報のうち、
kv request totalは TiDBからTiKVへのすべてのリクエストの合計を表します。TiDBからPDおよびTiKVへのリクエストの種類を観察することで、クラスター内のワークロードプロファイルを把握できます。 - KV Request Time By Source パネルでは、各 KV リクエストタイプとすべてのリクエストソースの時間比率を表示できます。
- kv リクエスト合計時間: 1秒あたりの KV およびTiFlashリクエストの処理時間の合計。
- 各 KV リクエストと対応するリクエストソースは積み上げ棒グラフを形成し、
externalは通常のビジネスリクエストを識別し、internalは内部アクティビティリクエスト (DDL やauto analyzeリクエストなど) を識別します。
例1: 忙しい作業負荷
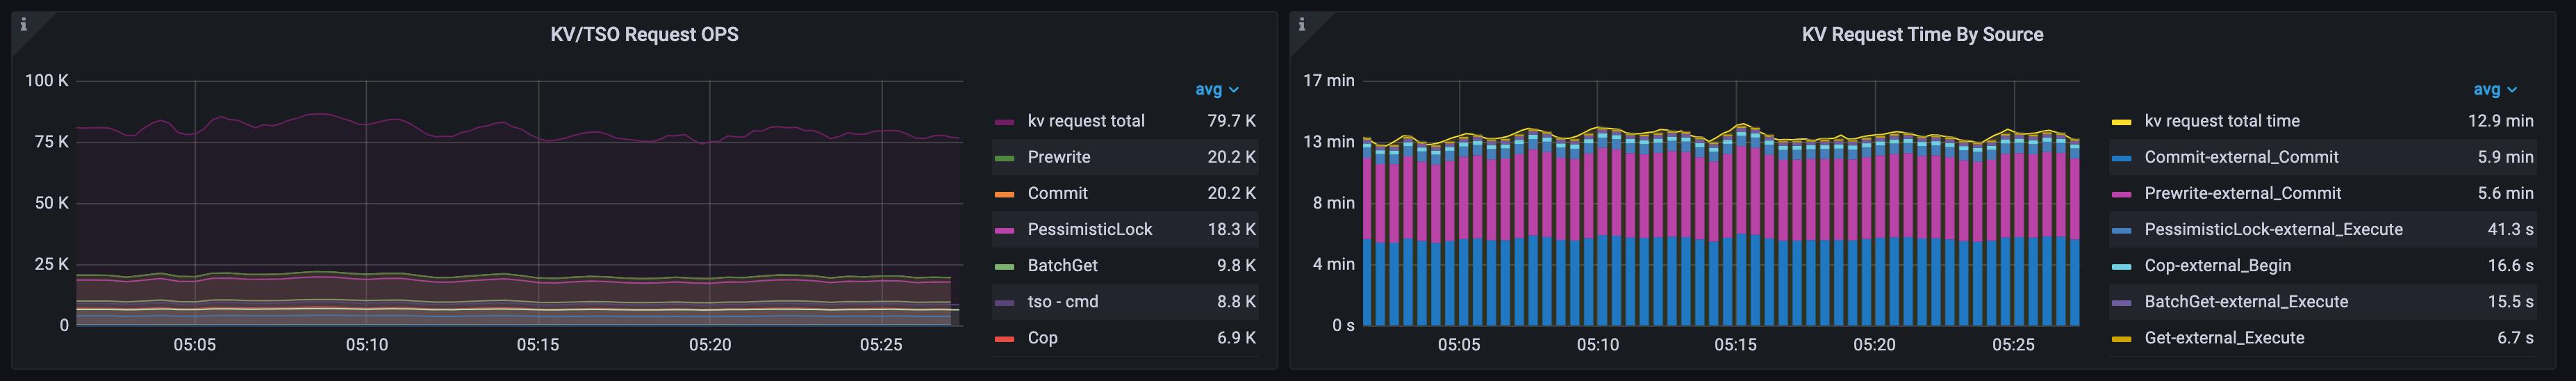
この TPC-C ワークロードでは、
- 1秒あたりのKVリクエストの総数は79,700です。リクエスト数の多い順に、リクエストタイプは
Prewrite、Commit、PessimisticLock、BatchGetです。 - KV 処理時間のほとんどは
Commit-external_CommitとPrewrite-external_Commitに費やされており、最も時間のかかる KV リクエストは外部コミット ステートメントからのCommitとPrewriteであることがわかります。
例2: ワークロードを分析する
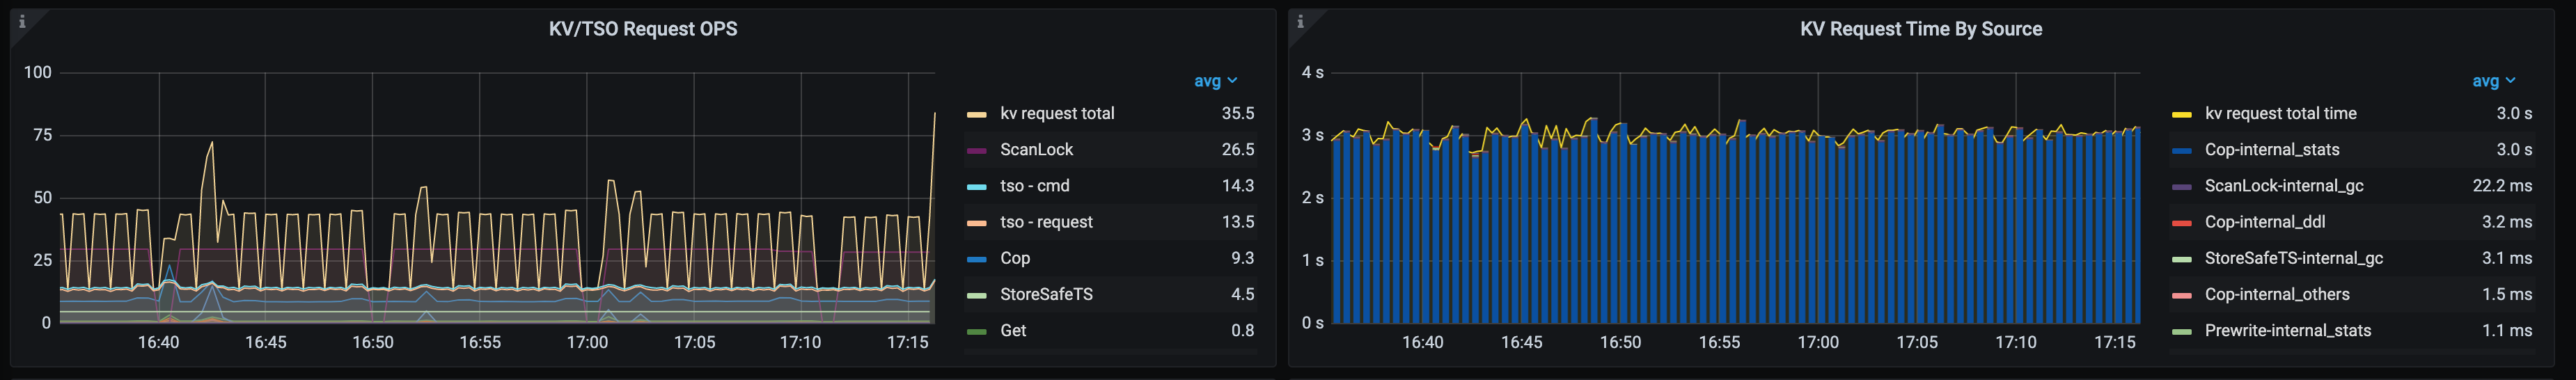
このワークロードでは、クラスター内で実行されているステートメントはANALYZEだけです。
- 1 秒あたりの KV リクエストの合計数は 35.5 で、1秒あたりの Cop リクエストの数は 9.3 です。
- KV 処理時間のほとんどは
Cop-internal_statsに費やされており、最も時間のかかる KV リクエストは内部ANALYZE操作のうちのCopであることを示しています。
CPUとメモリの使用量
TiDB、TiKV、PDのCPU/メモリパネルでは、平均CPU、最大CPU、デルタCPU(最大CPU使用率から最小CPU使用率を引いた値)、CPUクォータ、最大メモリ使用量など、それぞれの論理CPU使用率とメモリ使用量を監視できます。これらの指標に基づいて、TiDB、TiKV、PDの全体的なリソース使用状況を把握できます。
delta値に基づいて、TiDB または TiKV の CPU 使用率が不均衡かどうかを判断できます。TiDB の場合、deltaが高い場合、通常、TiDB インスタンス間のアプリケーション接続が不均衡であることを意味します。TiKV の場合、deltaが高い場合、通常、クラスター内に読み取り/書き込みのホットスポットがあることを意味します。- TiDB、TiKV、PD のリソース使用状況の概要を把握することで、クラスター内にリソースのボトルネックがあるかどうか、TiKV、TiDB、PD にスケールアウトまたはスケールアップが必要かどうかをすぐに判断できます。
例1: TiKVリソースの使用率が高い
次の TPC-C ワークロードでは、TiDB と TiKV はそれぞれ 16 個の CPU で構成されています。PD は 4 個の CPU で構成されています。
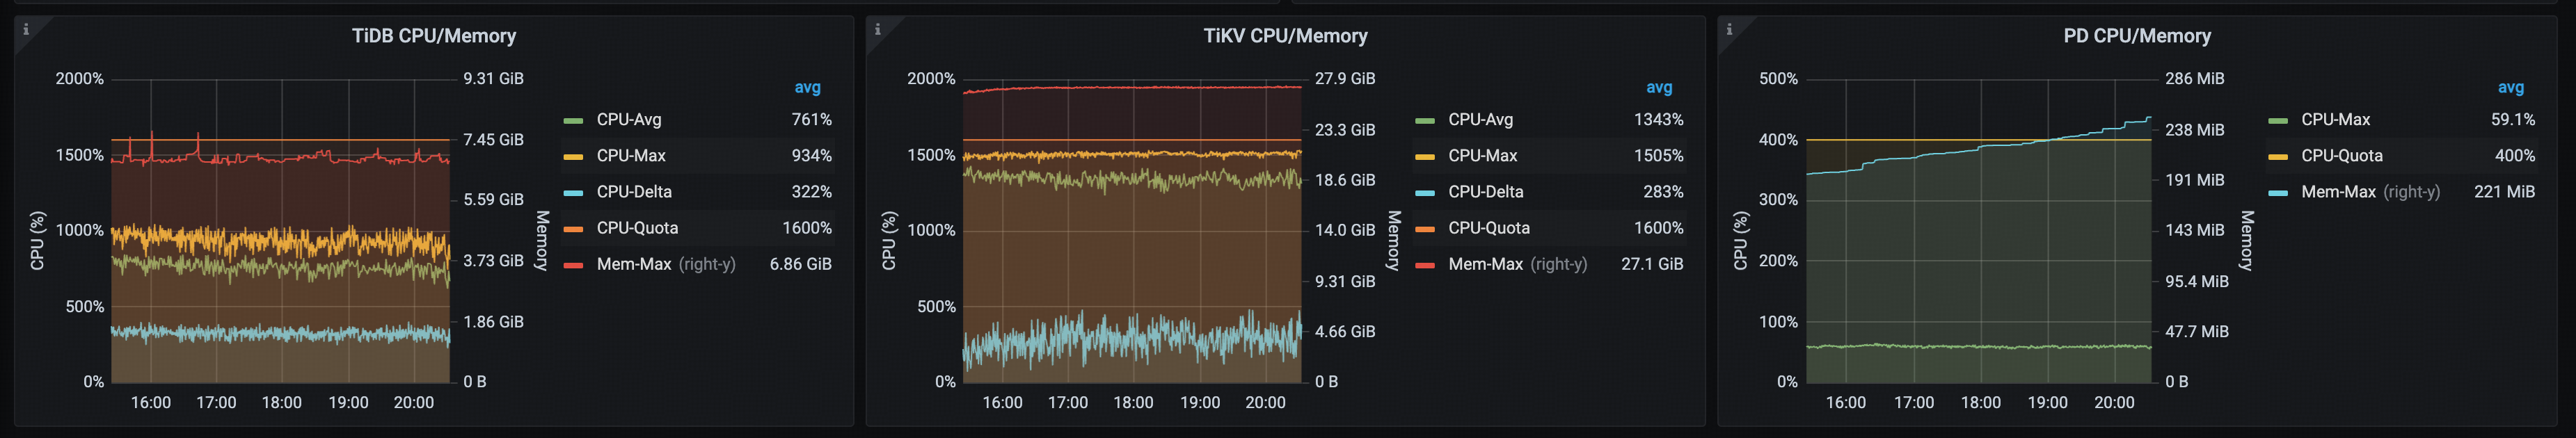
- TiDBの平均、最大、差分CPU使用率はそれぞれ761%、934%、322%です。最大メモリ使用量は6.86GiBです。
- TiKVの平均CPU使用率、最大CPU使用率、差分CPU使用率はそれぞれ1343%、1505%、283%です。最大メモリ使用量は27.1 GiBです。
- PDの最大CPU使用率は59.1%です。最大メモリ使用量は221MiBです。
当然のことながら、TiKV は CPU を多く消費します。これは、TPC-C が書き込み中心のシナリオであるため、当然のことです。パフォーマンスを向上させるには、TiKV をスケールアウトすることをお勧めします。
データトラフィック
読み取りおよび書き込みトラフィックパネルでは、TiDB クラスター内のトラフィックパターンに関する分析情報が提供され、クライアントからデータベースへのデータフローや内部コンポーネント間のデータフローを包括的に監視できます。
トラフィックを読み取る
TiDB -> Client: TiDBからクライアントへの送信トラフィック統計Rocksdb -> TiKV:ストレージレイヤー内での読み取り操作中に TiKV が RocksDB から取得するデータフロー
トラフィックを書き込む
Client -> TiDB: クライアントから TiDB への受信トラフィック統計TiDB -> TiKV: general: フォアグラウンドトランザクションが TiDB から TiKV に書き込まれる速度TiDB -> TiKV: internal: 内部トランザクションが TiDB から TiKV に書き込まれる速度TiKV -> Rocksdb: TiKVからRocksDBへの書き込み操作の流れRocksDB Compaction: RocksDBの圧縮操作によって生成される読み取りおよび書き込みI/Oフローの合計。RocksDB CompactionがTiKV -> Rocksdbよりも大幅に大きく、平均行サイズが512バイトを超える場合は、min-blob-sizeを"512B"または"1KB"に設定し、blob-file-compressionを"zstd"に設定することで、Titanによる圧縮I/Oフローを削減できます。[rocksdb.titan] enabled = true [rocksdb.defaultcf.titan] min-blob-size = "1KB" blob-file-compression = "zstd"
例1: TPC-Cワークロードの読み取りおよび書き込みトラフィック
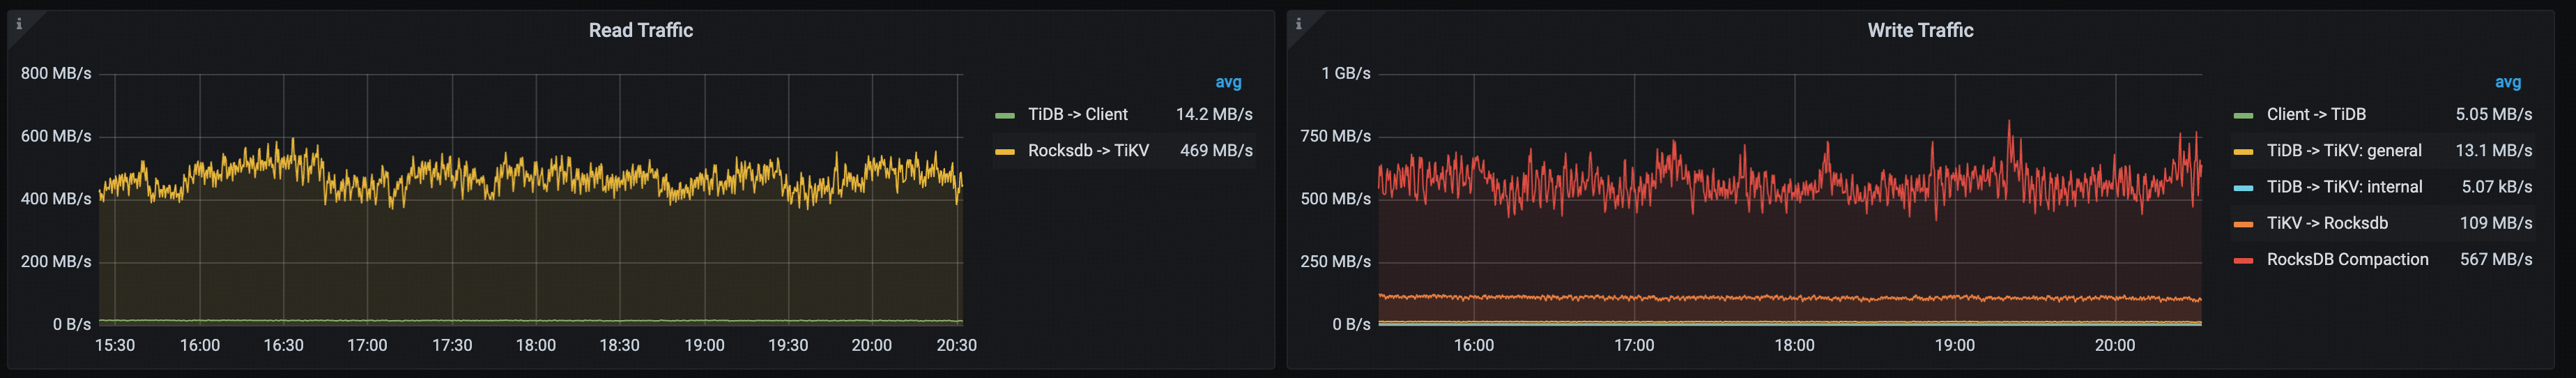
以下は、TPC-C ワークロードの読み取りおよび書き込みトラフィックの例です。
トラフィックを読み取る
TiDB -> Client: 14.2 MB/秒Rocksdb -> TiKV: 469 MB/秒。読み取り操作(SELECT文)と書き込み操作(INSERT、UPDATE、およびDELETE文)の両方で、トランザクションをコミットする前にRocksDBからTiKVにデータを読み込む必要があることに注意してください。
トラフィックを書き込む
Client -> TiDB: 5.05 MB/秒TiDB -> TiKV: general: 13.1 MB/秒TiDB -> TiKV: internal: 5.07 KB/秒TiKV -> Rocksdb: 109 MB/秒RocksDB Compaction: 567 MB/秒
例2: Titanを有効にする前と後の書き込みトラフィック
以下の例は、Titan を有効にする前後のパフォーマンスの変化を示しています。6KB のレコードの挿入ワークロードでは、Titan によって書き込みトラフィックとコンパクション I/O が大幅に削減され、TiKV の全体的なパフォーマンスとリソース使用率が向上します。
Titan を有効にする前にトラフィックを書き込む
Client -> TiDB: 510 MB/秒TiDB -> TiKV: general: 187 MB/秒TiDB -> TiKV: internal: 3.2 KB/秒TiKV -> Rocksdb: 753 MB/秒RocksDB Compaction: 10.6 GB/秒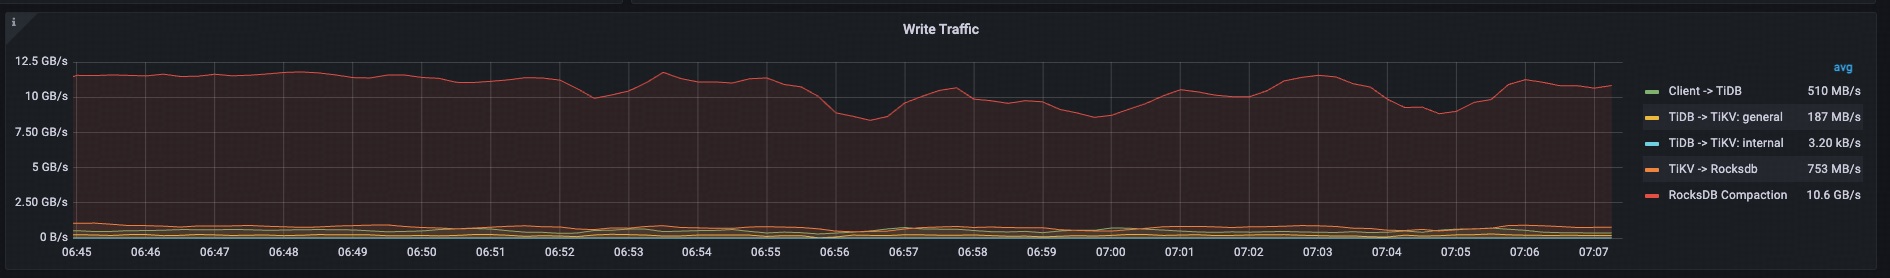
Titan が有効になった後の書き込みトラフィック
Client -> TiDB: 586 MB/秒TiDB -> TiKV: general: 295 MB/秒TiDB -> TiKV: internal: 3.66 KB/秒TiKV -> Rocksdb: 1.21 GB/秒RocksDB Compaction: 4.68 MB/秒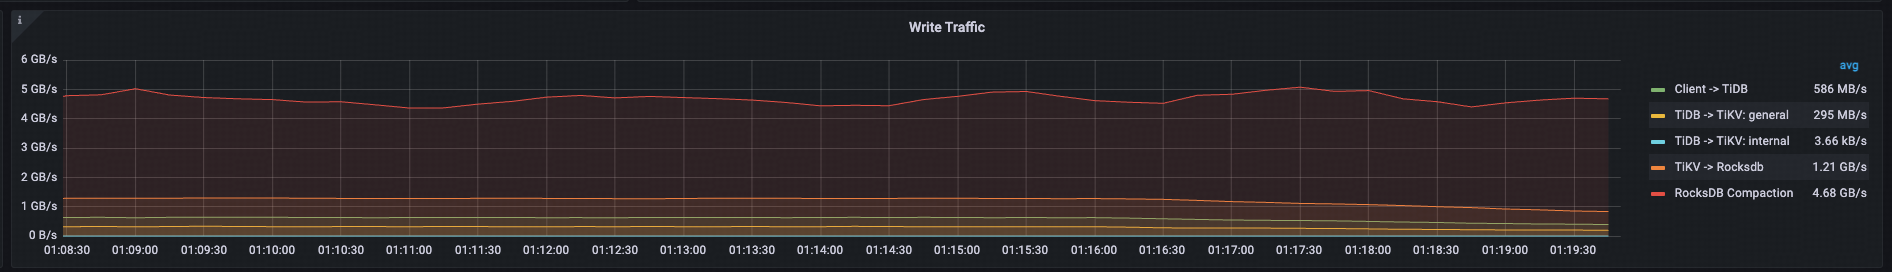
クエリレイテンシーの内訳と主要なレイテンシー指標
レイテンシーパネルには平均値と99パーセンタイルが表示されます。平均値は全体的なボトルネックの特定に役立ち、99パーセンタイル、999パーセンタイル、または999パーセンタイルは、レイテンシージッターの顕著な変化の有無を判断するのに役立ちます。
Duration, Connection Idle Duration, and Connection Count
Duration パネルには、すべてのステートメントの平均レイテンシー、および各SQLタイプの平均レイテンシーが表示されます。Connection Idle Duration パネルには、平均およびP99接続アイドル期間が表示されます。接続アイドル期間には、以下の2つの状態が含まれます。
- in-txn: 接続がトランザクション内にある場合、前の SQL を処理してから次の SQL文を受信するまでの間隔。
- not-in-txn: 接続がトランザクション内にない場合に、前の SQL を処理してから次の SQL文を受信するまでの間隔。
アプリケーションは同じデータベース接続でトランザクションを実行します。平均クエリレイテンシーと接続アイドル時間を比較することで、TiDBがシステム全体のボトルネックになっているのか、それともユーザー応答時間のジッターがTiDBによって引き起こされているのかを判断できます。
- アプリケーションワークロードが読み取り専用ではなく、トランザクションが含まれている場合は、平均クエリレイテンシーを
avg-in-txnと比較することで、データベースの内部と外部でのトランザクション処理の割合を判別し、ユーザー応答時間のボトルネックを特定できます。 - アプリケーションのワークロードが読み取り専用であるか、自動コミット モードがオンの場合は、平均クエリレイテンシーを
avg-not-in-txnと比較できます。
実際の顧客シナリオでは、ボトルネックがデータベースの外部にあることは珍しくありません。次に例を示します。
- クライアントサーバーの構成が低すぎるため、CPU リソースが使い果たされています。
- HAProxy は TiDB クラスター プロキシとして使用され、HAProxy CPU リソースが使い果たされています。
- HAProxy は TiDB クラスター プロキシとして使用され、高ワークロードでは HAProxyサーバーのネットワーク帯域幅が消費されます。
- アプリケーションサーバーからデータベースへのネットワークレイテンシーが高いです。例えば、パブリッククラウド環境では、アプリケーションとTiDBクラスタが同じリージョンに存在しない、またはDNSワークロードバランサとTiDBクラスタが同じリージョンに存在しない場合、ネットワークレイテンシーが高くなります。
- ボトルネックとなっているのはクライアントアプリケーションです。アプリケーションサーバーのCPUコアとNumaリソースを最大限に活用できていません。例えば、TiDBへの数千ものJDBC接続を確立するのに、たった1つのJVMしか使用されていません。
Connection Count パネルでは、総接続数と各TiDBノードの接続数を確認できます。これにより、総接続数が正常かどうか、また各TiDBノードの接続数が不均衡かどうかを確認できます。active connectionsはアクティブな接続数を示し、これは1秒あたりのデータベース時間に相当します。右側のY軸( disconnection/s )は、クラスター内の1秒あたりの切断数を示しており、アプリケーションが短い接続を使用しているかどうかを判断するのに役立ちます。
例1: 切断回数が多すぎる
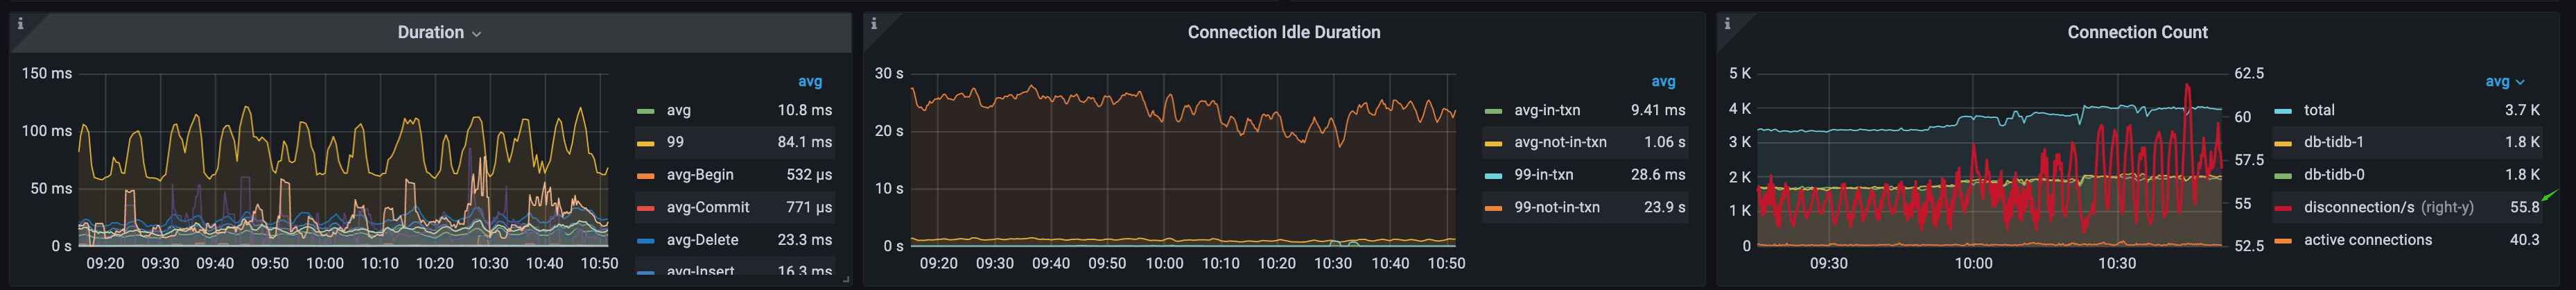
このワークロードでは、次のようになります。
- すべての SQL文の平均レイテンシーと P99レイテンシーは、それぞれ 10.8 ミリ秒と 84.1 ミリ秒です。
- トランザクション
avg-in-txnの平均接続アイドル時間は 9.4 ミリ秒です。 - クラスタへの総接続数は3,700で、各TiDBノードへの接続数は1,800です。アクティブ接続の平均数は40.3で、ほとんどの接続がアイドル状態であることを示しています。
disconnection/sの平均数は55.8で、アプリケーションが頻繁に接続と切断を繰り返していることを示しています。短い接続の動作は、TiDBのリソースと応答時間に一定の影響を与えます。
例2: TiDBがユーザー応答時間のボトルネックとなっている

この TPC-C ワークロードでは、
- すべてのSQL文の平均レイテンシーとP99レイテンシーはそれぞれ477マイクロ秒と3.13ミリ秒です。コミット文、挿入文、クエリ文の平均レイテンシーはそれぞれ2.02ミリ秒、609マイクロ秒、468マイクロ秒です。
- トランザクション
avg-in-txnの平均接続アイドル時間は 171 マイクロ秒です。
平均クエリレイテンシーはavg-in-txnよりも大幅に大きいため、トランザクションの主なボトルネックはデータベース内にあることを意味します。
例3: TiDBはユーザー応答時間のボトルネックではない

このワークロードでは、平均クエリレイテンシーは 1.69 ミリ秒、 avg-in-txnは 18 ミリ秒です。これは、TiDB がトランザクション内の SQL文を処理するために平均 1.69 ミリ秒を費やし、その後、次のステートメントを受信するために 18 ミリ秒待機する必要があることを示しています。
平均クエリレイテンシーはavg-in-txnを大幅に下回っています。ユーザー応答時間のボトルネックはTiDBではありません。この例はパブリッククラウド環境におけるもので、アプリケーションとデータベースが同じリージョンにないため、アプリケーションとデータベース間のネットワークレイテンシーが高く、接続アイドル時間が非常に長くなります。
Parse, Compile, and Execute Duration
TiDB では、クエリステートメントの送信から結果の返送までに典型的な処理フローがあります。
TiDB での SQL 処理は、 get token 、 parse 、 compile 、 execute 4つのフェーズで構成されます。
get token: 通常は数マイクロ秒程度で無視できます。トークンは、単一のTiDBインスタンスへの接続数がトークン制限上限に達した場合にのみ制限されます。parse: クエリステートメントは抽象構文ツリー (AST) に解析されます。compile: 実行計画は、parseフェーズのASTと統計情報に基づいて作成されます。compileフェーズには、論理最適化と物理最適化が含まれます。論理最適化では、リレーショナル代数に基づく列プルーニングなどのルールに従ってクエリプランを最適化します。物理最適化では、コストベースオプティマイザによって統計情報に基づいて実行計画のコストを推定し、最もコストが低い物理実行計画を選択します。execute: SQL文の実行にかかる時間。TiDBはまず、グローバルに一意なタイムスタンプTSOを待機します。 その後、エグゼキュータは実行計画内のオペレーターのキー範囲に基づいてTiKV APIリクエストを構築し、TiKVに配布します。execute時間には、TSOの待機時間、KVリクエスト時間、およびTiDBエグゼキュータによるデータ処理時間が含まれます。
アプリケーションがqueryまたはStmtExecute MySQL コマンド インターフェイスのみを使用する場合は、次の式を使用して平均レイテンシーのボトルネックを特定できます。
avg Query Duration = avg Get Token + avg Parse Duration + avg Compile Duration + avg Execute Duration
通常、 queryレイテンシーのうち、executeフェーズが大部分を占めます。ただし、以下の場合には、parseフェーズとcompileフェーズも大きな割合を占めることがあります。
parseフェーズでの長いレイテンシー: たとえば、ステートメントqueryが長い場合、SQL テキストを解析するために多くの CPU が消費されます。compileフェーズでの長いレイテンシー:プリペアドプランキャッシュにヒットしない場合、TiDBはSQL実行ごとに実行計画をコンパイルする必要があります。compileフェーズのレイテンシーは数ミリ秒から数十ミリ秒、あるいはそれ以上になる場合があります。プリペアドプランキャッシュにヒットしない場合、compileフェーズで論理的および物理的な最適化が行われ、CPUとメモリを大量に消費し、Goランタイム(TiDBはGoで記述されています)に負担がかかり、他のTiDBコンポーネントのパフォーマンスに影響を与えます。プリペアドプランキャッシュは、TiDBにおけるOLTPワークロードの効率的な処理に重要です。
例1: compileフェーズにおけるデータベースのボトルネック

上の図では、 parse 、 compile 、 executeフェーズの平均時間はそれぞれ17.1マイクロ秒、729マイクロ秒、681マイクロ秒です。compileのレイテンシーが高いのは、アプリケーションがqueryコマンドインターフェースを使用しており、プリペアドプランキャッシュを使用できないためです。
例2: executeフェーズにおけるデータベースのボトルネック

このTPC-Cワークロードでは、 parse 、 compile 、executeフェーズの平均時間はそれぞれ7.39マイクロ秒、38.1マイクロ秒、12.8ミリ秒です。executeフェーズがqueryレイテンシーのボトルネックとなっています。
KV and TSO Request Duration
TiDB はexecuteフェーズで PD および TiKV と連携します。次の図に示すように、SQL リクエストを処理する際、TiDB はparseおよびcompileフェーズに入る前に TSO をリクエストします。PD クライアントは呼び出し元をブロックせず、TSFutureを返し、バックグラウンドで非同期に TSO リクエストを送受信します。TSO リクエストの処理が完了すると、結果はただちにTSFutureに返されます。TSFutureの所有者は、最後の TSO を取得するために Wait メソッドを呼び出す必要があります。TiDB はparseおよびcompileフェーズを完了するとexecuteフェーズに入り、このフェーズでは次の2つの状況が発生する可能性があります。
- TSOリクエストが完了した場合、Waitメソッドは利用可能なTSOまたはエラーを直ちに返します。
- TSO リクエストがまだ完了していない場合、TSO が利用可能になるかエラーが表示されるまで (gRPC リクエストは送信されたが結果が返されず、ネットワークレイテンシーが高くなる)、Wait メソッドはブロックされます。
TSO待機時間はTSO WAITと記録され、TSOリクエストのネットワーク時間はTSO RPCと記録されます。TSO待機が完了すると、TiDBエグゼキューターは通常、TiKVに読み取りまたは書き込みリクエストを送信します。
- 一般的な KV 読み取りリクエスト:
Get、BatchGetおよびCop - 一般的な KV 書き込みリクエスト: 2フェーズコミットの
PessimisticLock、PrewriteおよびCommit

このセクションのインジケーターは、次の3つのパネルに対応しています。
- Avg TiDB KV Request Duration: TiDB によって測定された KV リクエストの平均レイテンシー
- Avg TiKV GRPC Duration: TiKV での gRPC メッセージの処理にかかる平均レイテンシー
- PD TSO Wait/RPC Duration: TiDB エグゼキュータの TSO 待機時間と TSO リクエスト (RPC) のネットワークレイテンシー
Avg TiDB KV Request DurationとAvg TiKV GRPC Durationの関係は以下のとおりです。
Avg TiDB KV Request Duration = Avg TiKV GRPC Duration + Network latency between TiDB and TiKV + TiKV gRPC processing time + TiDB gRPC processing time and scheduling latency
Avg TiDB KV Request DurationとAvg TiKV GRPC Durationの違いは、ネットワークトラフィック、ネットワークレイテンシー、および TiDB と TiKV によるリソース使用量に密接に関係しています。
- 同じデータセンター内: 差は通常 2 ミリ秒未満です。
- 同じリージョン内の異なるアベイラビリティゾーンの場合: 差は通常 5 ミリ秒未満です。
例1: 同じデータセンターにデプロイされたクラスタのワークロードが低い

このワークロードでは、TiDBの平均Prewriteレイテンシーは925マイクロ秒、TiKV内の平均kv_prewrite処理レイテンシーは720マイクロ秒でした。この差は約200マイクロ秒で、これは同じデータセンターでは一般的な値です。TSOの平均待機レイテンシーは206マイクロ秒、RPC時間は144マイクロ秒でした。
例2: パブリッククラウドクラスタ上の通常のワークロード

この例では、TiDBクラスタは同じリージョン内の異なるデータセンターにデプロイされています。TiDBの平均commitレイテンシーは12.7ミリ秒、TiKV内の平均kv_commit処理レイテンシーは10.2ミリ秒で、約2.5ミリ秒の差があります。平均TSO待機レイテンシーは3.12ミリ秒、RPC時間は693マイクロ秒です。
例3: パブリッククラウドクラスタのリソース過負荷

この例では、TiDBクラスタは同一リージョン内の異なるデータセンターにデプロイされており、TiDBネットワークとCPUリソースが深刻な過負荷状態にあります。TiDBの平均BatchGetレイテンシーは38.6ms、TiKV内部の平均kv_batch_get処理レイテンシーは6.15msです。その差は32ms以上で、正常値を大幅に上回っています。平均TSO待機レイテンシーは9.45ms、RPC時間は14.3msです。
Storage Async Write Duration, Store Duration, and Apply Duration
TiKV は次の手順で書き込みリクエストを処理します。
scheduler workerは書き込みリクエストを処理し、トランザクションの一貫性チェックを実行し、書き込みリクエストをraftstoreモジュールに送信するキーと値のペアに変換します。TiKV コンセンサス モジュール
raftstoreは、 Raftコンセンサス アルゴリズムを適用して、ストレージレイヤー(複数の TiKV で構成) をフォールト トレラントにします。Raftstore は
StoreスレッドとApplyスレッドで構成されています。StoreスレッドはRaftメッセージと新しいproposalsを処理します。新しいproposalsを受信すると、リーダーノードのStoreスレッドはローカルRaft DBに書き込み、メッセージを複数のフォロワーノードにコピーします。ほとんどのインスタンスでこのproposalsが正常に永続化されると、proposalsが正常にコミットされます。ApplyスレッドはコミットされたproposalsデータをKV DBに書き込みます。データがKV DBに正常に書き込まれると、Applyスレッドは書き込みリクエストが完了したことを外部に通知します。

Storage Async Write Durationのメトリックは、書き込みリクエストがraftstoreに入った後のレイテンシーを記録します。データはリクエストごとに収集されます。
Storage Async Write DurationメトリックはStore DurationとApply Durationの2つの部分で構成されます。次の式を使用して、書き込みリクエストのボトルネックがStoreまたはApplyのどちらのステップにあるかを判断できます。
avg Storage Async Write Duration = avg Store Duration + avg Apply Duration
例1: v5.3.0とv5.4.0での同じOLTPワークロードの比較
前述の式によると、書き込みが多い OLTP ワークロードの QPS は、v5.4.0 では v5.3.0 よりも 14% 高くなります。
- v5.3.0: 24.4 ミリ秒 ~= 17.7 ミリ秒 + 6.59 ミリ秒
- v5.4.0: 21.4 ミリ秒 ~= 14.0 ミリ秒 + 7.33 ミリ秒
v5.4.0 では、gRPC モジュールが最適化され、 Raftログのレプリケーションが高速化され、v5.3.0 と比較してStore Durationが削減されました。
バージョン5.3.0:

バージョン5.4.0:

例2: Store Duration がボトルネック
上記の式を適用します:10.1 ms ~= 9.81 ms + 0.304 ms。この結果は、書き込みリクエストのレイテンシーのボトルネックがStore Durationにあることを示しています。

Commit Log Duration, Append Log Duration, and Apply Log Duration
Commit Log Duration、 Append Log Duration、 Apply Log Durationは、raftstore内の主要な操作のレイテンシー指標です。これらのレイテンシーはバッチ操作レベルで計測され、各操作は複数の書き込みリクエストを組み合わせます。したがって、これらのレイテンシーは前述のStore DurationとApply Durationに直接対応するものではありません。
Commit Log DurationとAppend Log Durationは 、Storeスレッドで実行された操作時間を記録します。Commit Log Durationは、 Raftログを他の TiKV ノードにコピーする時間が含まれます (raft-log の永続性を確保するため)。Commit Log Durationは通常、リーダー用とフォロワー用の 2つのAppend Log Duration操作が含まれます。Commit Log Durationは、通常、Append Log Durationよりも大幅に大きくなります。これは、前者には、ネットワークを介してRaftログを他の TiKV ノードにコピーする時間が含まれるためです。Apply Log Durationは、ApplyスレッドによるRaftログの適用レイテンシーを記録します。
Commit Log Durationが長い場合の一般的なシナリオ:
- TiKV CPUリソースにボトルネックがあり、スケジューリングのレイテンシーが高い
raftstore.store-pool-sizeは小さすぎるか大きすぎるかのいずれかです(大きすぎる値はパフォーマンスの低下を引き起こす可能性もあります)- I/Oレイテンシーが高く、結果として
Append Log Durationレイテンシーが高くなります。 - TiKVノード間のネットワークレイテンシーは高い
- gRPC スレッドの数が少なすぎるため、CPU 使用率が gRPC スレッド間で不均一になります。
Apply Log Durationが長い場合の一般的なシナリオ:
- TiKV CPUリソースにボトルネックがあり、スケジューリングのレイテンシーが高い
raftstore.apply-pool-sizeは小さすぎるか大きすぎるかのいずれかです(大きすぎる値はパフォーマンスの低下を引き起こす可能性もあります)- I/Oレイテンシーが高い
例1: v5.3.0とv5.4.0での同じOLTPワークロードの比較
v5.4.0では、書き込み中心のOLTPワークロードのQPSがv5.3.0と比較して14%向上しました。次の表は、3つの主要なレイテンシーを比較したものです。
v5.4.0 では、gRPC モジュールが最適化され、 Raftログのレプリケーションが高速化され、v5.3.0 と比較してCommit Log DurationとStore Durationが削減されました。
バージョン5.3.0:

バージョン5.4.0:

例2: Commit Log Duration がボトルネック

- 平均
Append Log Duration= 4.38ミリ秒 - 平均
Commit Log Duration= 7.92ミリ秒 - 平均
Apply Log Duration= 172 us
スレッドStoreの場合、 Commit Log DurationはApply Log Durationよりも明らかに高い値です。一方、 Append Log DurationはApply Log Durationよりも大幅に高い値であり、スレッドStoreはCPUとI/Oの両方でボトルネックが発生している可能性があることを示しています。Commit Log DurationとAppend Log Durationを削減する方法としては、以下のものが考えられます。
- TiKV CPU リソースが十分な場合は、
raftstore.store-pool-sizeの値を増やしてStoreスレッドを追加することを検討してください。 - TiDBがv5.4.0以降の場合は、
raft-engine.enable: trueを設定してRaft Engineを有効にすることを検討してください。Raft Engineは軽量な実行パスを備えています。これにより、I/O書き込みの削減と、一部のシナリオにおける書き込みのロングテールレイテンシーの削減に役立ちます。 - TiKV CPU リソースが十分で、TiDB が v5.3.0 以降の場合は、
raftstore.store-io-pool-size: 1を設定してStoreWriterを有効にすることを検討してください。
TiDB のバージョンが v6.1.0 より前の場合、パフォーマンス概要ダッシュボードを使用するにはどうすればよいですか?
Grafana v6.1.0以降、デフォルトでパフォーマンス概要ダッシュボードが組み込まれています。このダッシュボードはTiDB v4.xおよびv5.xバージョンと互換性があります。TiDBがv6.1.0より前の場合は、次の図に示すように、 performance_overview.jsonを手動でインポートする必要があります。
